Una IA que no sabe leer, pero que es muy buena hablando
Conversar con la IA mediante la voz no es nada nuevo, pero la lógica subyacente de la mayoría de los asistentes de voz del mercado consiste en realidad en "leer un guion": primero, convertir lo que la gente dice en texto; luego, dejar que un modelo de texto extenso lo procese; y finalmente, leerlo en voz alta utilizando tecnología de síntesis de voz.
Dessa, un modelo de voz desarrollado por el antiguo cofundador de Twitter, prescinde por completo del texto e intenta demostrar que el conocimiento y las capacidades conversacionales de una máquina pueden surgir directamente del sonido mismo.
«Dado que los bebés humanos aprenden a hablar antes de leer, ¿por qué las máquinas no podrían seguir el mismo camino?». Con esta convicción, Jack Dorsey creó un laboratorio de IA. Jack Dorsey es uno de los fundadores de X (antes Twitter) y actualmente es propietario de Block, una empresa cuyo negocio principal son los productos de pago financiero como Square y Cash App. Dessa es el equipo de investigación de Block, dedicado exclusivamente a la investigación en IA y que reporta directamente al fundador Jack Dorsey.
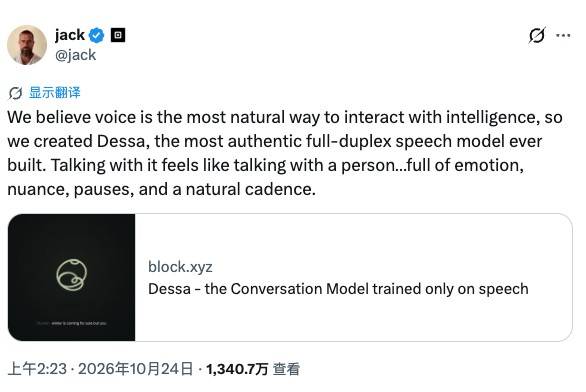
Se eliminó el texto del proceso de entrenamiento porque, naturalmente, filtra mucha información. El texto convierte una oración en una cadena estática de caracteres, mientras que el sonido es diferente cada vez que se escucha. El equipo de Block afirmó que Dessa, que creció completamente inmersa en el sonido, no solo puede escuchar y hablar al mismo tiempo, intervenir con naturalidad y dar afirmaciones como "eh" y "sí" en cualquier momento, sino que incluso puede ejecutarse localmente en una MacBook Pro equipada con un chip M4 Max.
Debido a que los detalles del entrenamiento y el tamaño del modelo no se han revelado, resulta difícil para los ajenos al tema evaluar el límite superior de este enfoque técnico, pero sí apunta a una vía "no convencional" que ha quedado eclipsada durante mucho tiempo por los grandes modelos de texto: de voz a voz.
Puede hablar y, además, puede contestar el teléfono.
Si bien Dessa representaba una exploración pura de la esencia del habla en el laboratorio, al mismo tiempo, otro enfoque pragmático de los modelos del habla se estaba incorporando rápidamente a los flujos de trabajo cotidianos.
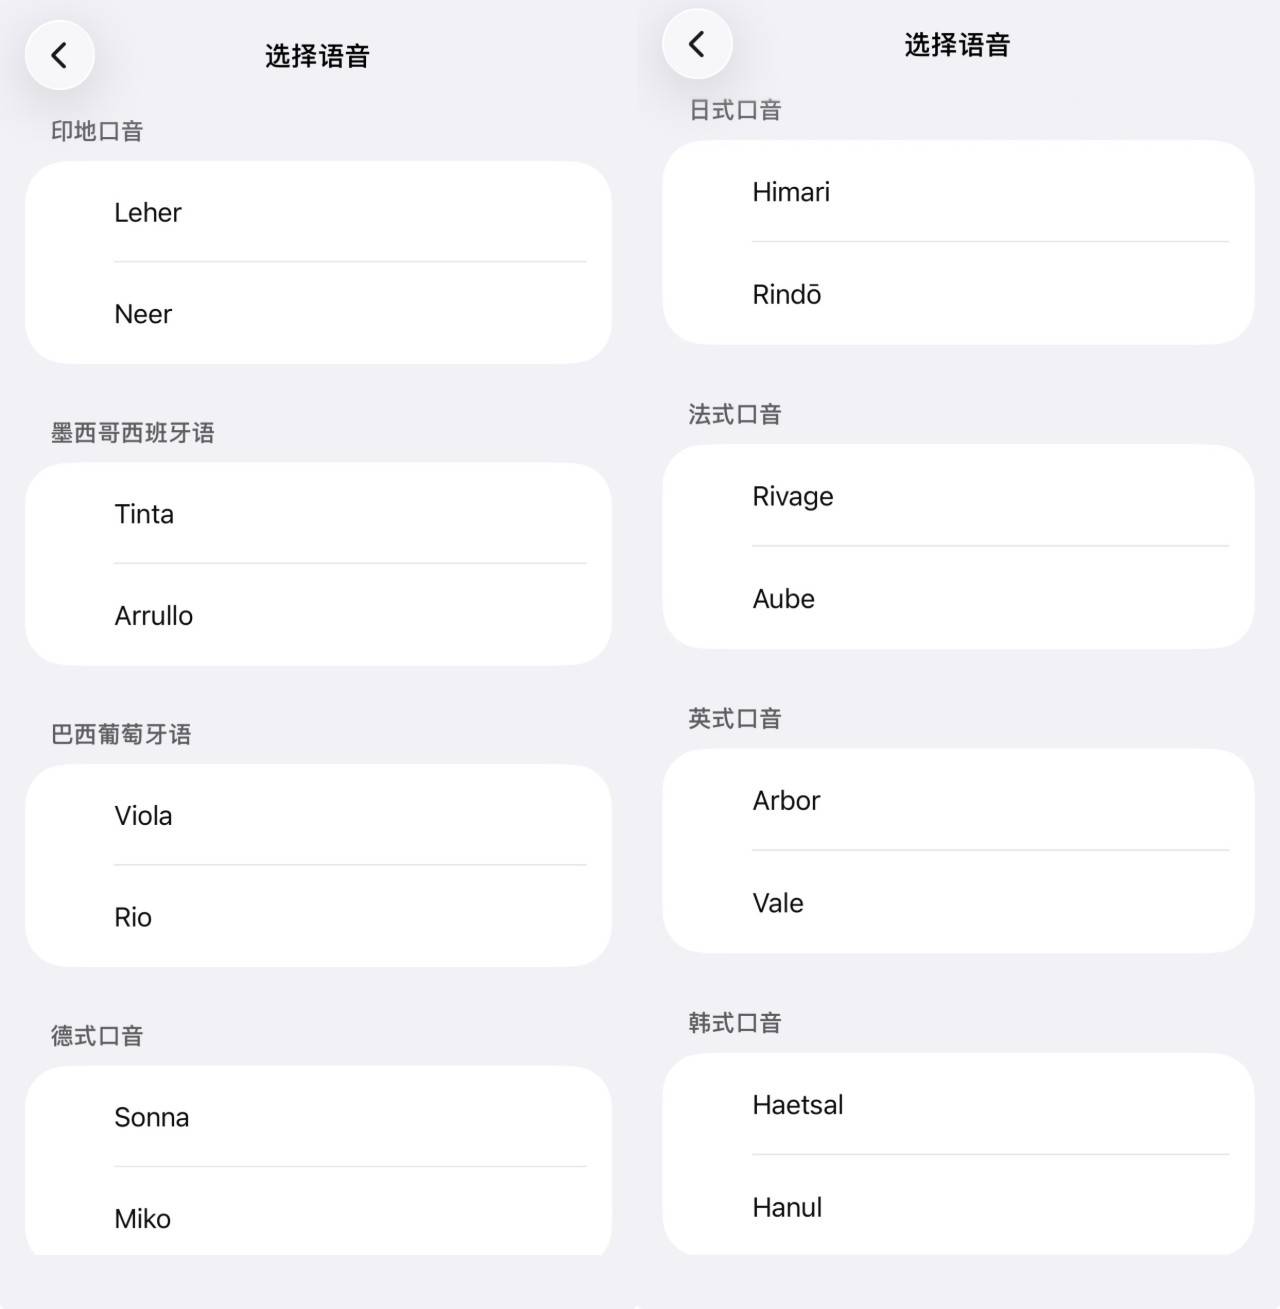
A mediados de octubre, OpenAI actualizó su modelo de voz GPT-Live, mejorando no solo la naturalidad de los acentos multilingües en el cliente ChatGPT , sino también añadiendo nueve nuevas voces, incluyendo acentos japoneses, coreanos e ingleses, a la API para desarrolladores, y permitiendo la personalización de las voces mediante su descripción directa con texto.
Casi simultáneamente, xAI también lanzó Grok Voice 3.0, que también se centra en la interacción de voz de extremo a extremo en tiempo real (de voz a voz).
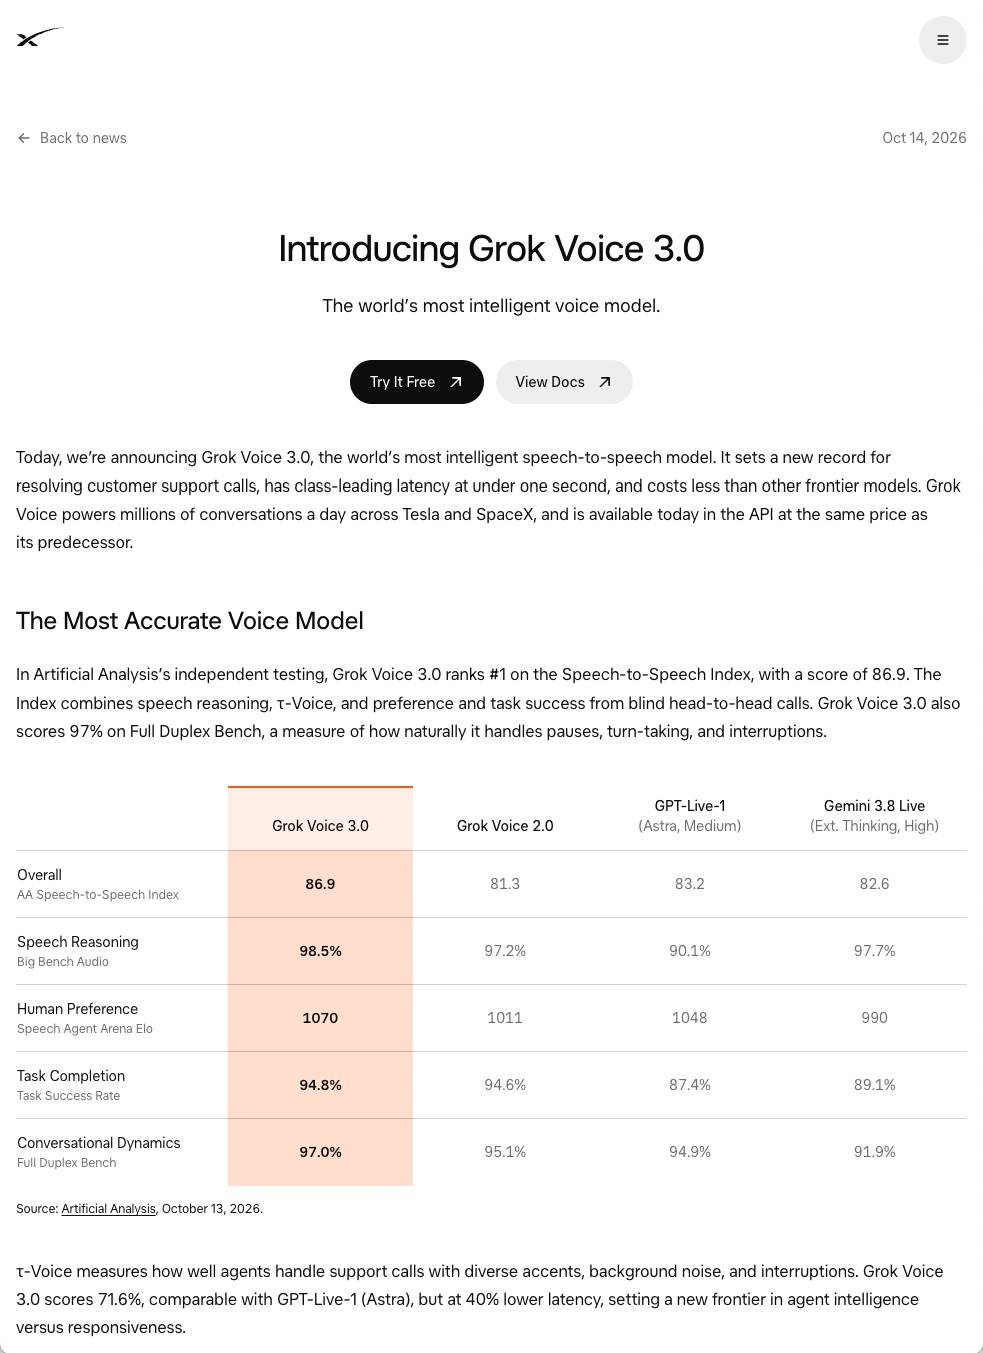
A diferencia del enfoque de entrenamiento obsesivo-compulsivo de Dessa, que "evita por completo el texto", los modelos comerciales convencionales, representados por Grok, se preocupan más por combinar la base de razonamiento textual de los modelos grandes con las capacidades del habla nativa, de modo que la voz pueda utilizarse realmente.
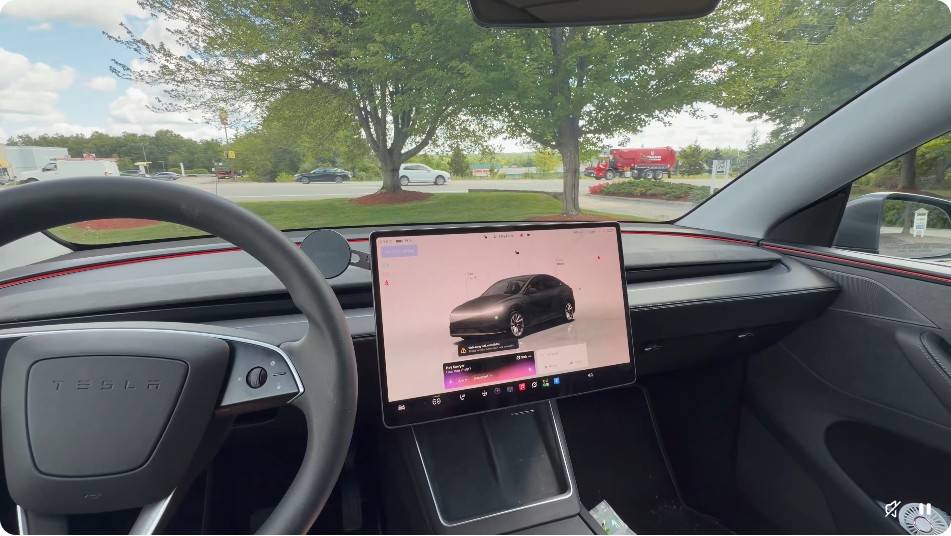
Tomando como ejemplo a Tesla, los propietarios de automóviles pueden hablar con Grok directamente a través del sistema de infoentretenimiento del coche sin tener que abrir sus teléfonos o aplicaciones por separado.
Curiosamente, la evolución de estos modelos de habla convencionales gira en torno a un lapso de tiempo extremadamente sutil: medio segundo.
Al escribir en un teclado, esperar medio segundo adicional prácticamente no afecta el desarrollo de la conversación; sin embargo, por teléfono, un silencio de medio segundo basta para desviar completamente la conversación hacia el extremo opuesto. Por eso, incluso si la respuesta de la IA es impecable, si espera rígidamente a que el interlocutor termine de hablar antes de interrumpir, se ríe en momentos inoportunos o lee obstinadamente todo el guion tras ser interrumpido, el usuario perderá la inmersión al instante. En la reseña de Grok Voice 3.0, medio segundo fue su objetivo de optimización.
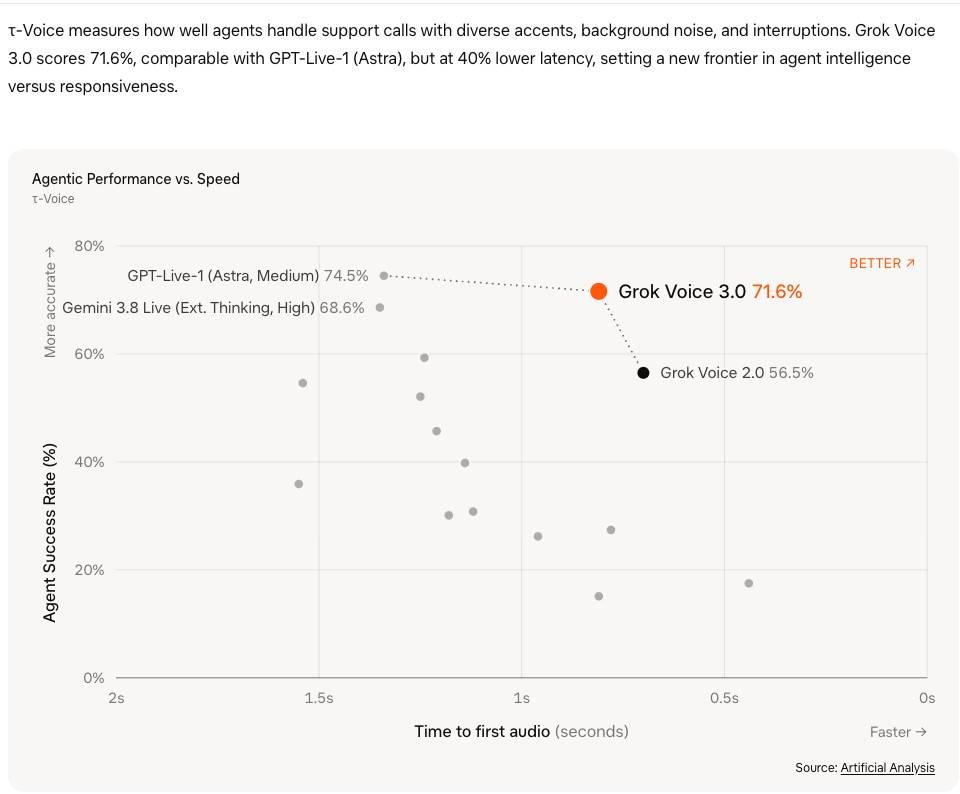
Las diferencias de milisegundos pueden tener un impacto directo en las aplicaciones comerciales prácticas. Actualmente, los espacios dentro de los vehículos y las líneas de atención al cliente constituyen los escenarios de aplicación más efectivos para la IA de voz. Según datos operativos internos divulgados por xAI, además de gestionar un gran número de conversaciones diarias dentro de los vehículos Tesla, este sistema de voz también gestiona aproximadamente 20 000 llamadas de atención al cliente de Starlink cada día, y cerca del 70 % de los problemas se resuelven sin necesidad de ser transferidos a un operador humano.
Más allá de la velocidad, el modelo debe ser capaz de comprender claramente la solicitud de la persona que llama, incluso con acentos, ruido de fondo e interrupciones frecuentes; debe poder recuperar información, acceder a herramientas y gestionar fallos en segundo plano sin problemas; y, por último, debe colgar el teléfono de forma cortés. Todas estas operaciones deben completarse a la perfección, junto con una voz natural, para que realmente pueda considerarse "en servicio".
¿Por qué el sonido de una película de ciencia ficción no es la interfaz principal del ordenador?
La fascinación de la humanidad por los ordenadores activados por voz viene de lejos. Ya en Blade Runner, el protagonista Deckard daba órdenes a un analizador de imágenes, haciendo que la imagen se desplazara y se acercara hasta que localizaba pistas ocultas.
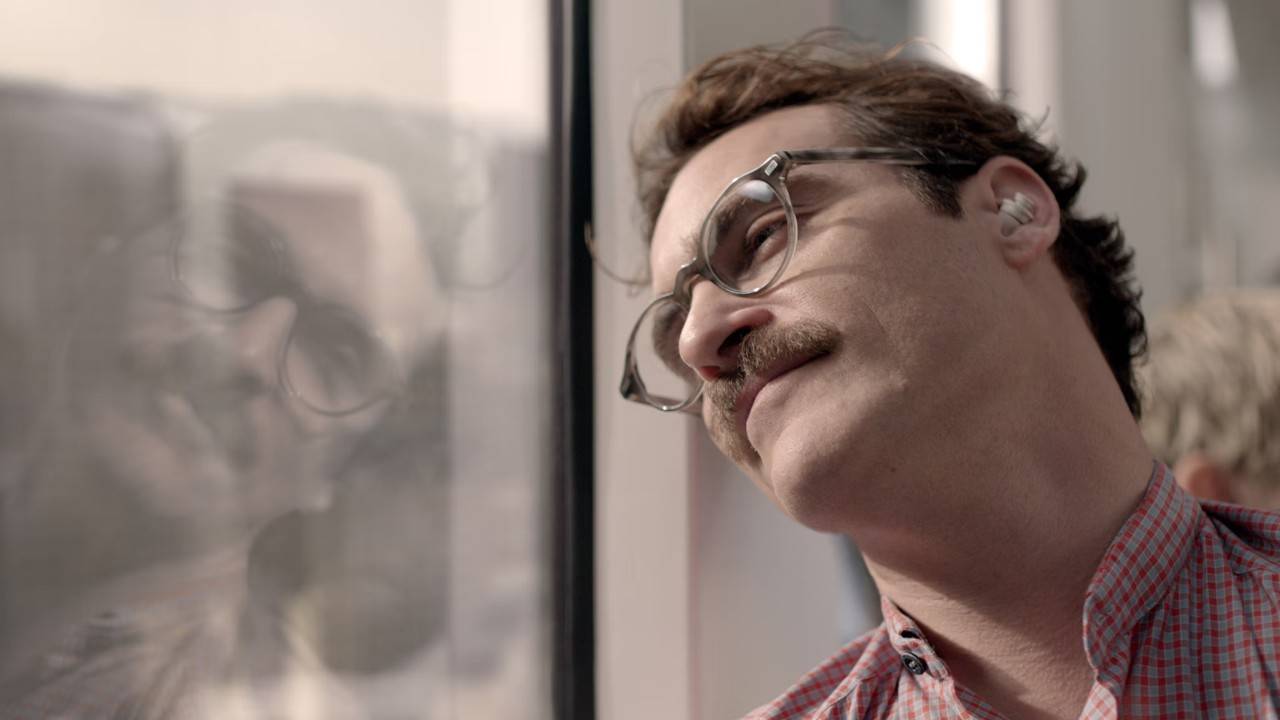
En *Her*, el sistema operativo Samantha va un paso más allá, transformándose de una máquina que ejecuta instrucciones en una compañera constante y alma gemela. No solo puede completar todas las tareas diarias, sino que su voz es increíblemente expresiva, lo que le permite desarrollar una relación romántica con el protagonista masculino.
La evolución de la tecnología ha materializado la visión original. En sus inicios, los asistentes de voz de los teléfonos móviles solo podían ejecutar comandos sencillos con estructuras de frases fijas, como configurar alarmas y consultar el tiempo. Tras la llegada de los altavoces inteligentes a los hogares, sus funciones más comunes se redujeron a reproducir música y configurar temporizadores. No fue hasta que se combinaron modelos de lenguaje complejos con agentes de voz que las máquinas comprendieron realmente el lenguaje hablado fluido y comenzaron a ayudar a los usuarios a enviar y recibir mensajes de texto, hacer reservas en restaurantes y utilizar herramientas de programación para modificar el código a partir de las descripciones verbales de los desarrolladores.
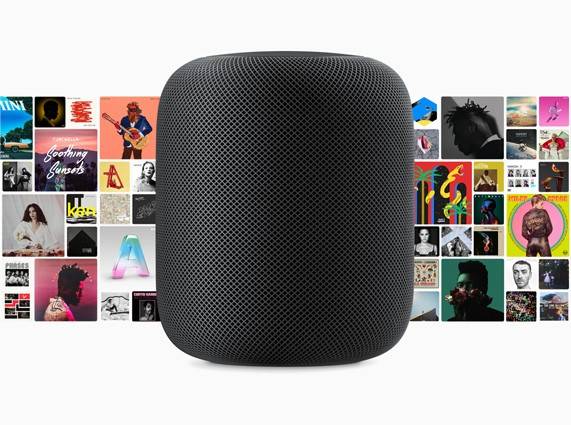
▲ Apple HomePod
Sin embargo, aunque la IA de voz puede realizar tareas mucho más complejas que "encender la luz", las pantallas siempre tendrán un lugar en nuestras vidas. El uso de la voz no puede reemplazar el tecleo ni el clic del ratón.
Esto no se debe a que el modelo no sea lo suficientemente inteligente, sino a que está limitado por las propiedades físicas del sonido como medio de información.
El sonido es lineal, lo que lo hace especialmente adecuado para transmitir intenciones vagas en la planificación de IA. Algunos ejemplos incluyen ideas de programación y la instrucción a agentes para que realicen tareas.
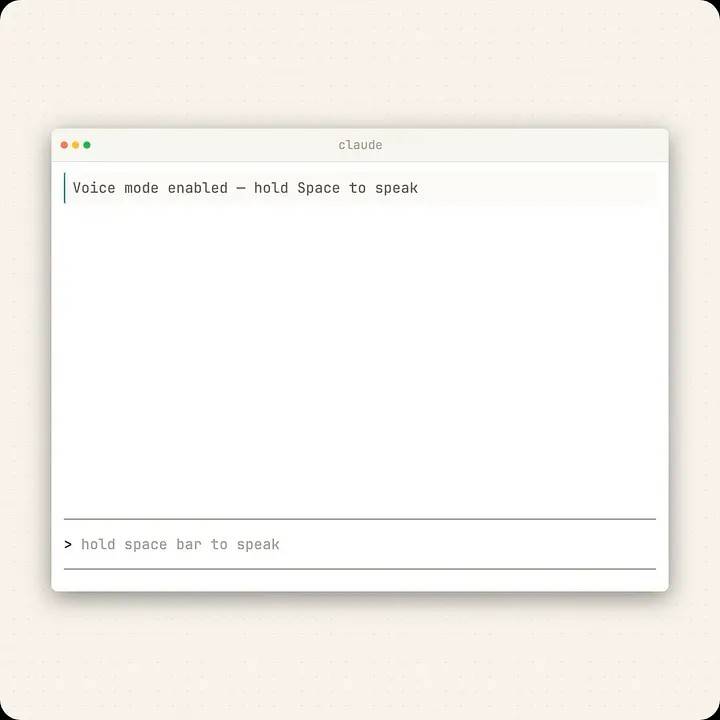
▲ Modo de voz de Claude Code
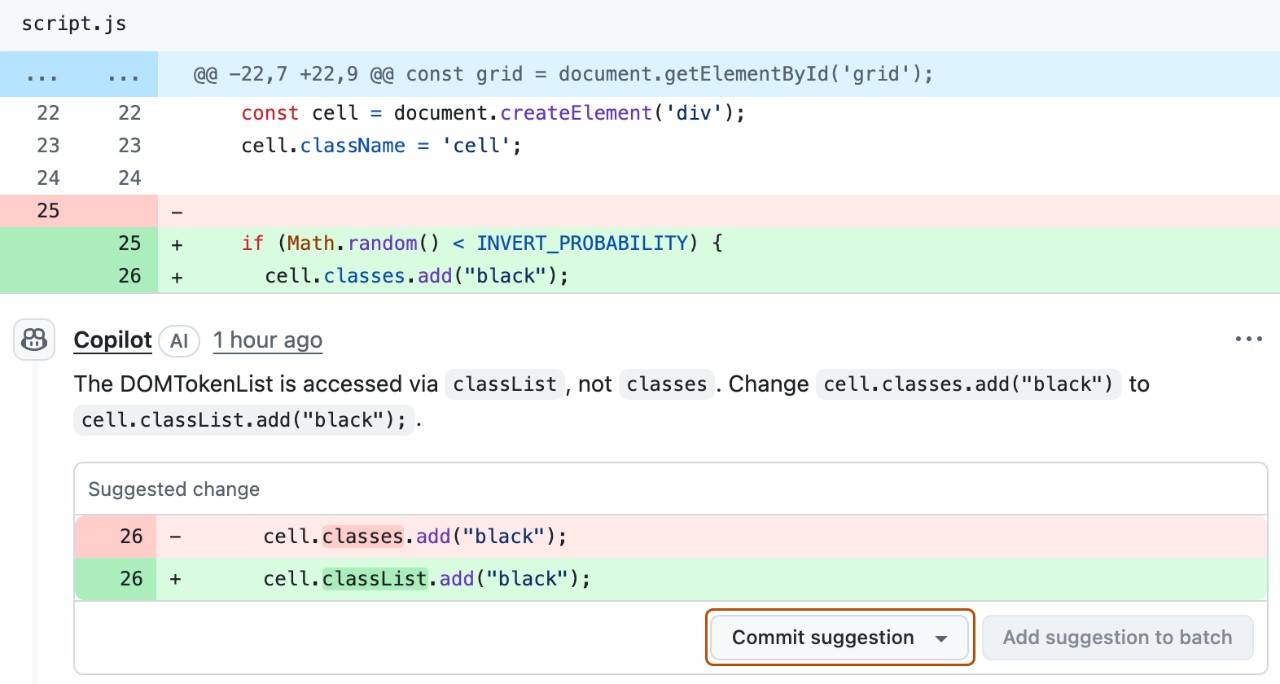
Sin embargo, en un entorno laboral o de producción, no es ideal para que las personas revisen varias opciones paralelas simultáneamente. Al escribir artículos, necesitamos ver la estructura del párrafo de un vistazo y poder retroceder y hacer cambios en cualquier momento; al escribir código, debemos mirar fijamente la pantalla para comparar las diferencias de código con los resultados de la ejecución.
Incluso al reservar un vuelo, tener los precios, los horarios de salida y llegada, y las políticas de reembolso y cambio de varios vuelos mostrados en la pantalla de un vistazo es mucho más eficiente que tener que escuchar a un asistente de voz leerlos uno por uno.
Cuanto mayor sea la capacidad de la IA para realizar tareas en nombre de los humanos, mayor será la necesidad de estos últimos de contar con una interfaz visual que les permita verificar lo que han hecho, detenerse y revertir sus acciones anteriores antes de que se produzcan errores.
El entorno físico y las normas sociales delimitan sutilmente las posibilidades del habla. Al conducir, cocinar o cuidar a un niño, con la vista y el cuerpo ocupados, hablar es sin duda la solución más sencilla; sin embargo, en una oficina diáfana y tranquila, sigue resultando extraño que una persona hable continuamente frente a un ordenador. Que toda la oficina hable a la vez recuerda a un gran centro de atención telefónica.
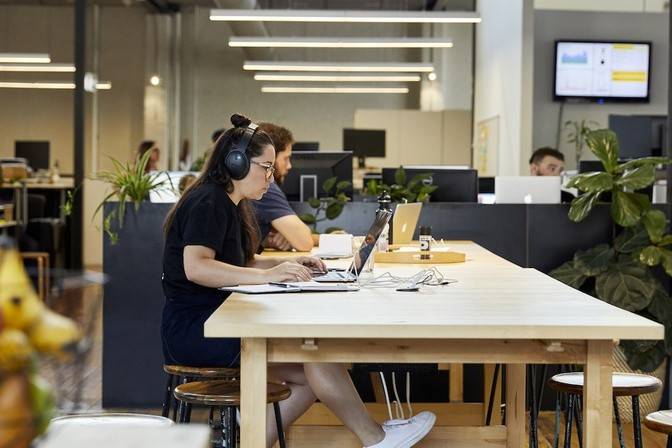
Estos escenarios implican limitaciones en el ancho de banda de la información y en los límites de la privacidad, que los ingenieros no pueden resolver por mucho que reduzcan la latencia del modelo en milisegundos.
La profecía de las películas de ciencia ficción que dice que "basta con decirle una palabra al ordenador para que todo se resuelva" se está haciendo realidad poco a poco. Sin embargo, cuanto más aprenden las máquinas a hablar como los humanos, más conscientes nos volvemos de cuándo es apropiado hablar y cuándo debemos guardar silencio.