Primeras impresiones del portátil NVIDIA RTX Spark: logré liberarme del límite de crédito de WorkBuddy
Acaba de salir a la venta el primer lote de portátiles Windows equipados con chips NVIDIA RTX Spark Super.
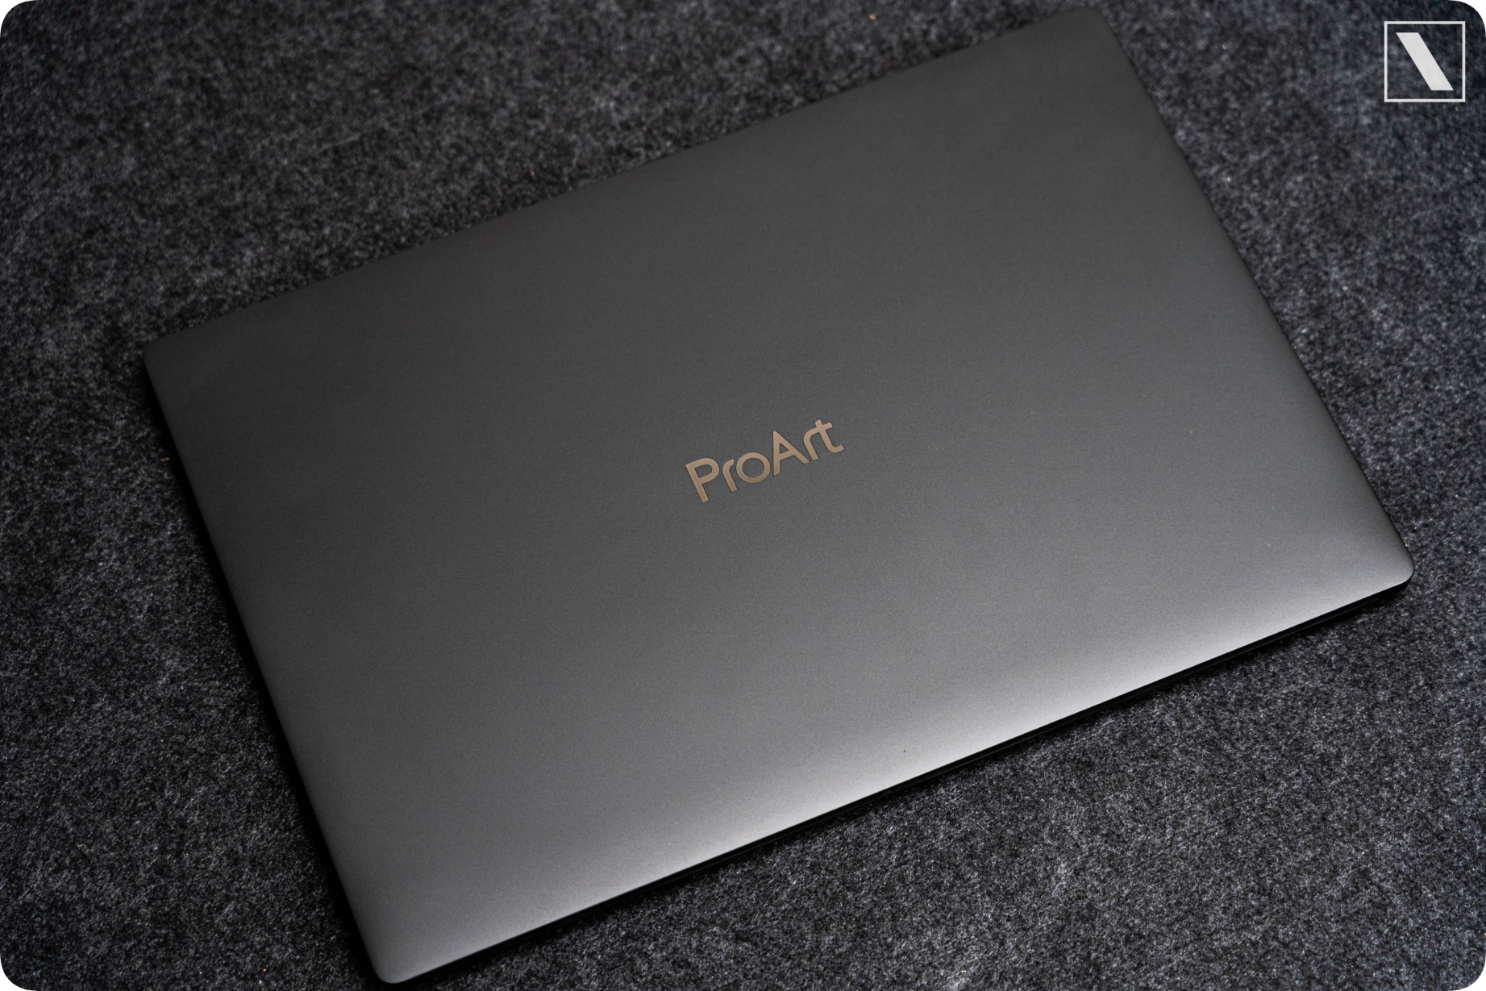
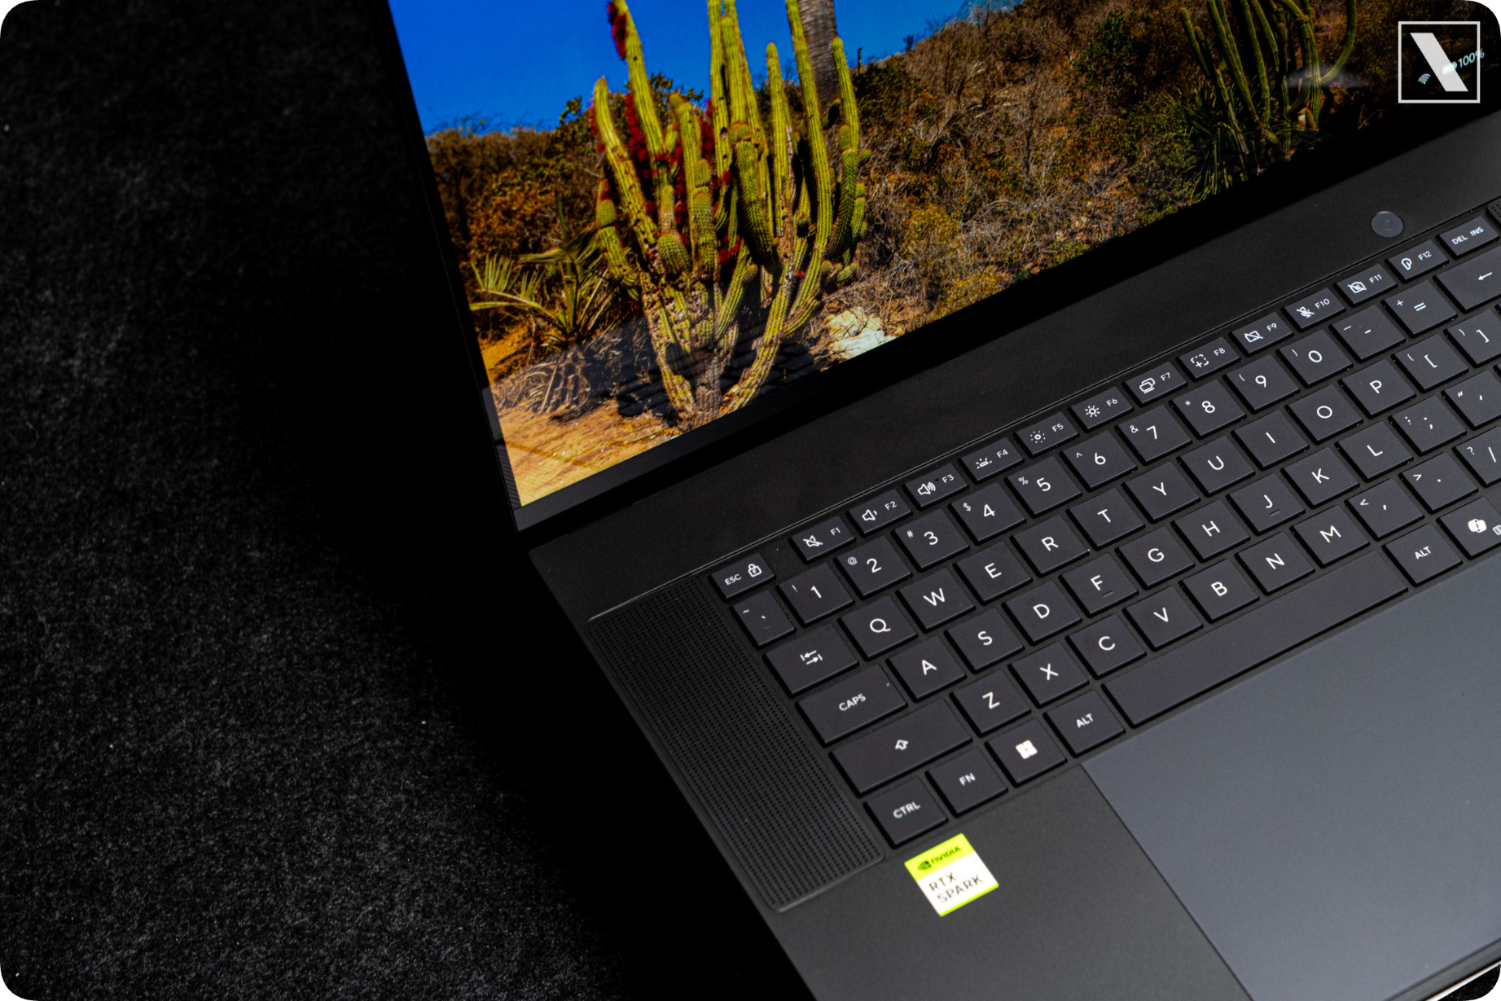
APPSO también tuvo acceso anticipado al ASUS ProArt 16 RTX Spark. La versión de 16 pulgadas con 64 GB de memoria unificada tiene un precio de 28.999 RMB, mientras que la versión de 128 GB con memoria unificada cuesta 37.999 RMB.
Esta es la primera vez que Nvidia se introduce de esta forma en la plataforma de hardware principal de los ordenadores con Windows. Anteriormente, la mayoría de los ordenadores con Windows utilizaban procesadores Intel o AMD, y Nvidia solo suministraba tarjetas gráficas a los fabricantes de ordenadores.
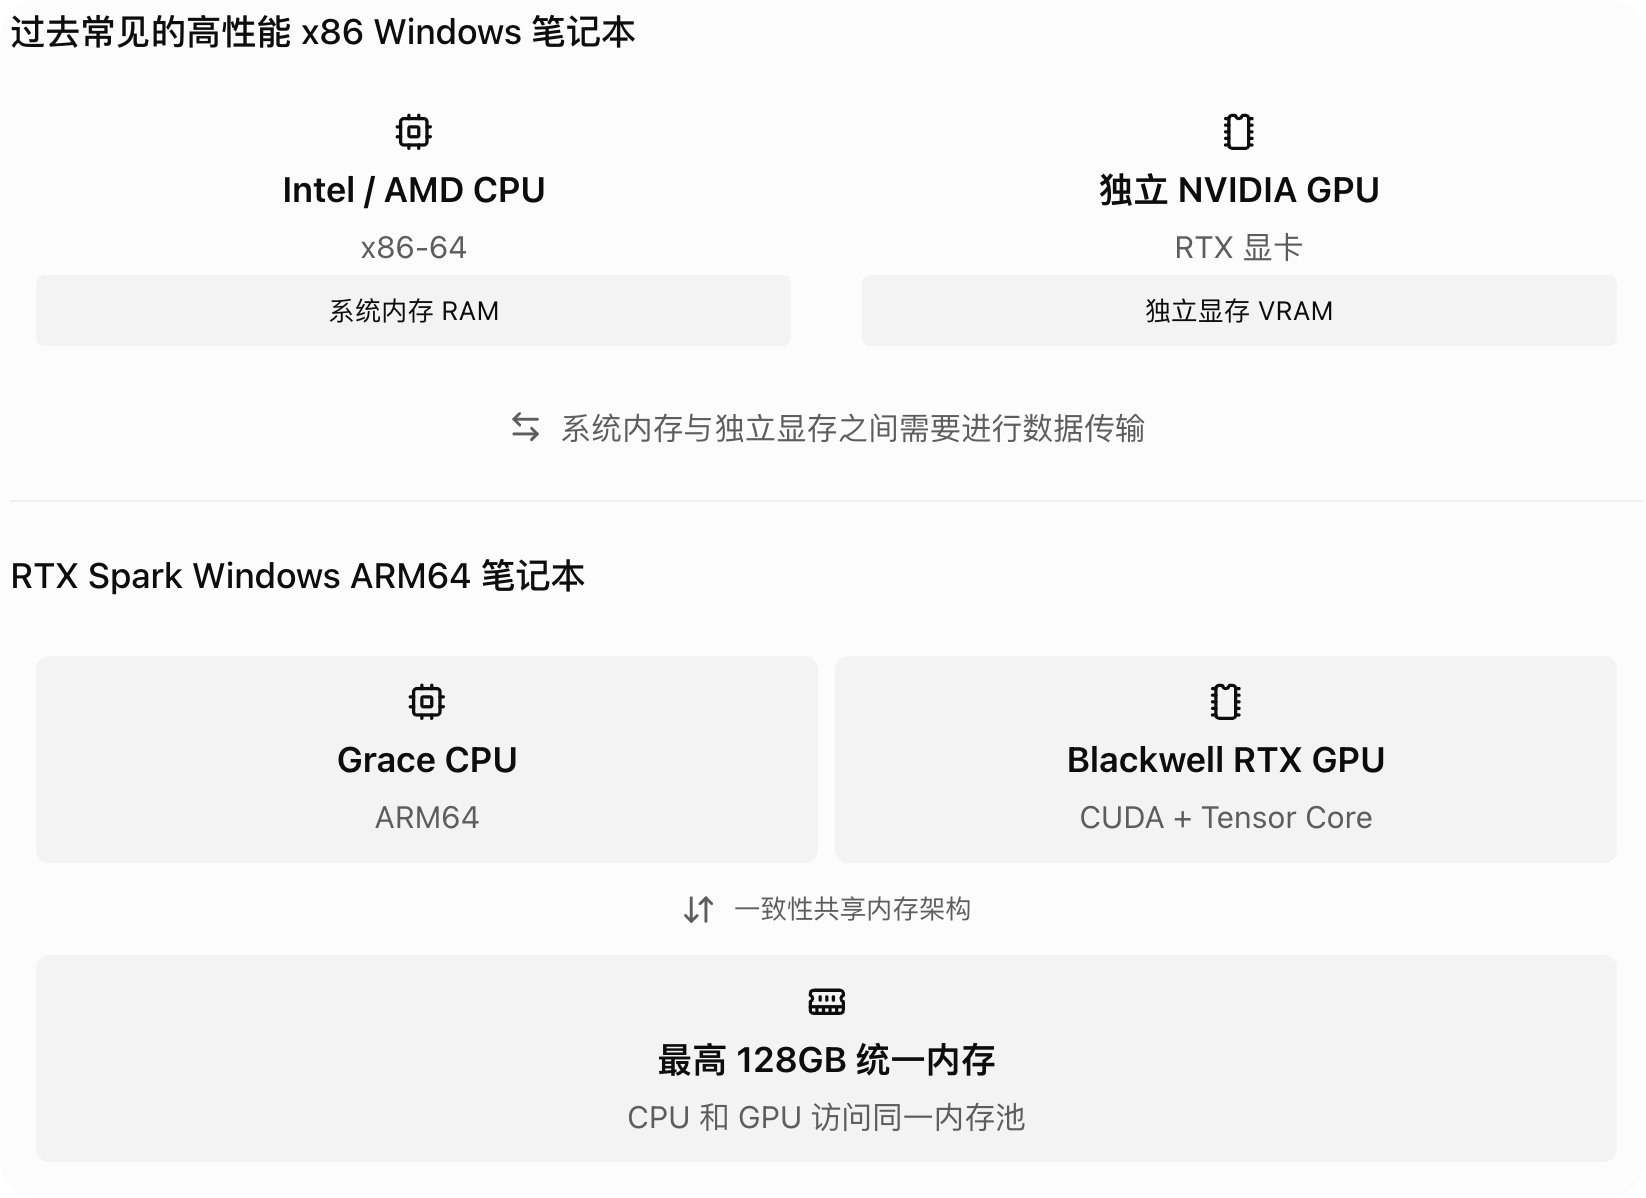
Ahora, Nvidia está empezando a combinar sus CPU ARM, GPU Blackwell RTX y memoria unificada para lanzar una plataforma informática completa capaz de ejecutar Windows.
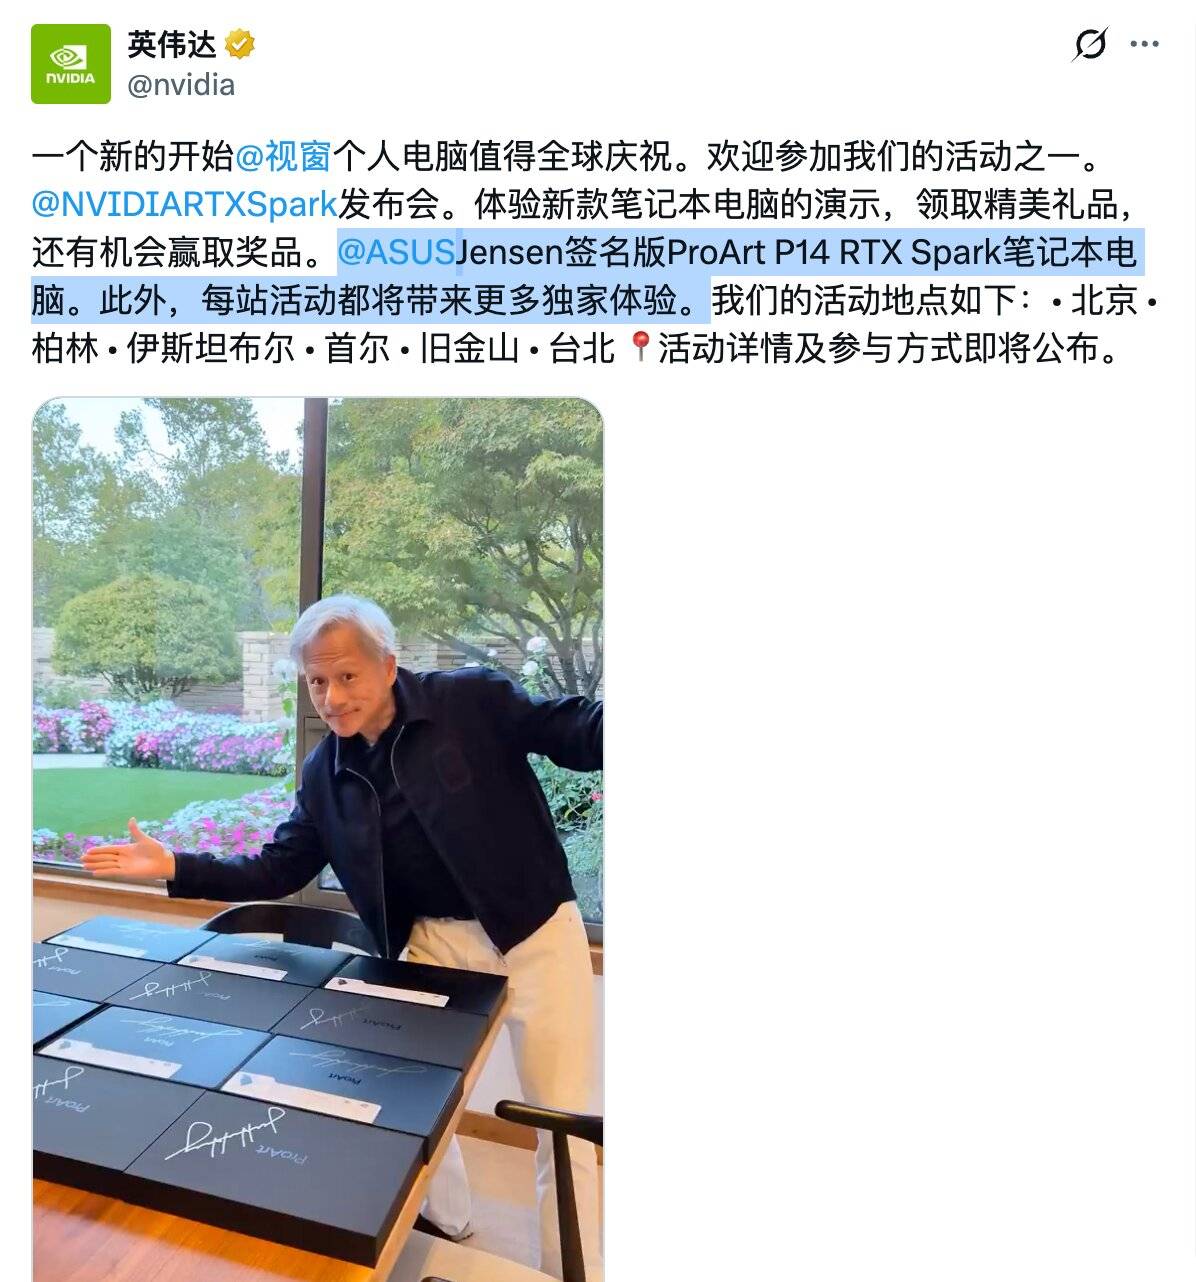
Tras usarlo durante un tiempo, APPSO ha descubierto más detalles para todos, incluyendo cómo se compara con un Mac como PC de IA, y si puede tratarse como un "producto de inversión" que se revalorice…
Introducir el modelo grande en un ordenador de al menos 12,9 mm de grosor.
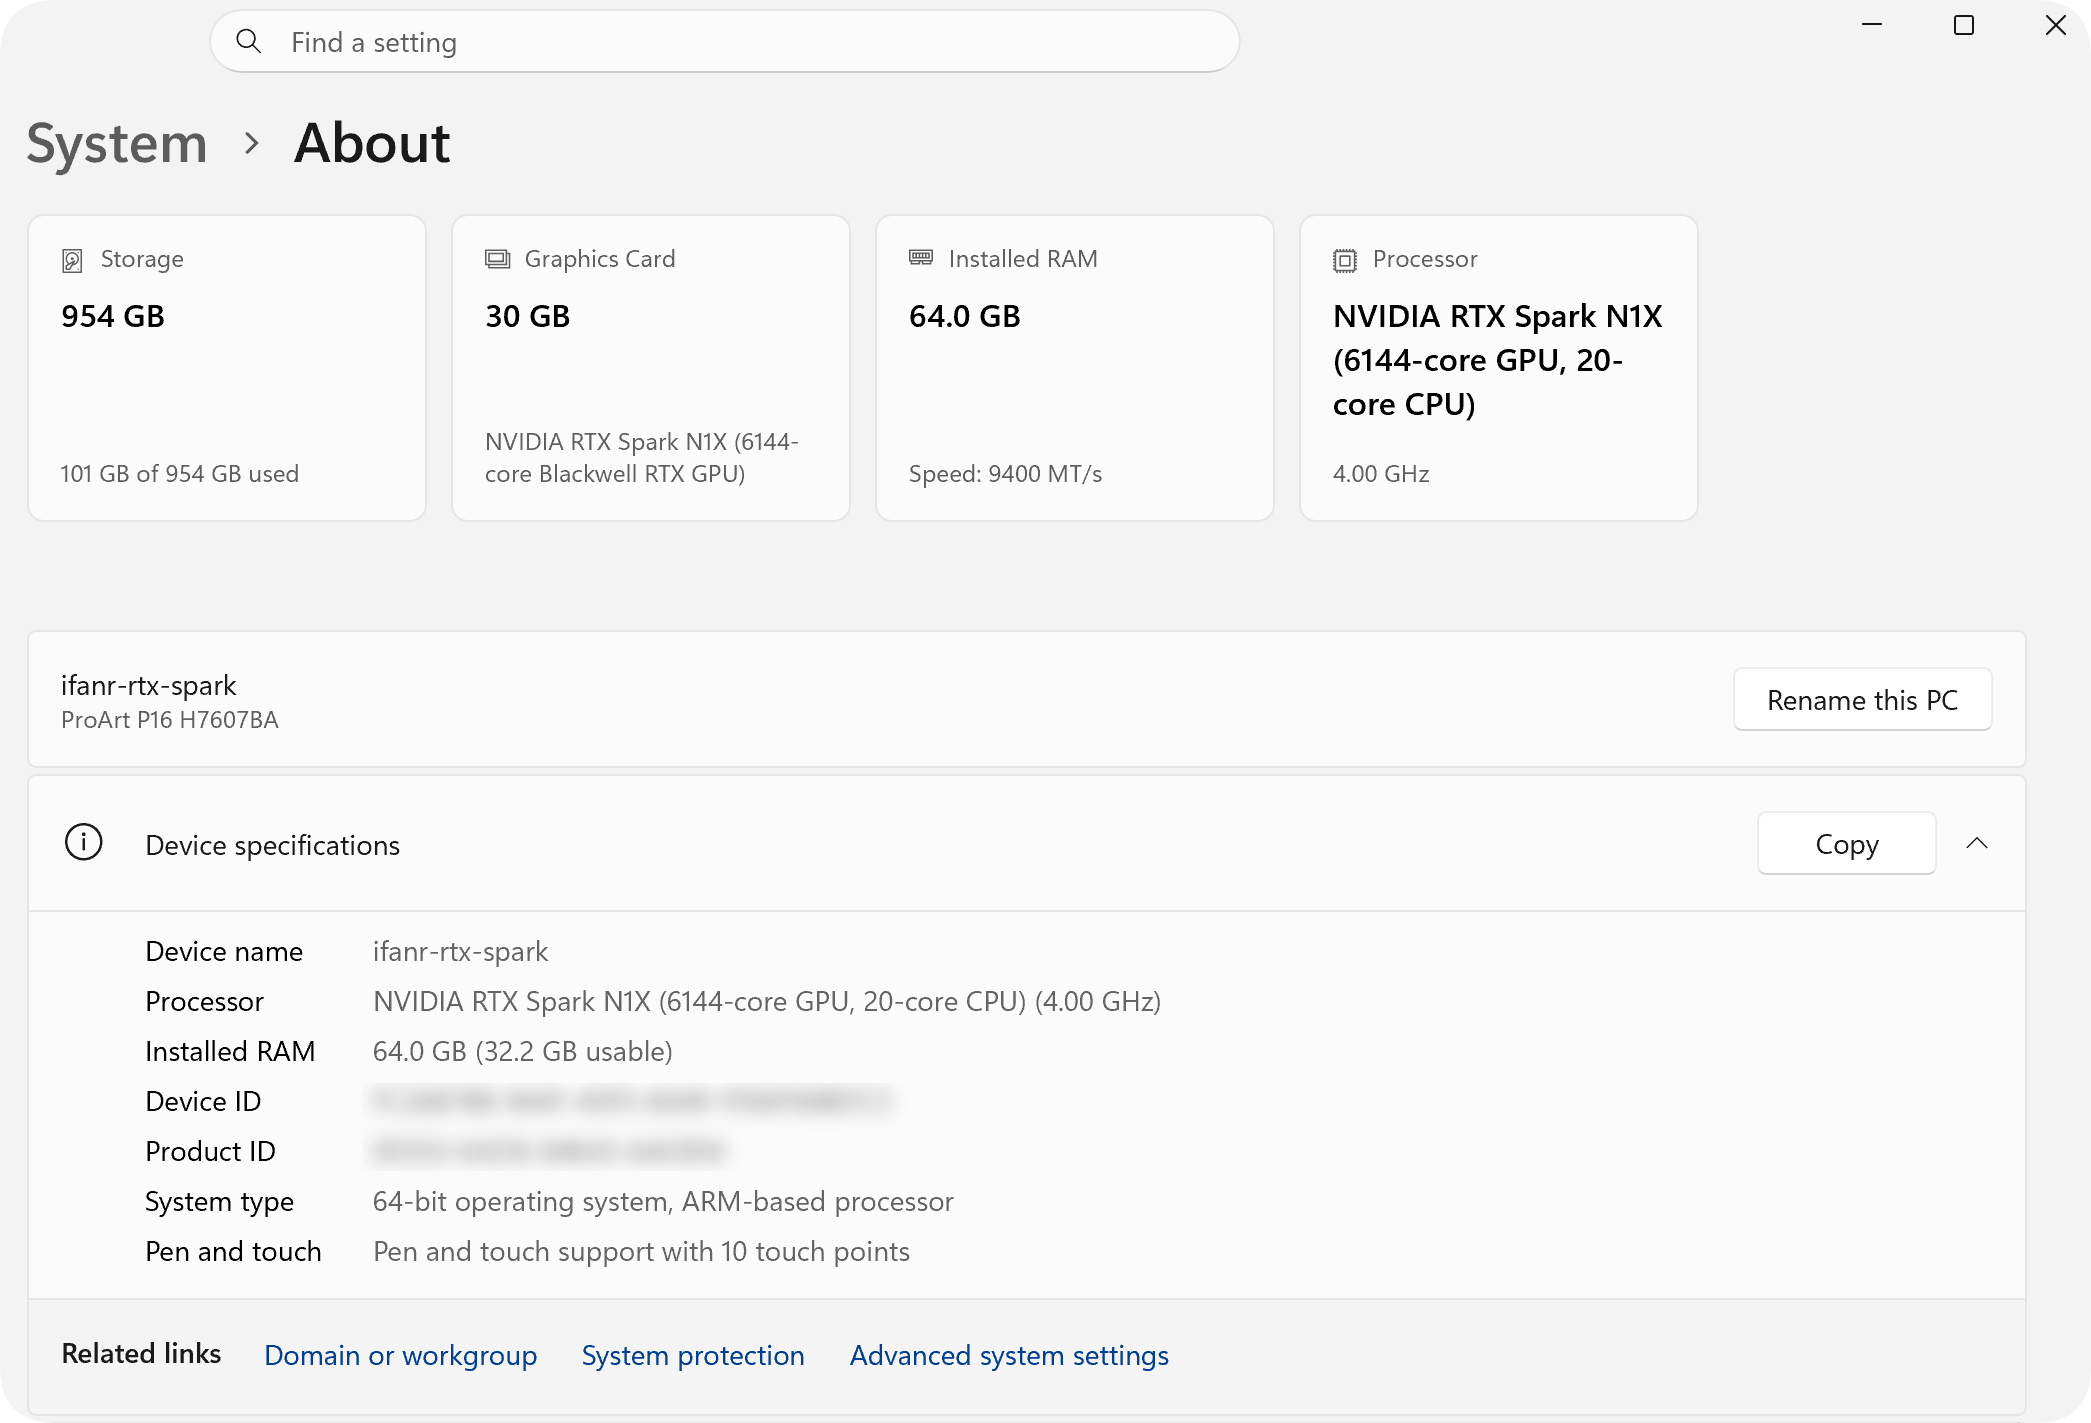
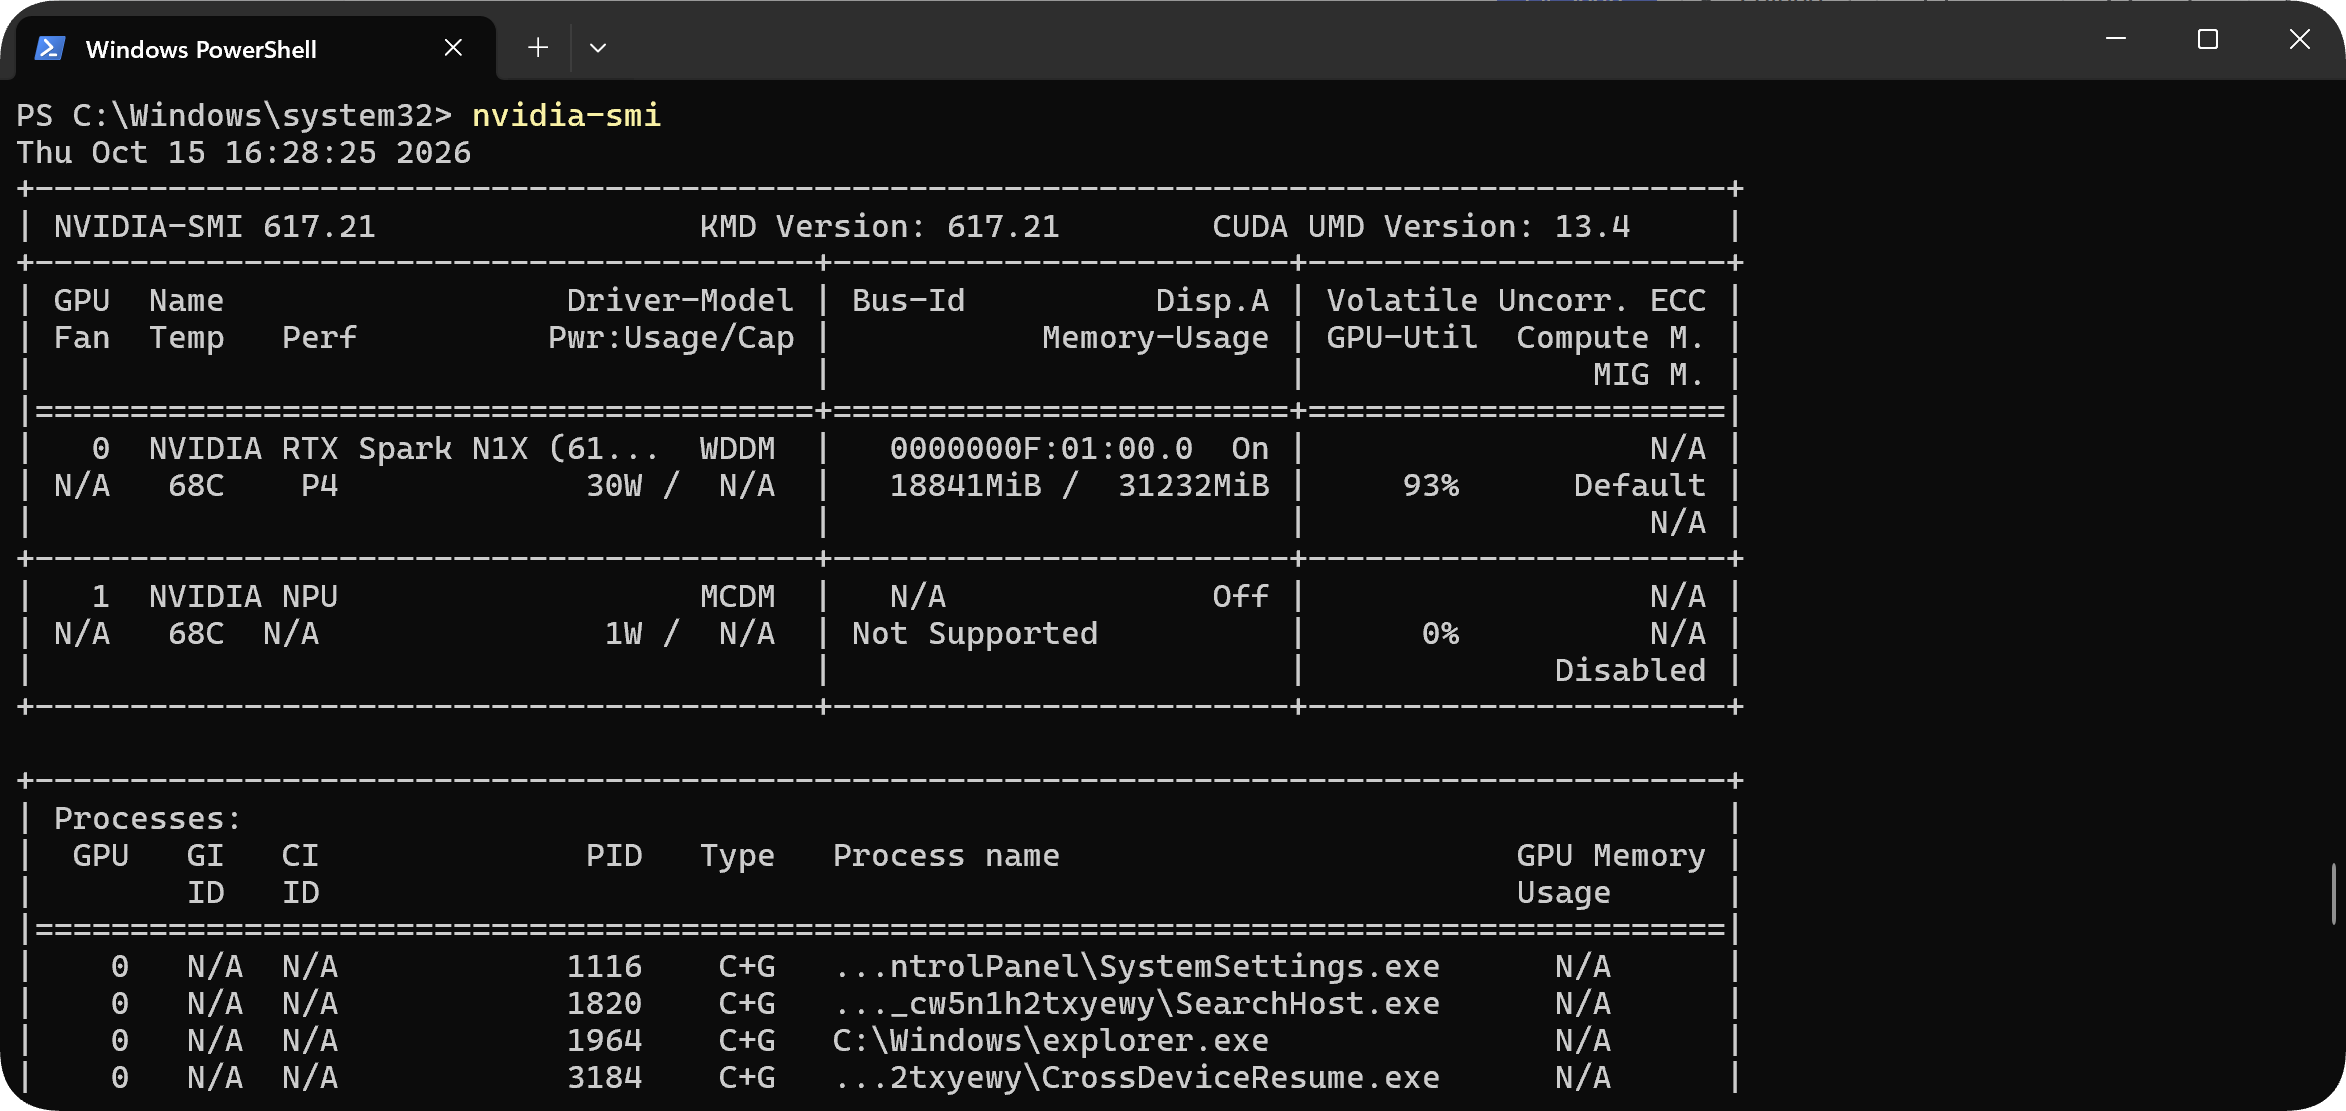
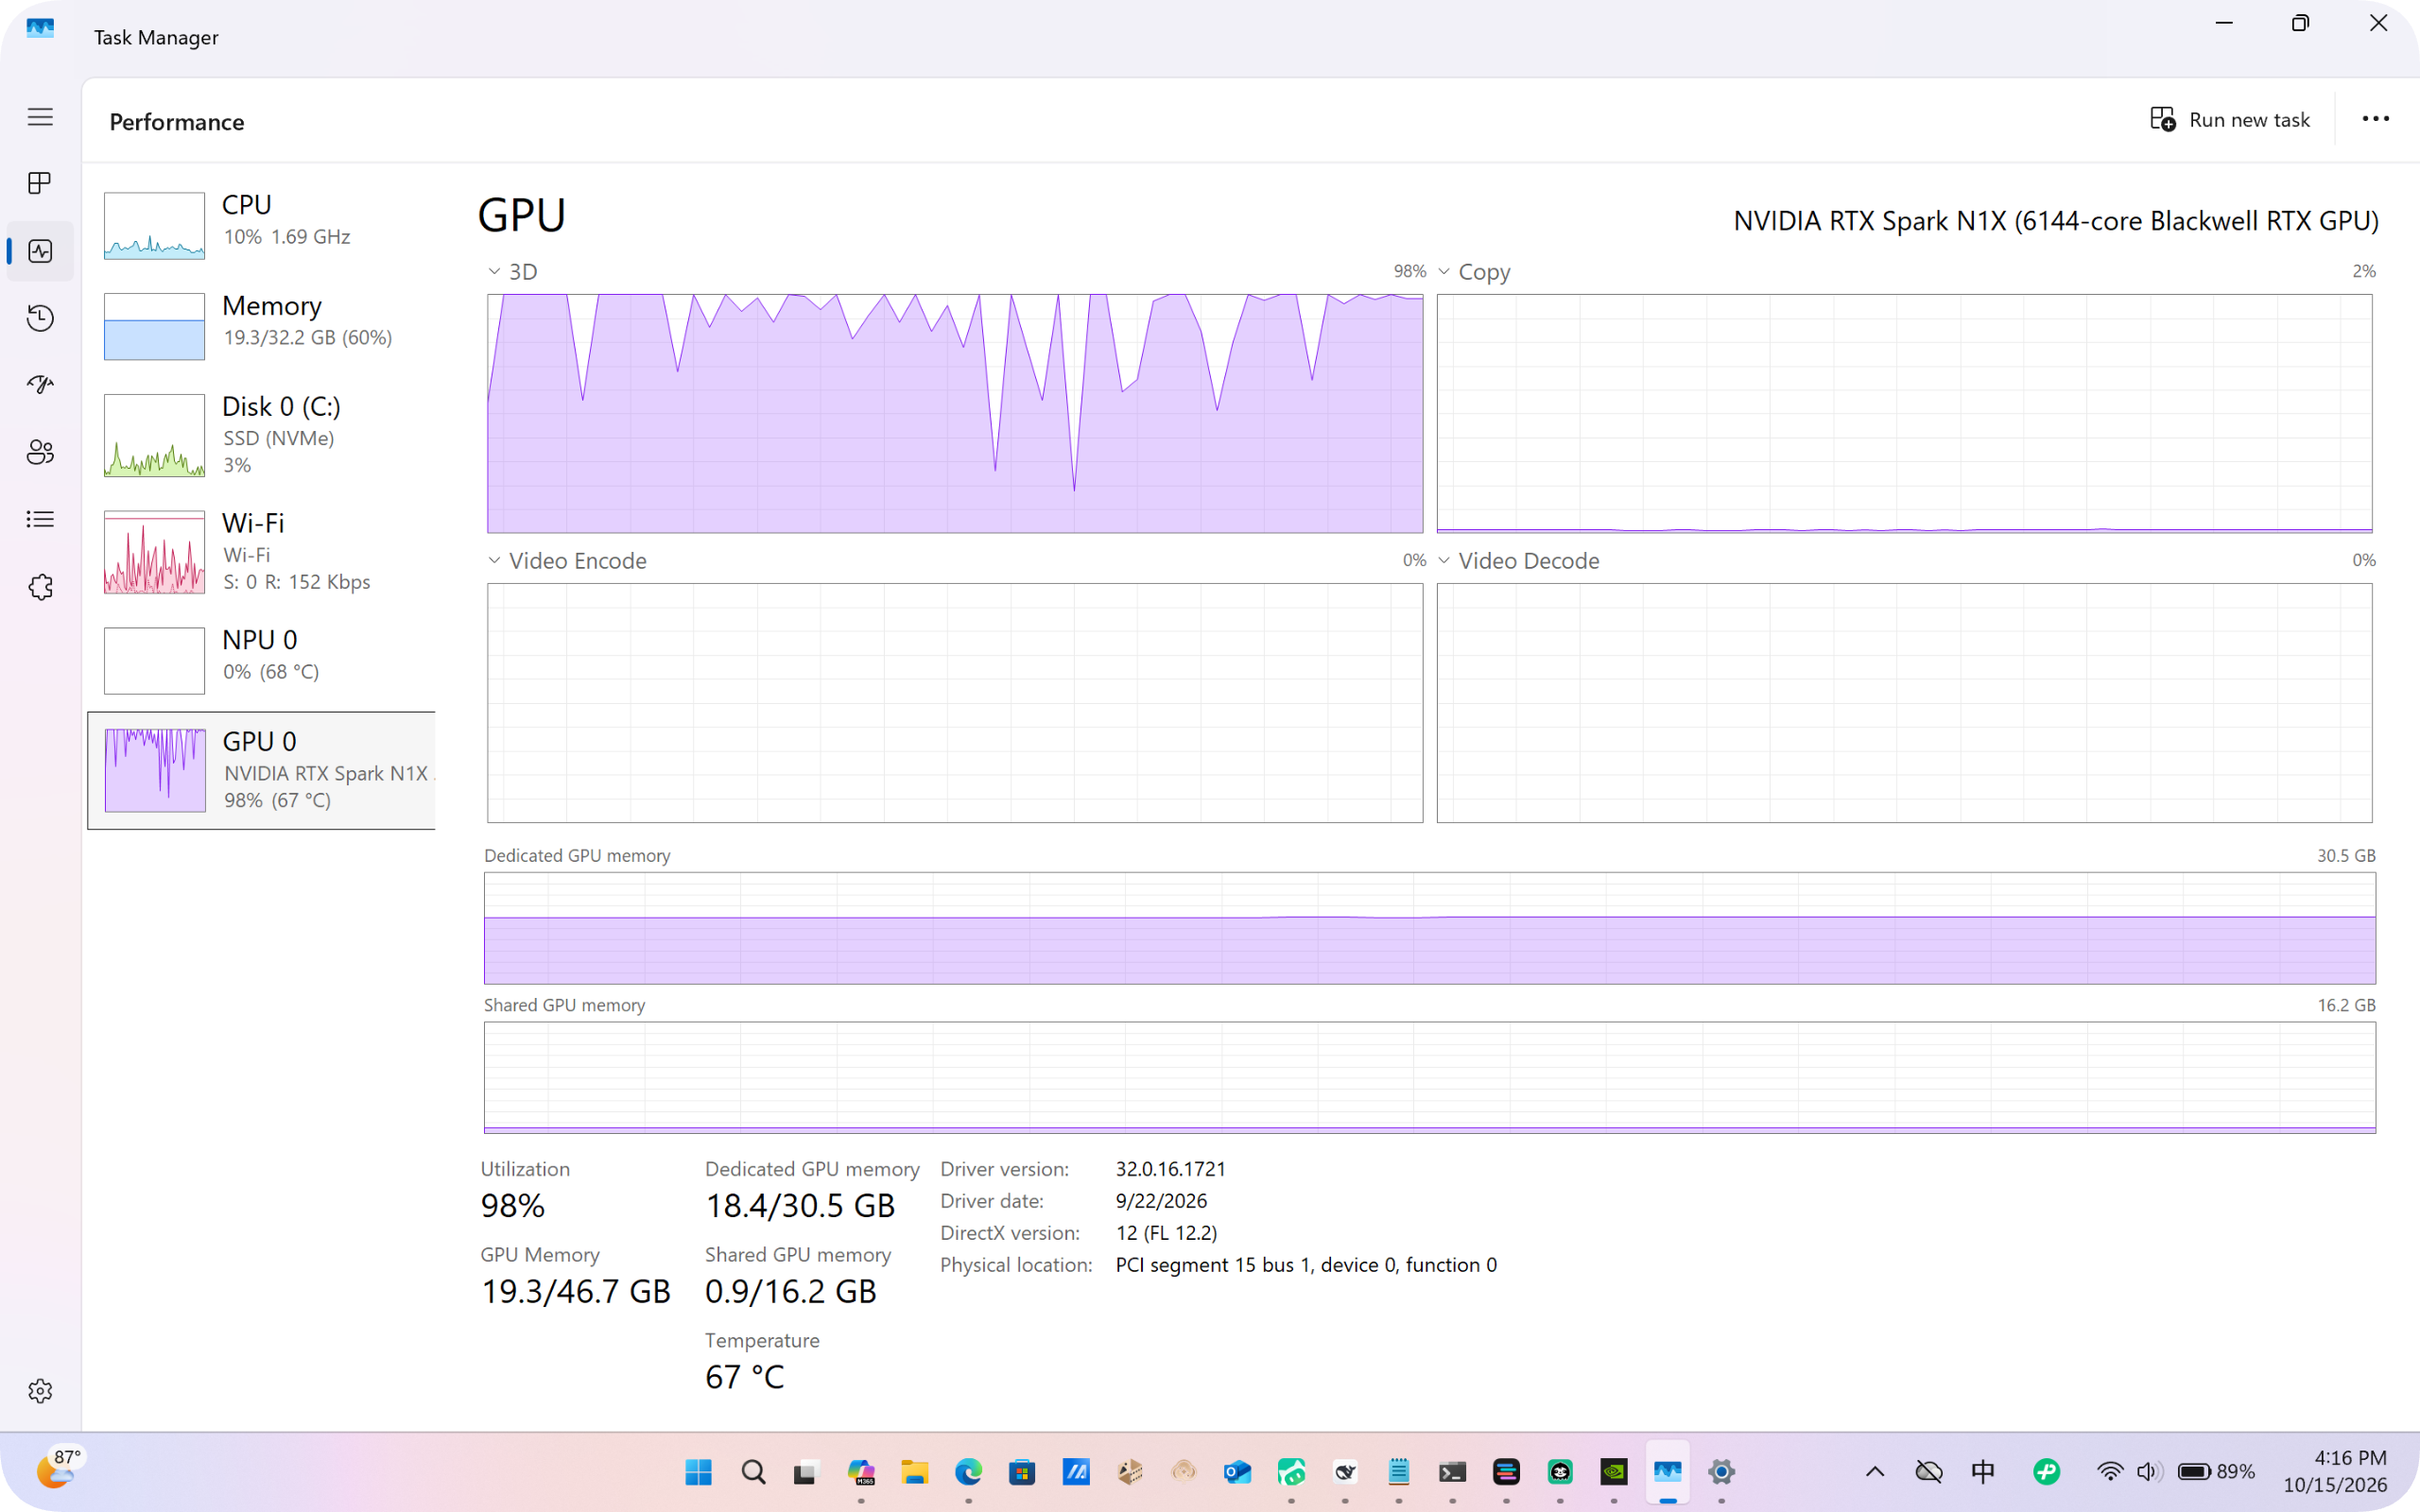
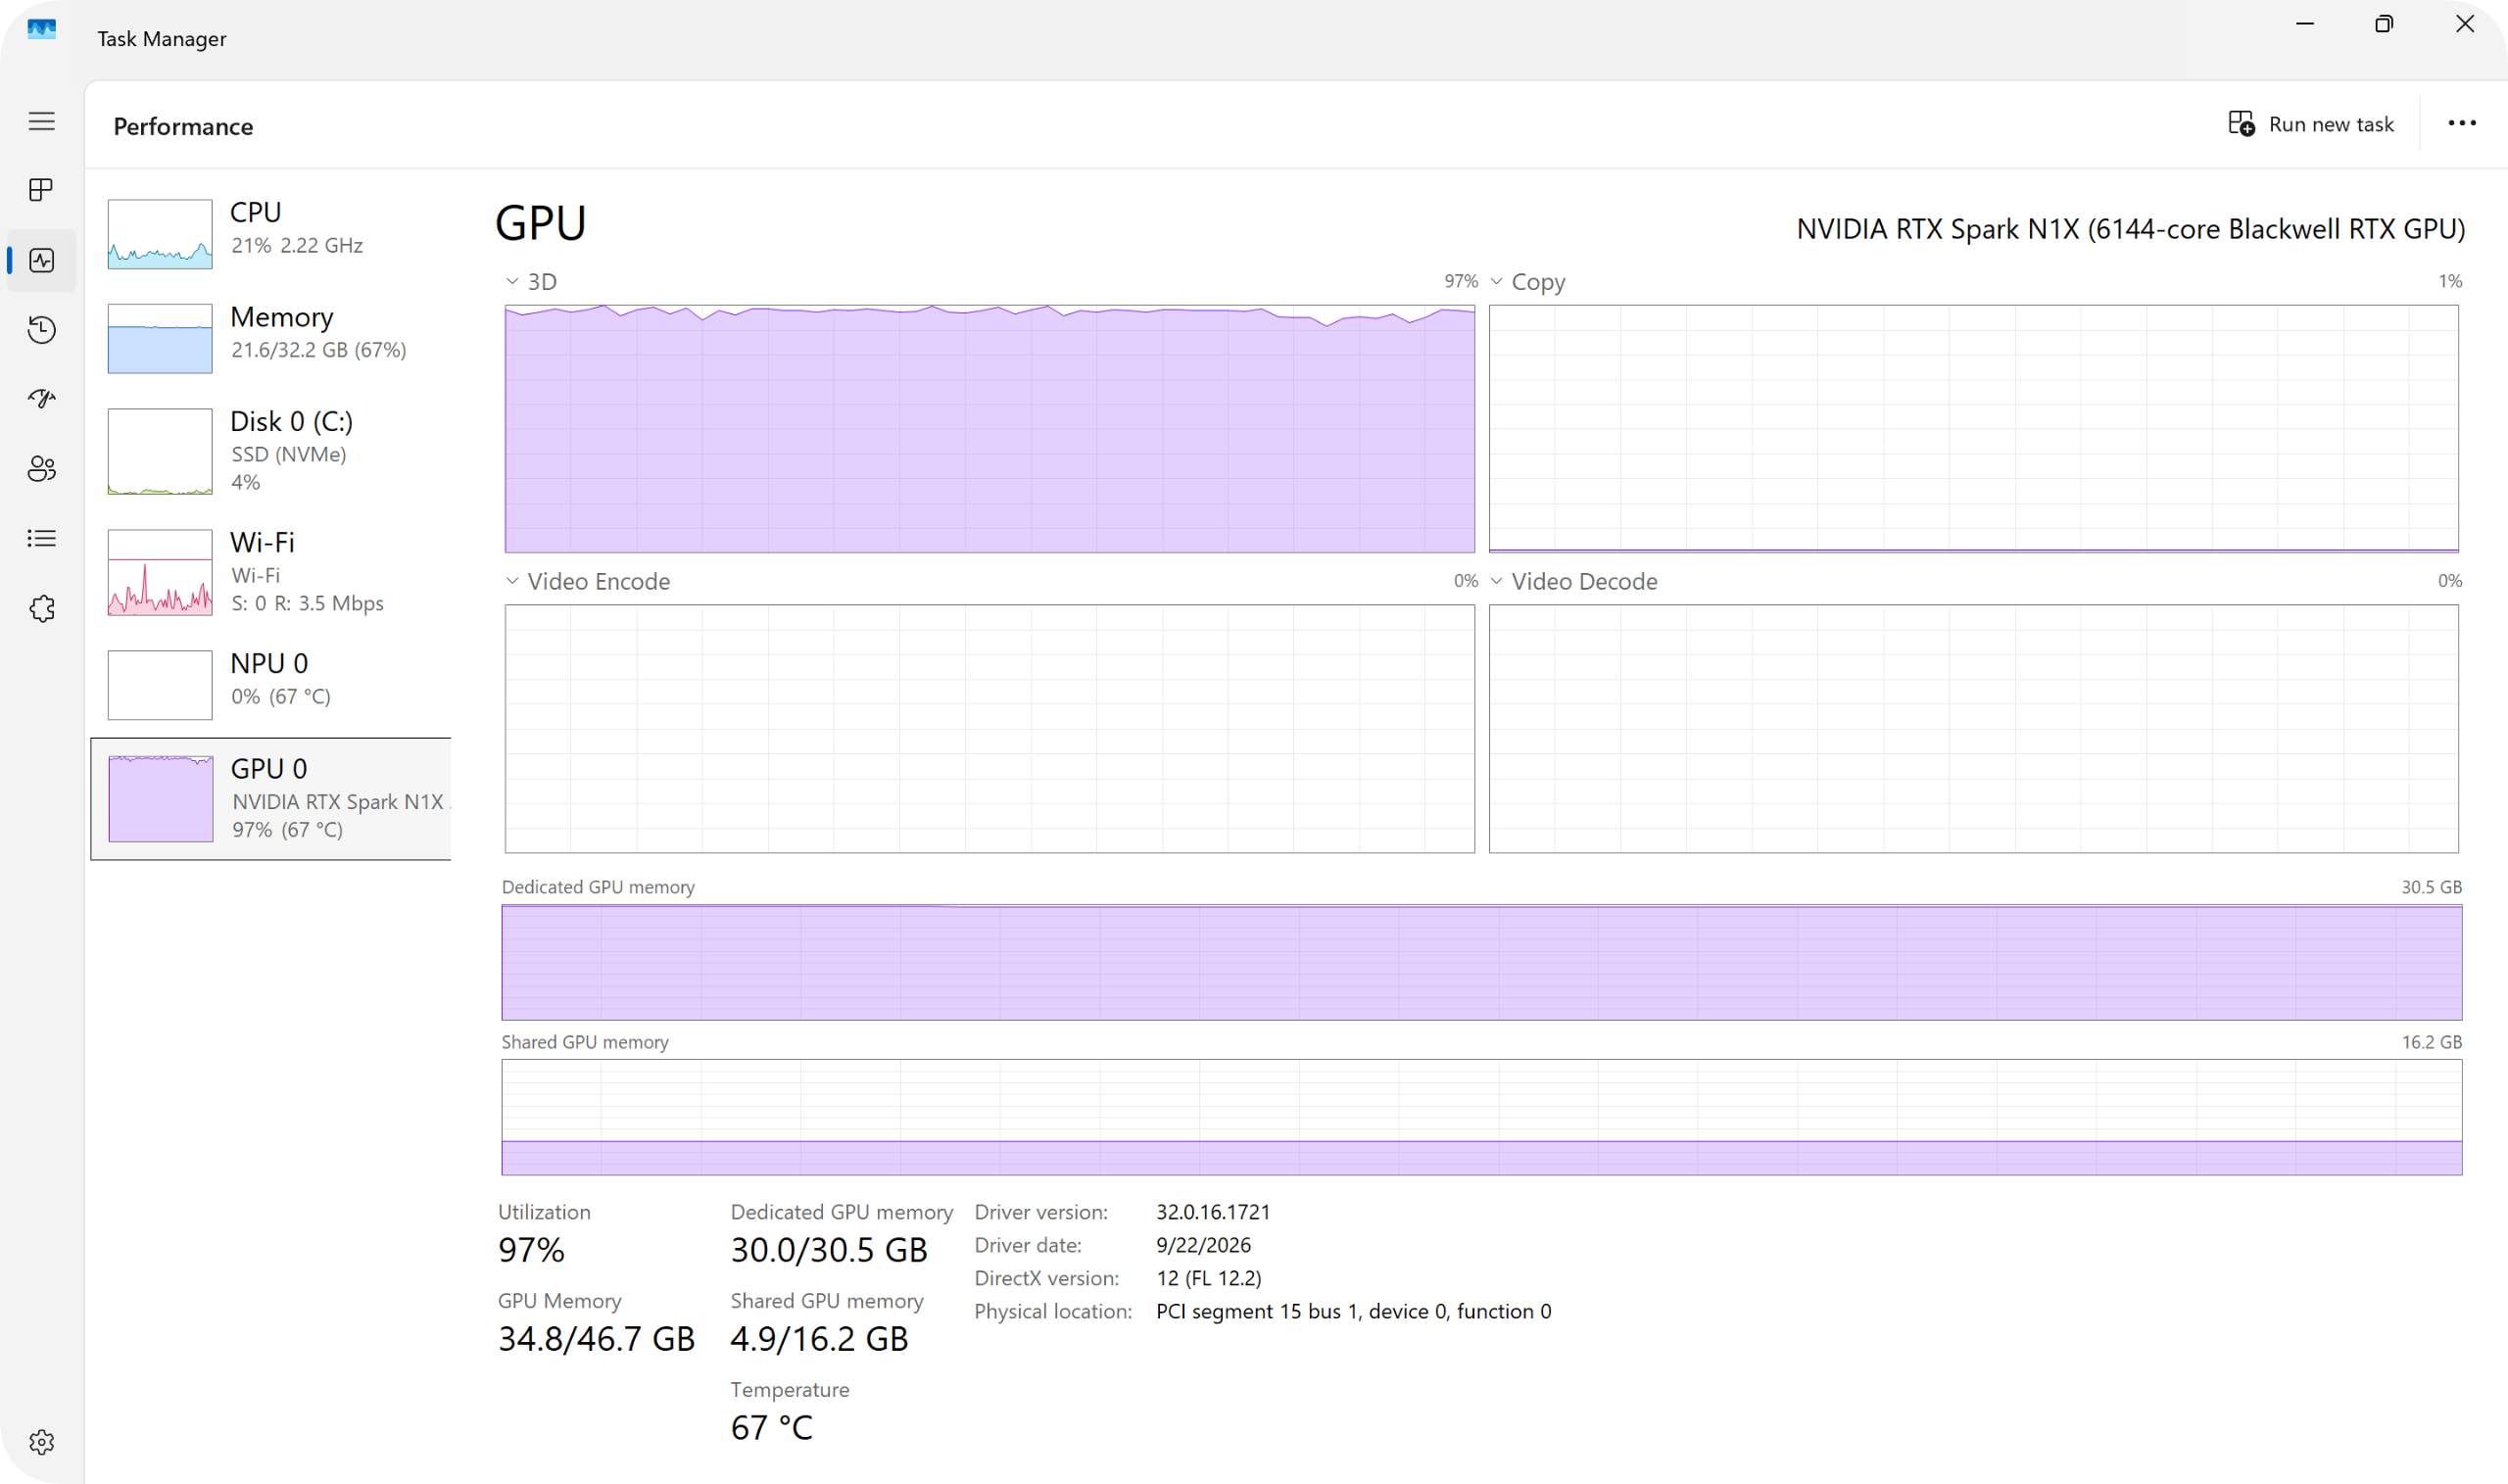
La versión que recibimos tiene 64 GB de memoria unificada. Debido a que utiliza memoria unificada, la memoria GPU realmente utilizable es de aproximadamente 46,7 GB. El tipo de memoria LPDDR5X le proporciona teóricamente una velocidad máxima de ancho de banda de memoria de 300 GB/s, suficiente para ejecutar modelos como Qwen 3.8 con 27 mil millones de parámetros.
Por otro lado, los portátiles con arquitectura Windows ARM del pasado tenían como objetivo principal responder a la pregunta de "si pueden ser tan delgados, ligeros, eficientes en consumo de energía y tener una batería de larga duración como el MacBook Air".
La arquitectura ARM64 de RTX Spark permite que este ordenador alcance ventajas similares en cuanto a eficiencia energética y memoria unificada a las de los Mac con procesadores Apple Silicon, al tiempo que conserva el ecosistema de aplicaciones de Windows y las capacidades CUDA de NVIDIA.
En cuanto a la duración de la batería, el ASUS ProArt 16 RTX Spark cuenta con una batería de 99,9 Wh. Utilizamos un modelo local de 27 mil millones de parámetros para generar texto de forma continua y realizar inferencias. Tras desconectar la alimentación, observamos que la potencia de descarga de la batería era de aproximadamente 86,5 W, y la energía restante descendió de 98,5 Wh a 96,1 Wh en tan solo 2 minutos.
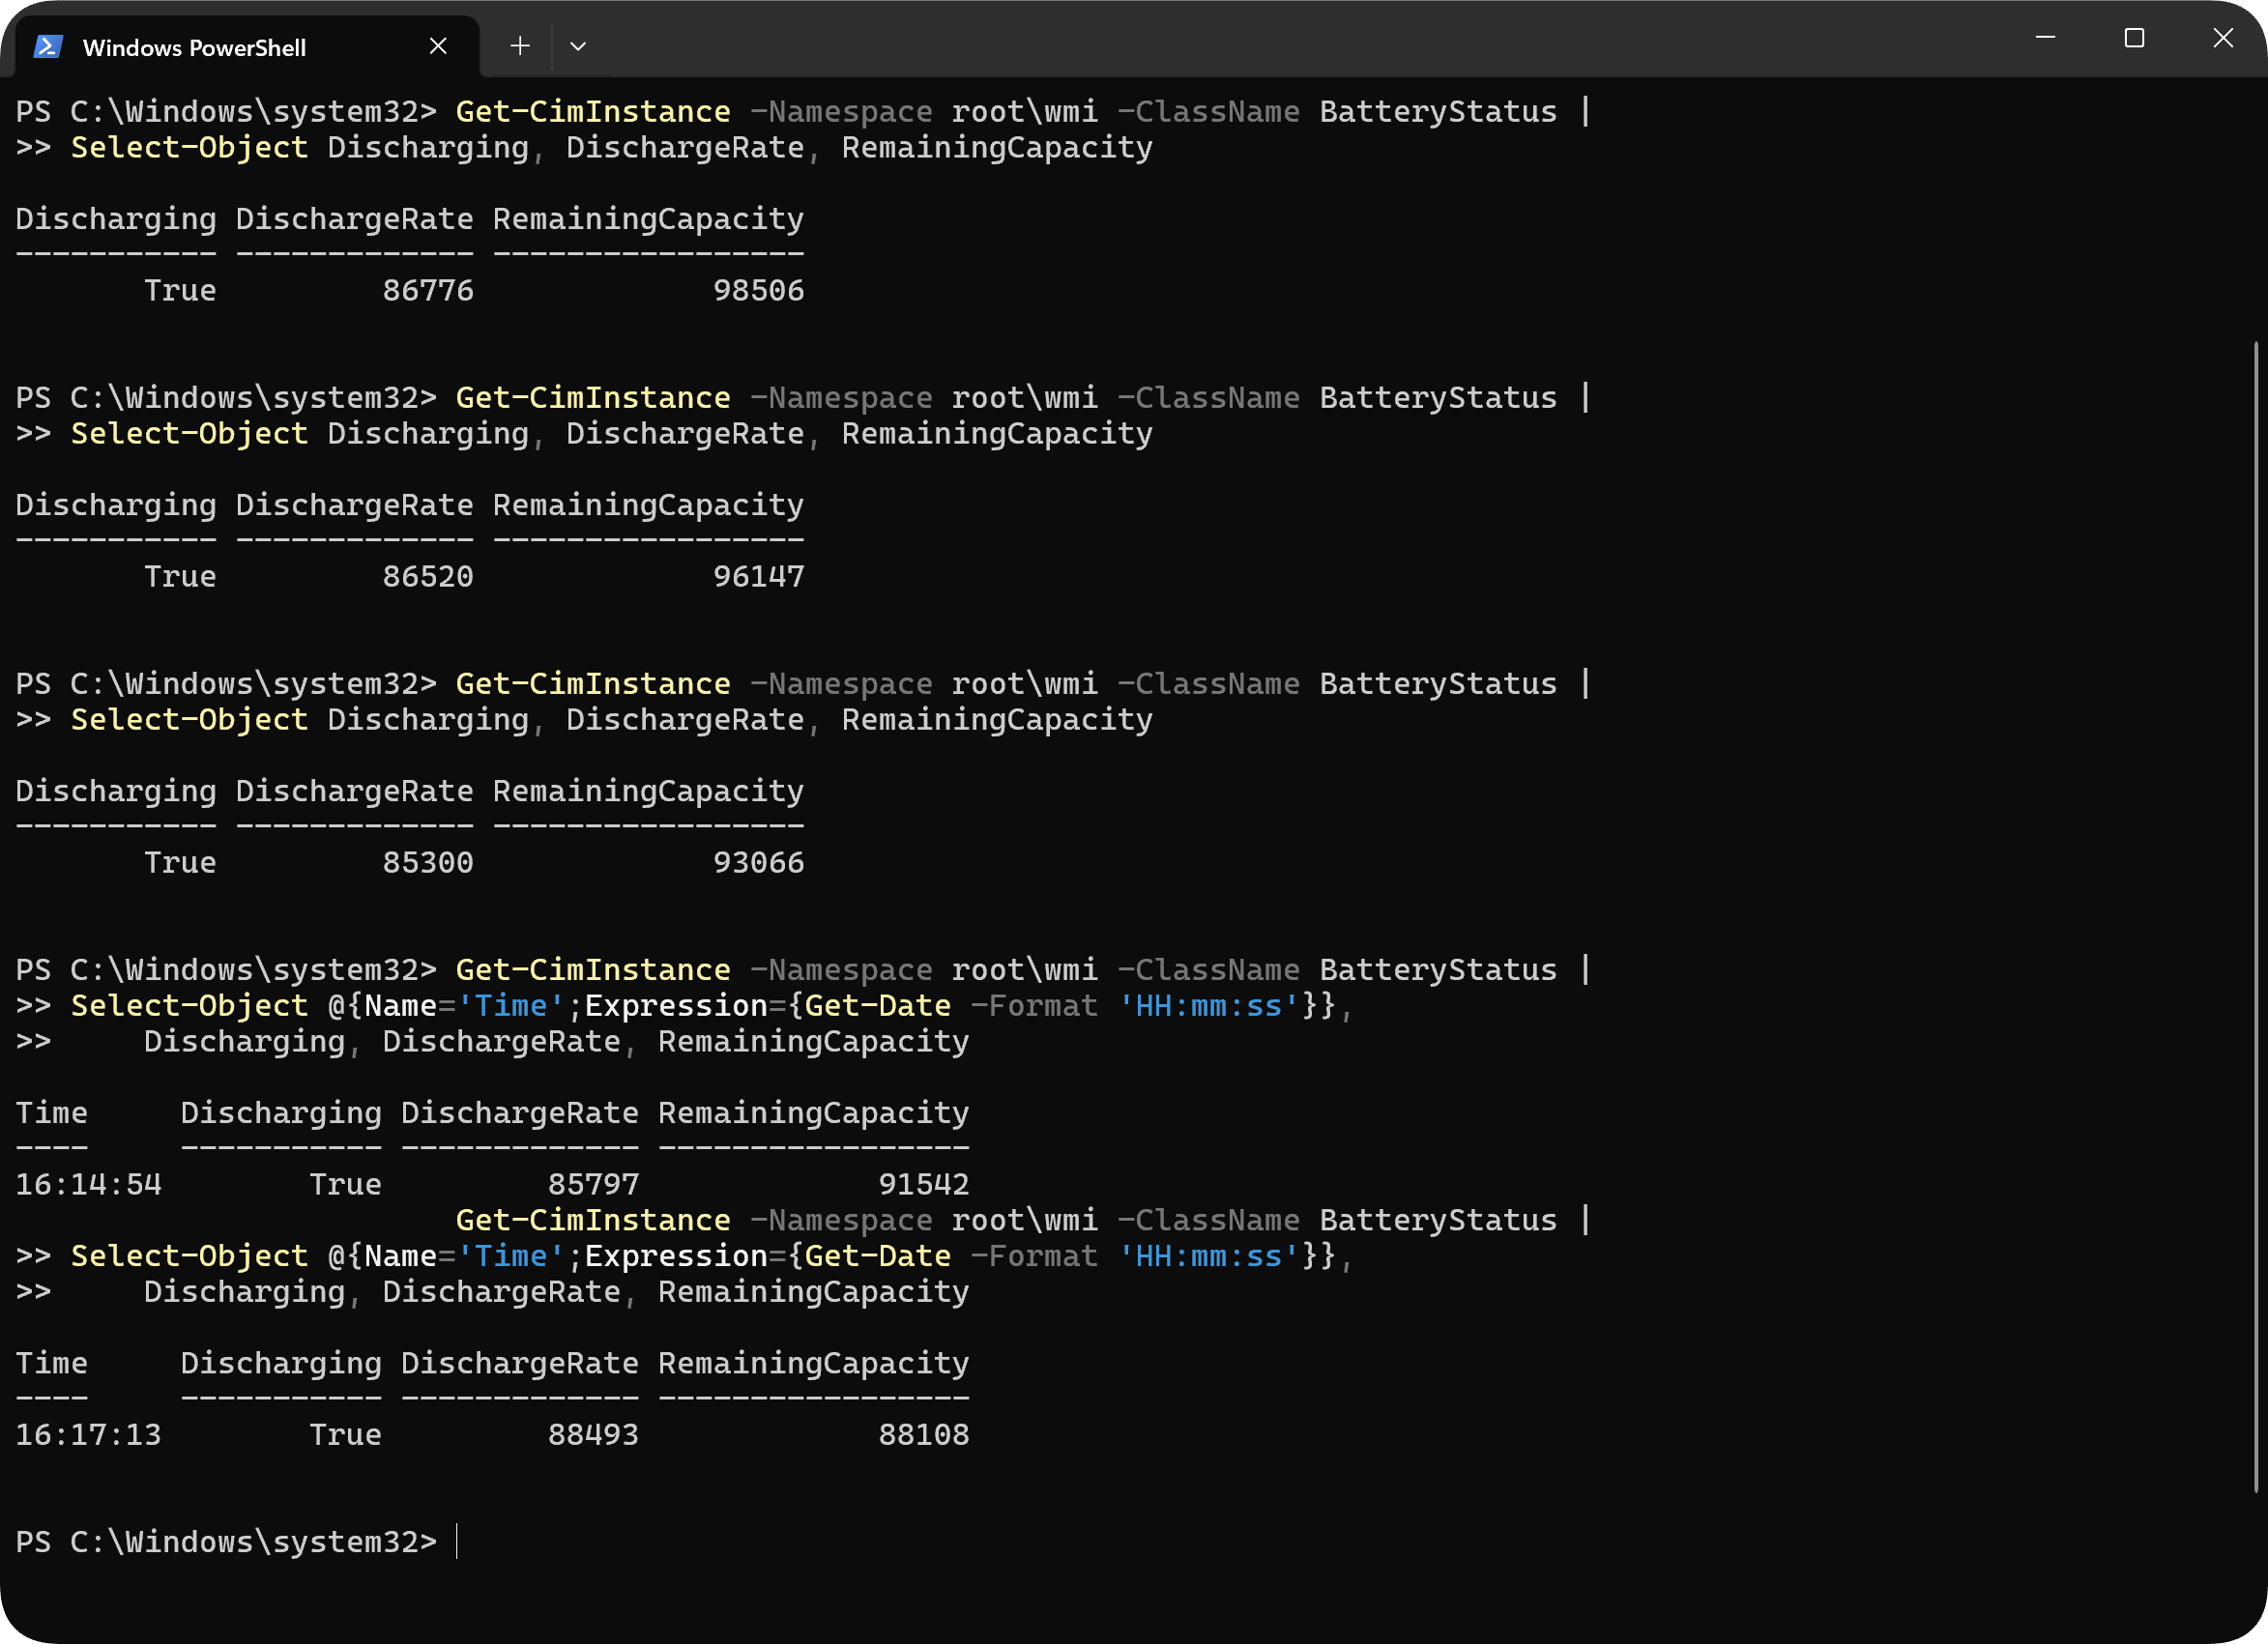
Suponiendo un consumo medio de 80 W, la duración teórica de la batería de 99,9 Wh es de aproximadamente 1 hora y 15 minutos. En otras palabras, si se utiliza de forma continua un modelo 27B o superior, puede durar aproximadamente una hora sin necesidad de enchufarlo.
Para un portátil capaz de ejecutar grandes modelos de IA localmente, un portátil que tiene solo 12,9 mm de grosor y pesa alrededor de 1,77 kg, esto significa que incluso sin alimentación eléctrica, puede seguir gestionando tareas informáticas de alta carga durante un período de tiempo.
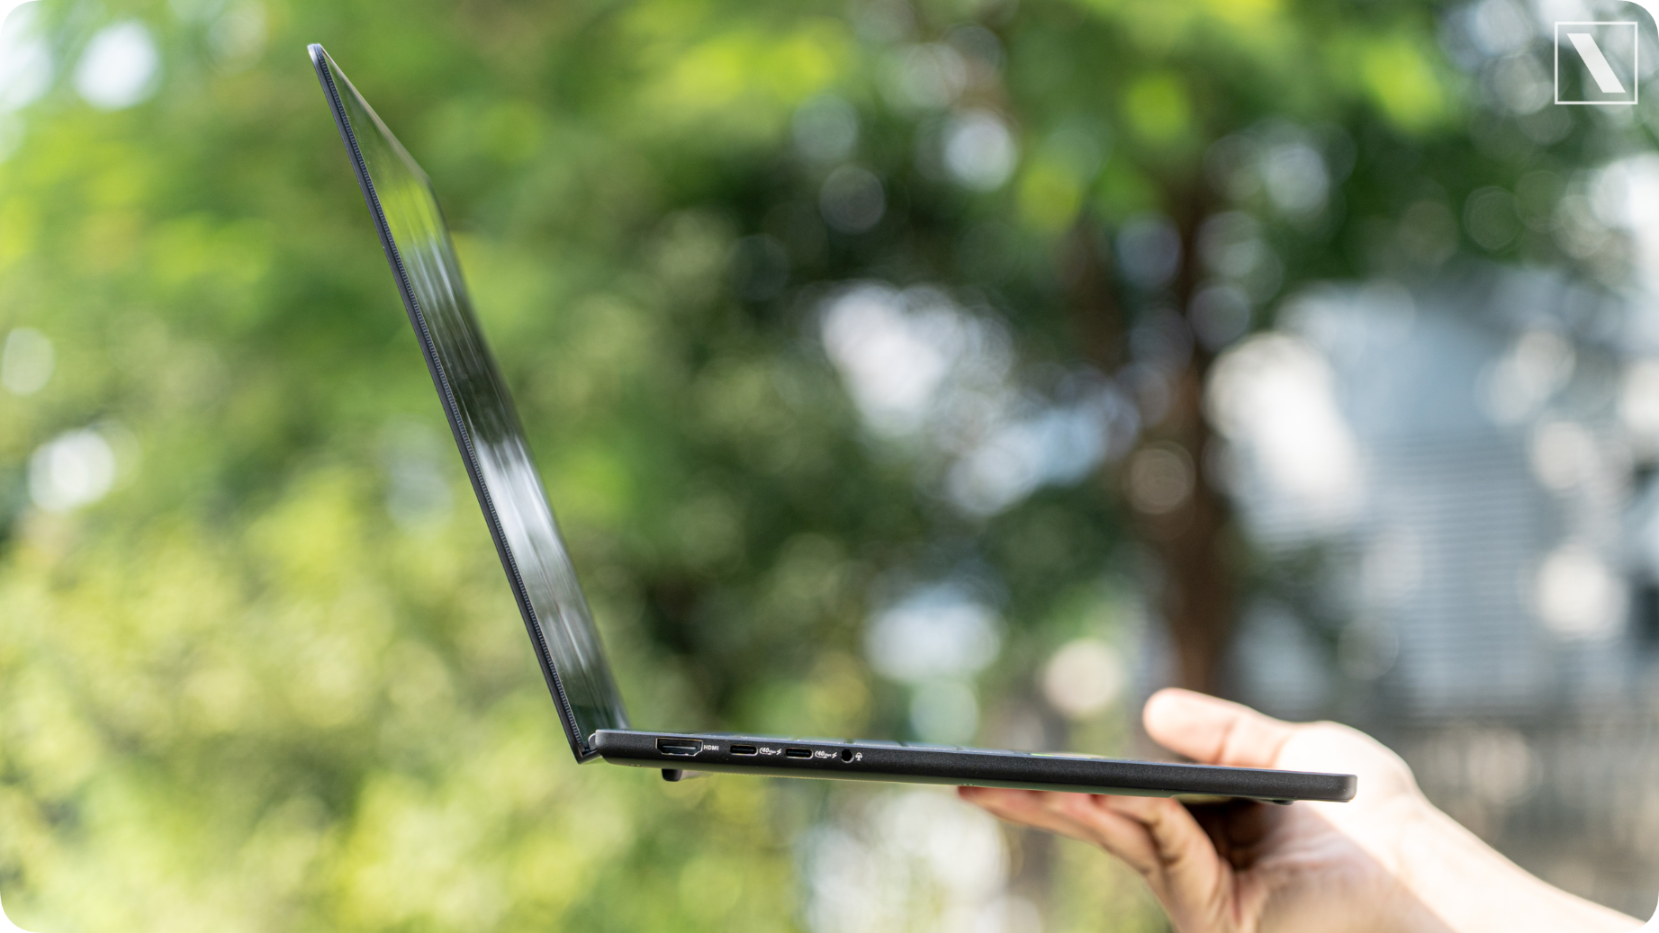
Además de la duración de la batería, este portátil ASUS ProArt 16 RTX Spark está equipado con una gran cantidad de puertos externos, incluidos tres puertos USB4 Tipo-C, cada uno con una velocidad máxima de 40 Gbps, que admiten salida de vídeo y suministro de energía USB PD.
Un puerto USB-A con tecnología USB 3.2 Gen 2, de hasta 10 Gbps; un puerto HDMI 2.1 FRL para conectar una pantalla externa; un puerto SD Express 7.0 para tarjetas de memoria de alta velocidad; y un conector de audio de 3,5 mm.
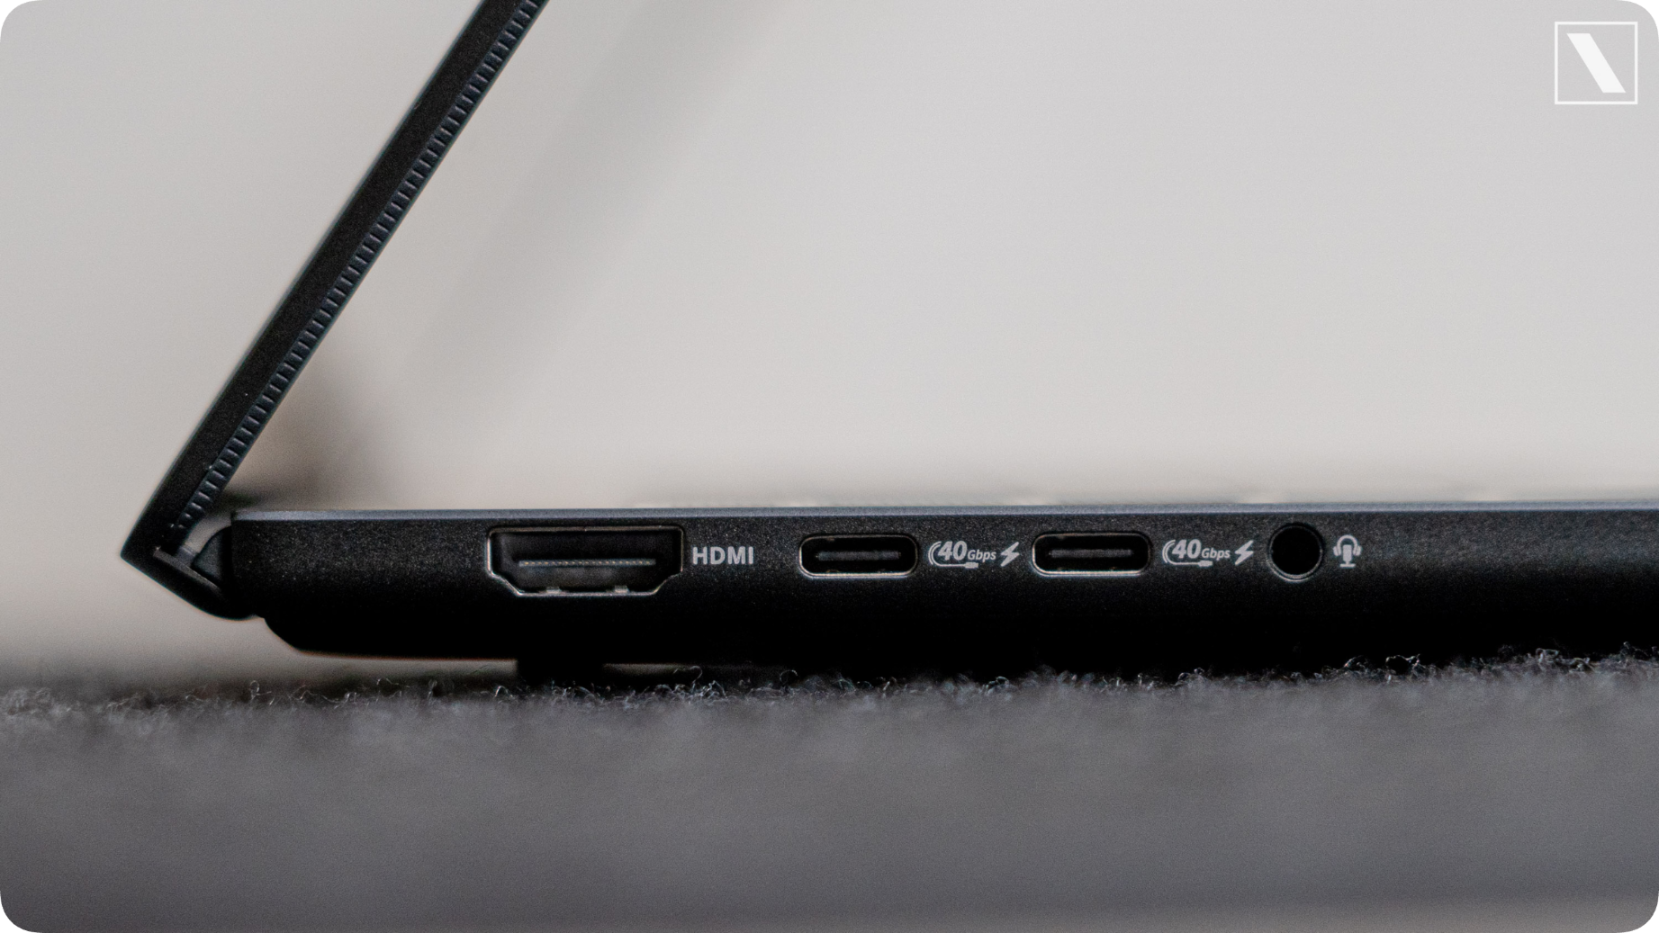
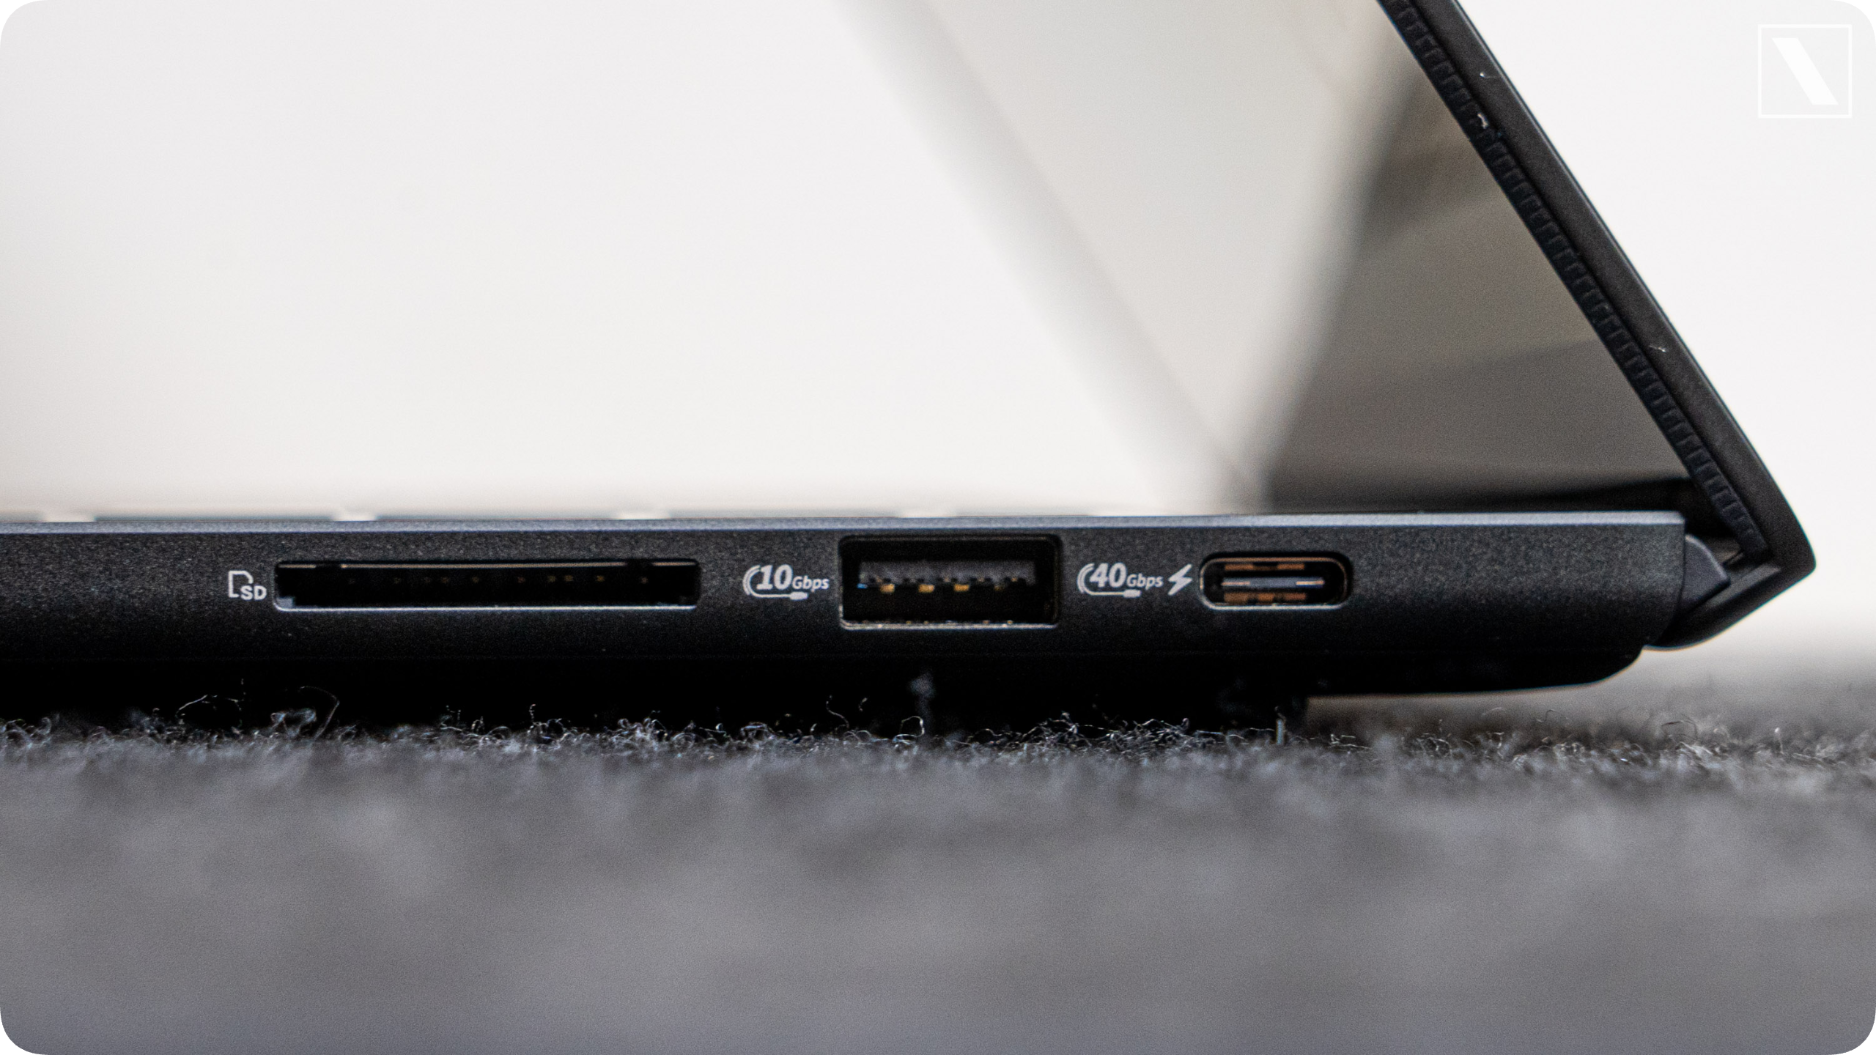
La principal ventaja de estas interfaces radica en que permiten que funcione como una estación de trabajo móvil: conectándose a discos duros externos de alta velocidad, monitores 4K, tarjetas de memoria para cámaras y diversos dispositivos creativos.
¿Cuánto trabajo puede realizar la IA con 64 GB de memoria unificada?
Hace unos días, en un evento especial de Microsoft, dividieron los PC con Windows en miniordenadores de sobremesa listos para usar nada más sacarlos de la caja, el PC Copilot+ con inteligencia híbrida, IA local y en la nube, y el PC Builder que puede utilizar IA en la nube y local para trabajos creativos.
Este portátil ASUS ProArt 16 RTX Spark pertenece a la categoría de PC para creadores, es decir, ordenadores personales para creadores. Actualmente, el trabajo creativo más popular utiliza la IA de forma natural, como en la generación de videojuegos, el modelado 3D y las aplicaciones web sencillas, todas las cuales requieren la intervención de la IA.
En el caso del ASUS ProArt 16 RTX Spark, una forma de introducir la IA es mediante la implementación local, ya que esta es la única manera de aprovechar al máximo las capacidades de NVIDIA RTX Spark.
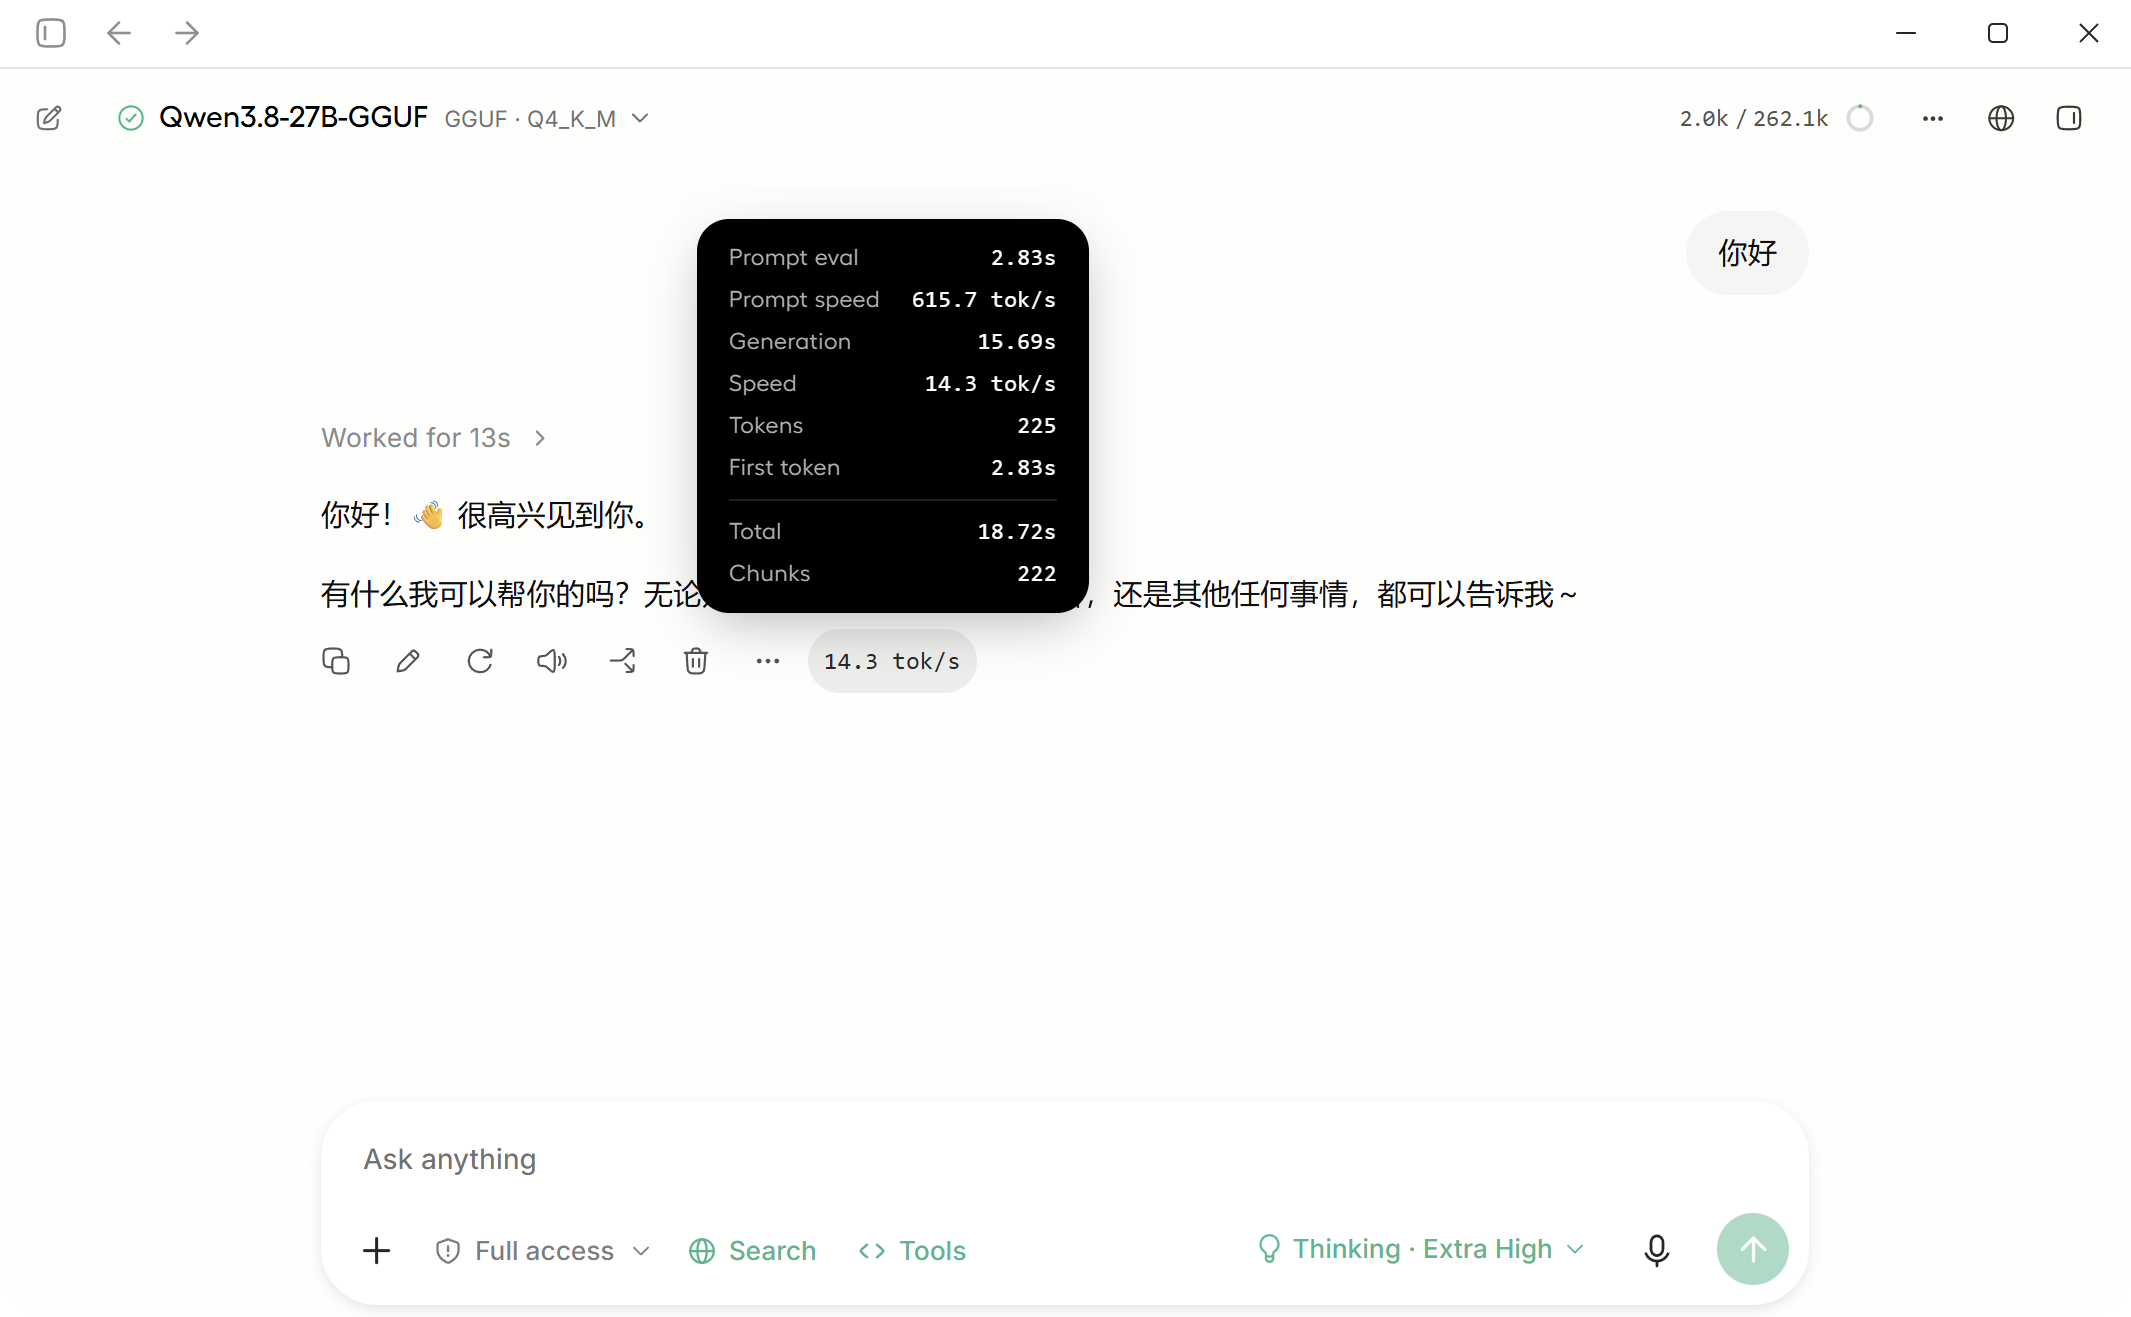
Descargamos LM Studio e instalamos el modelo Qwen 3.8 27B. Con la profundidad de pensamiento configurada en "Muy alta", la computadora portátil tardó un total de 18 segundos en completar el mensaje de entrada "Hola". La velocidad de respuesta del modelo para leer y procesar la entrada fue de 615,7 tokens/s, la velocidad de generación de tokens fue de 14,3 tokens/s y el tiempo para generar el primer token fue de 2,83 segundos.
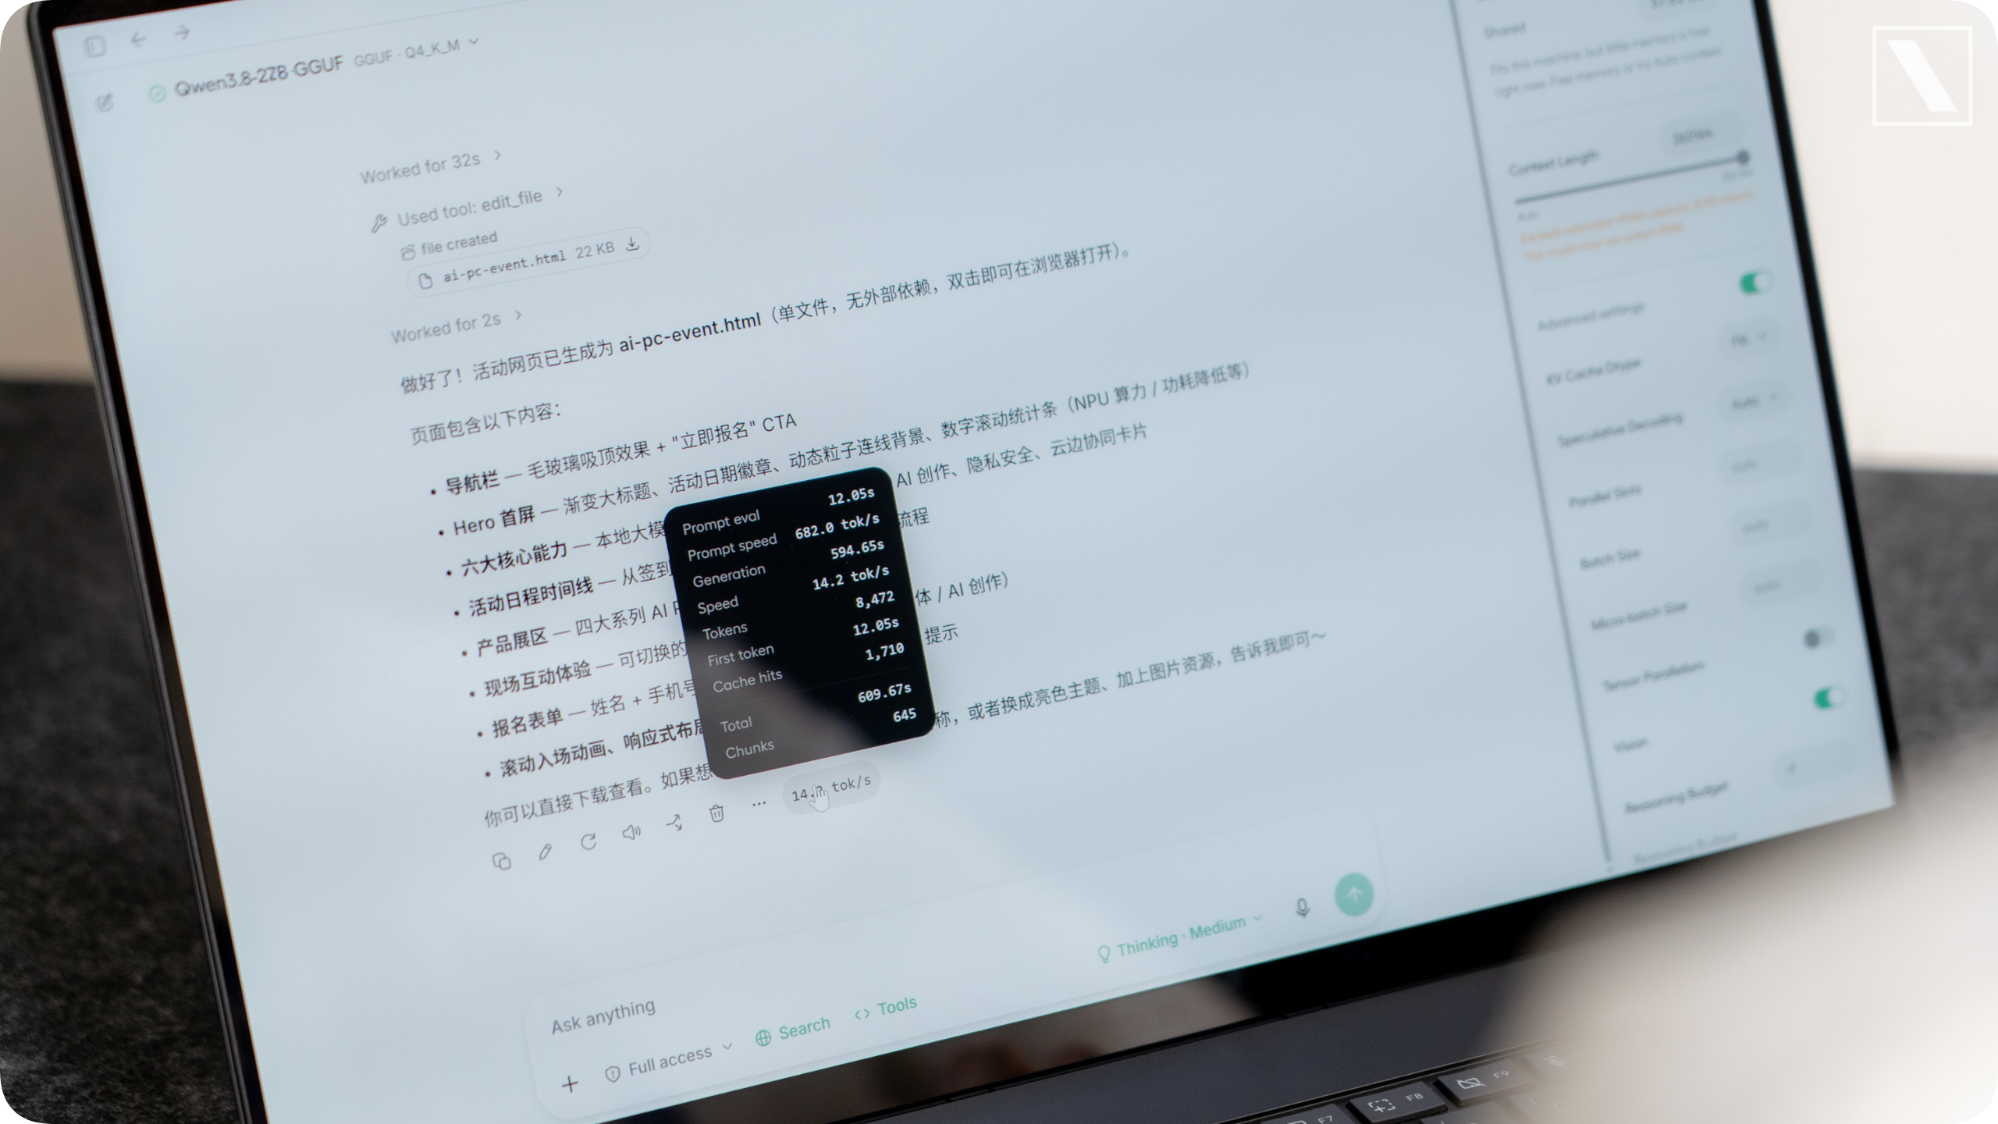
Cuando intentamos pedirle que realice algunos proyectos web, como diseñar una página web para un evento de IA para PC.
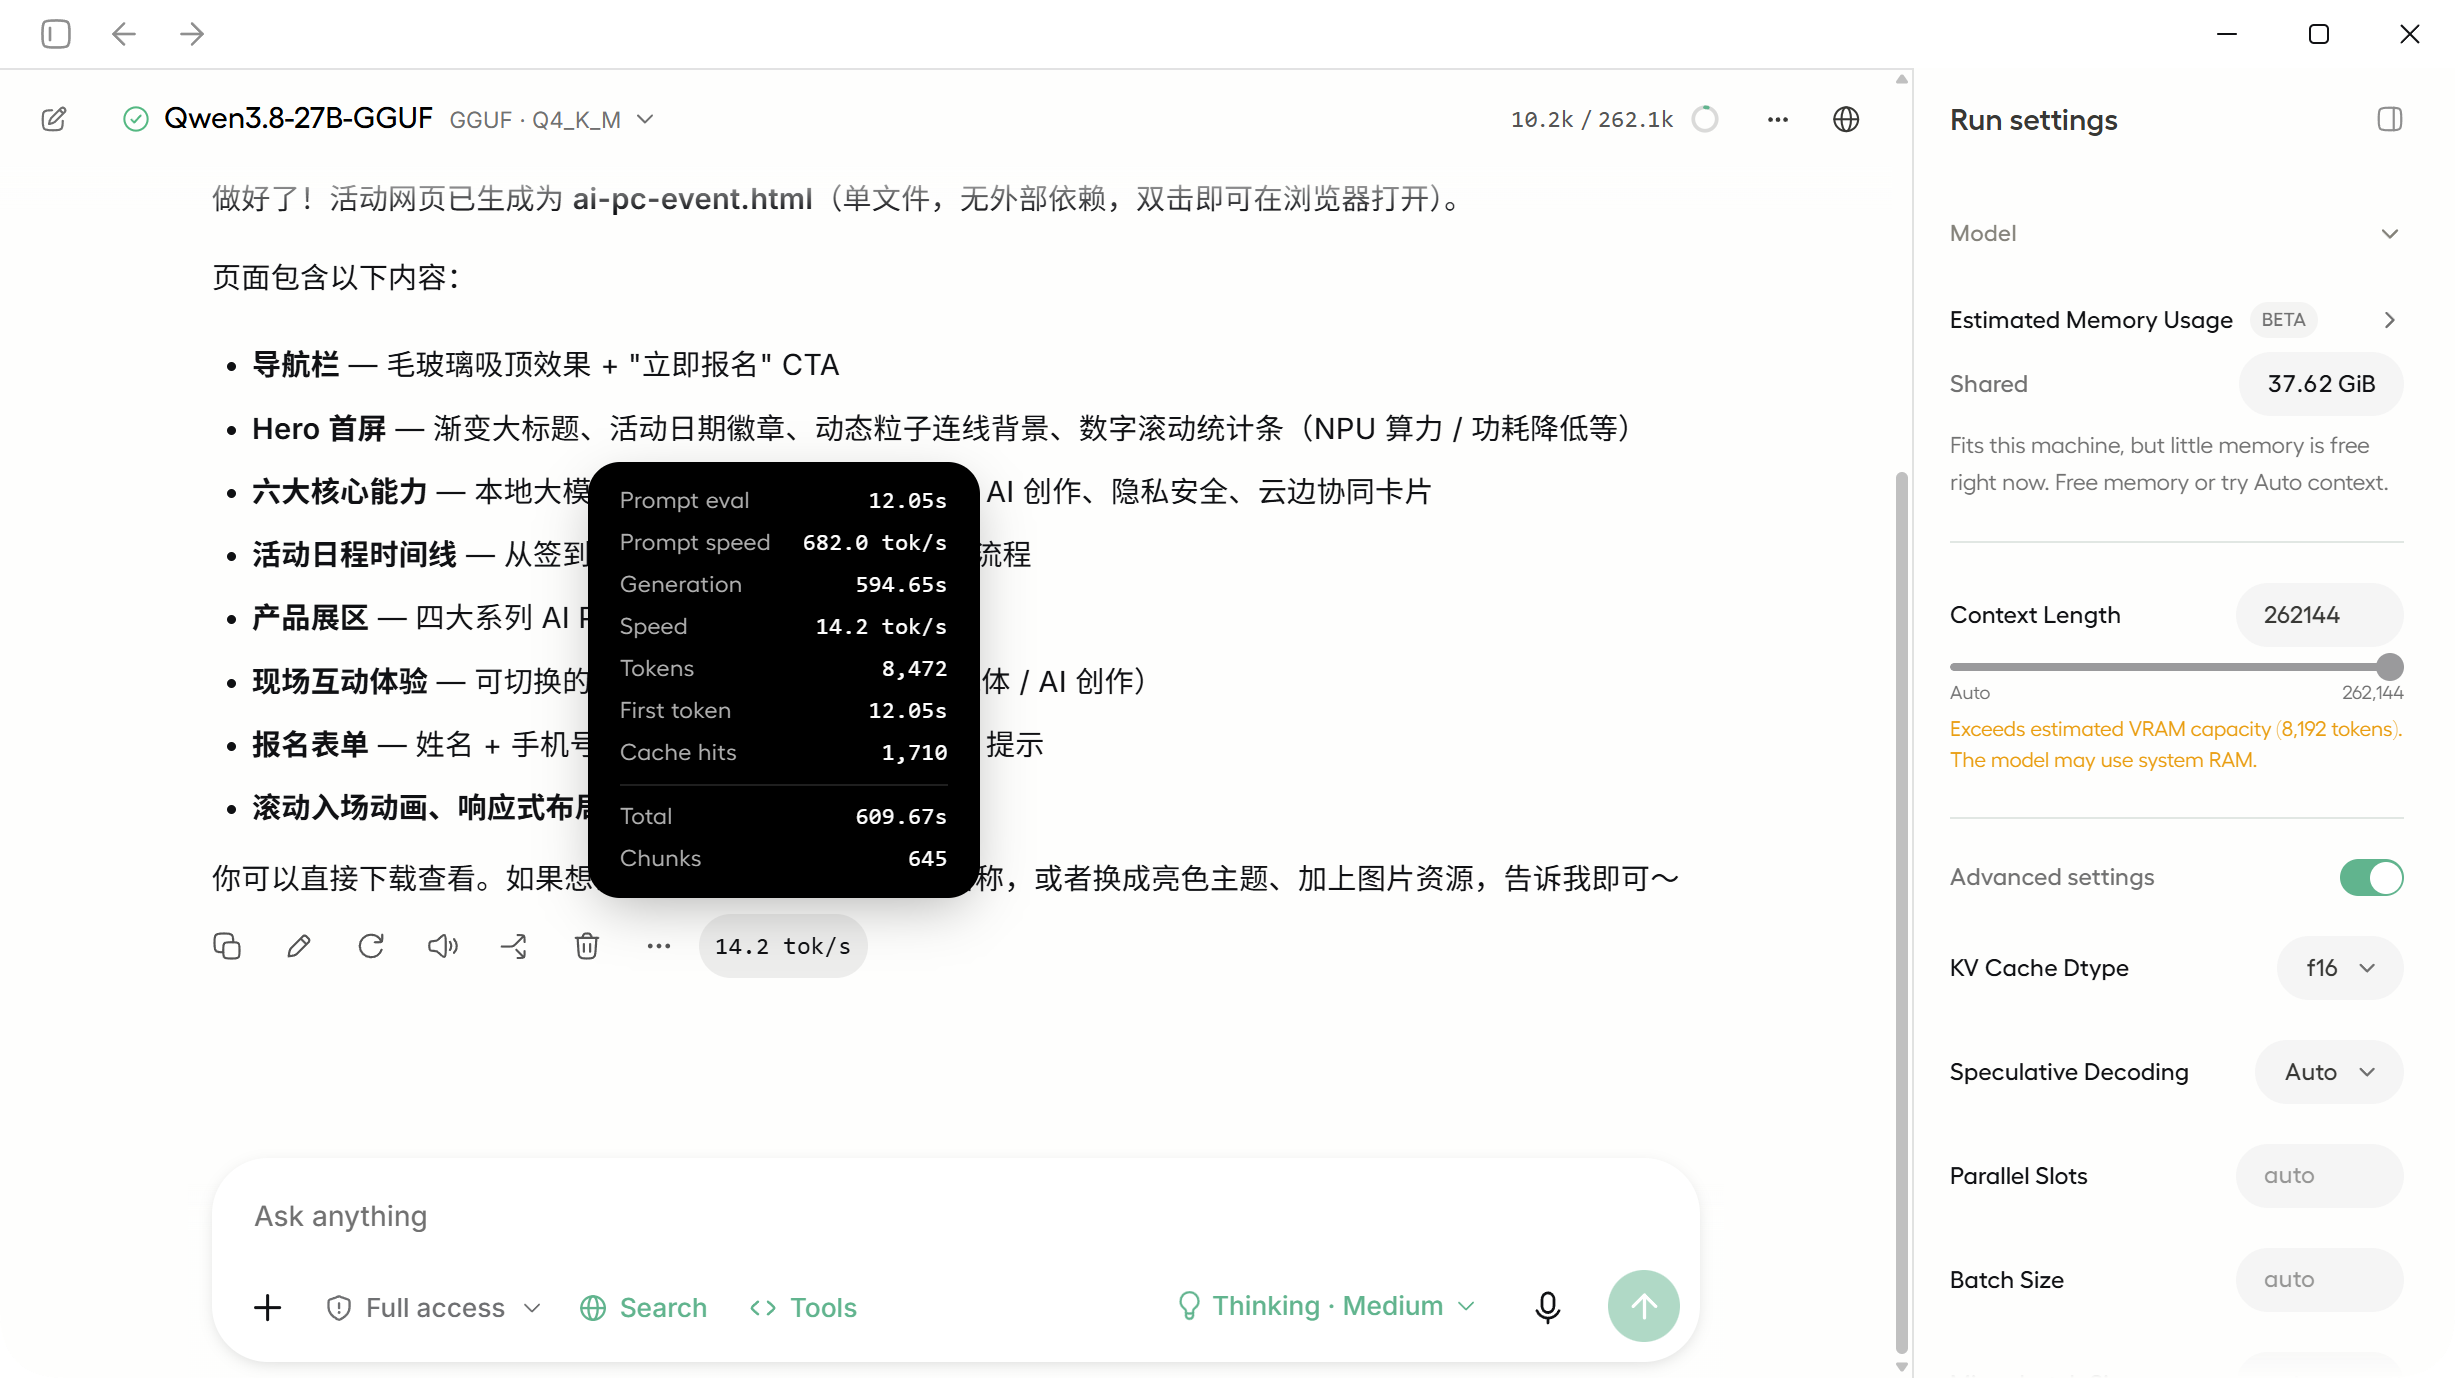
Como puede verse, la velocidad de generación de tokens se mantiene estable en torno a los 14 tokens/s, con el primer token tardando 12,05 segundos y un tiempo total de 609,67 segundos.
Para una memoria uniforme de 64 GB, un modelo con alrededor de 30 GB es probablemente la opción más adecuada para este tipo de ordenador.
Qwen3 32B (NVFP4) tiene una velocidad de inferencia de entre 55 y 60 tokens por segundo, lo que hace que las conversaciones cotidianas, la redacción de textos y la asistencia con el código sean completamente fluidas; al introducir documentos largos para resumirlos, no hay una degradación significativa en el contexto de cientos de miles de tokens.
WorkBuddy, mi inteligencia se refleja en 0 yuanes/mes
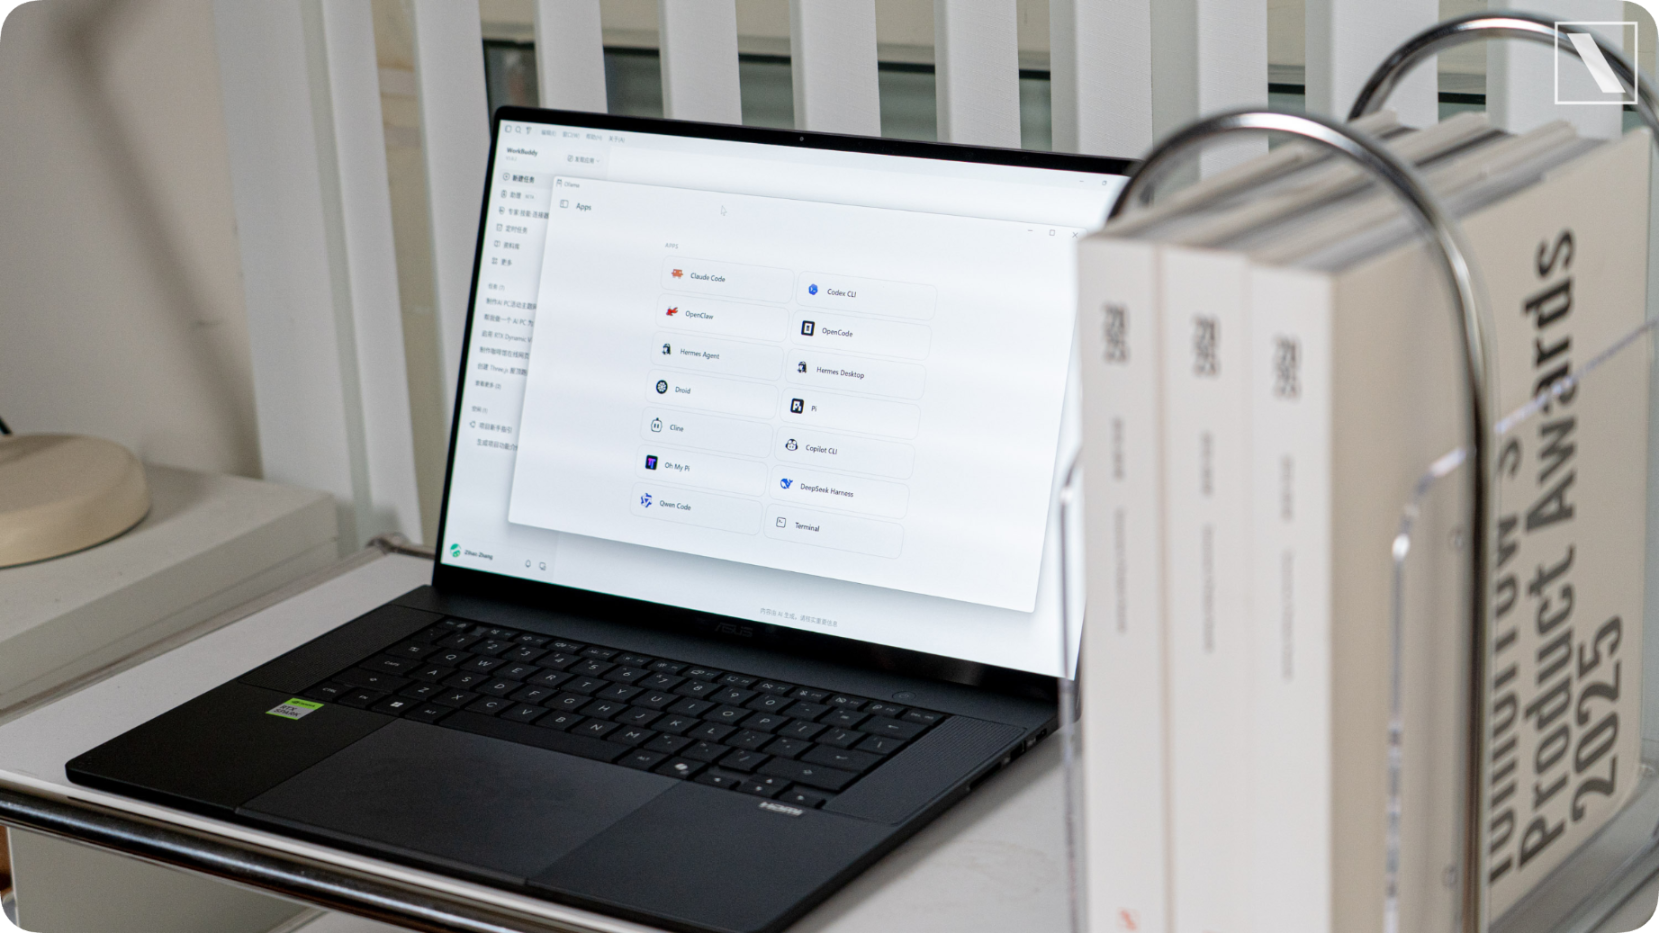
Aparte de su implementación local independiente, el aspecto más interesante de este PC con Windows es su integración con WorkBuddy.
Cuando abro WorkBuddy en mi MacBook Air, puedo ver que en la configuración del modelo solo aparece la opción "Modelo personalizado".
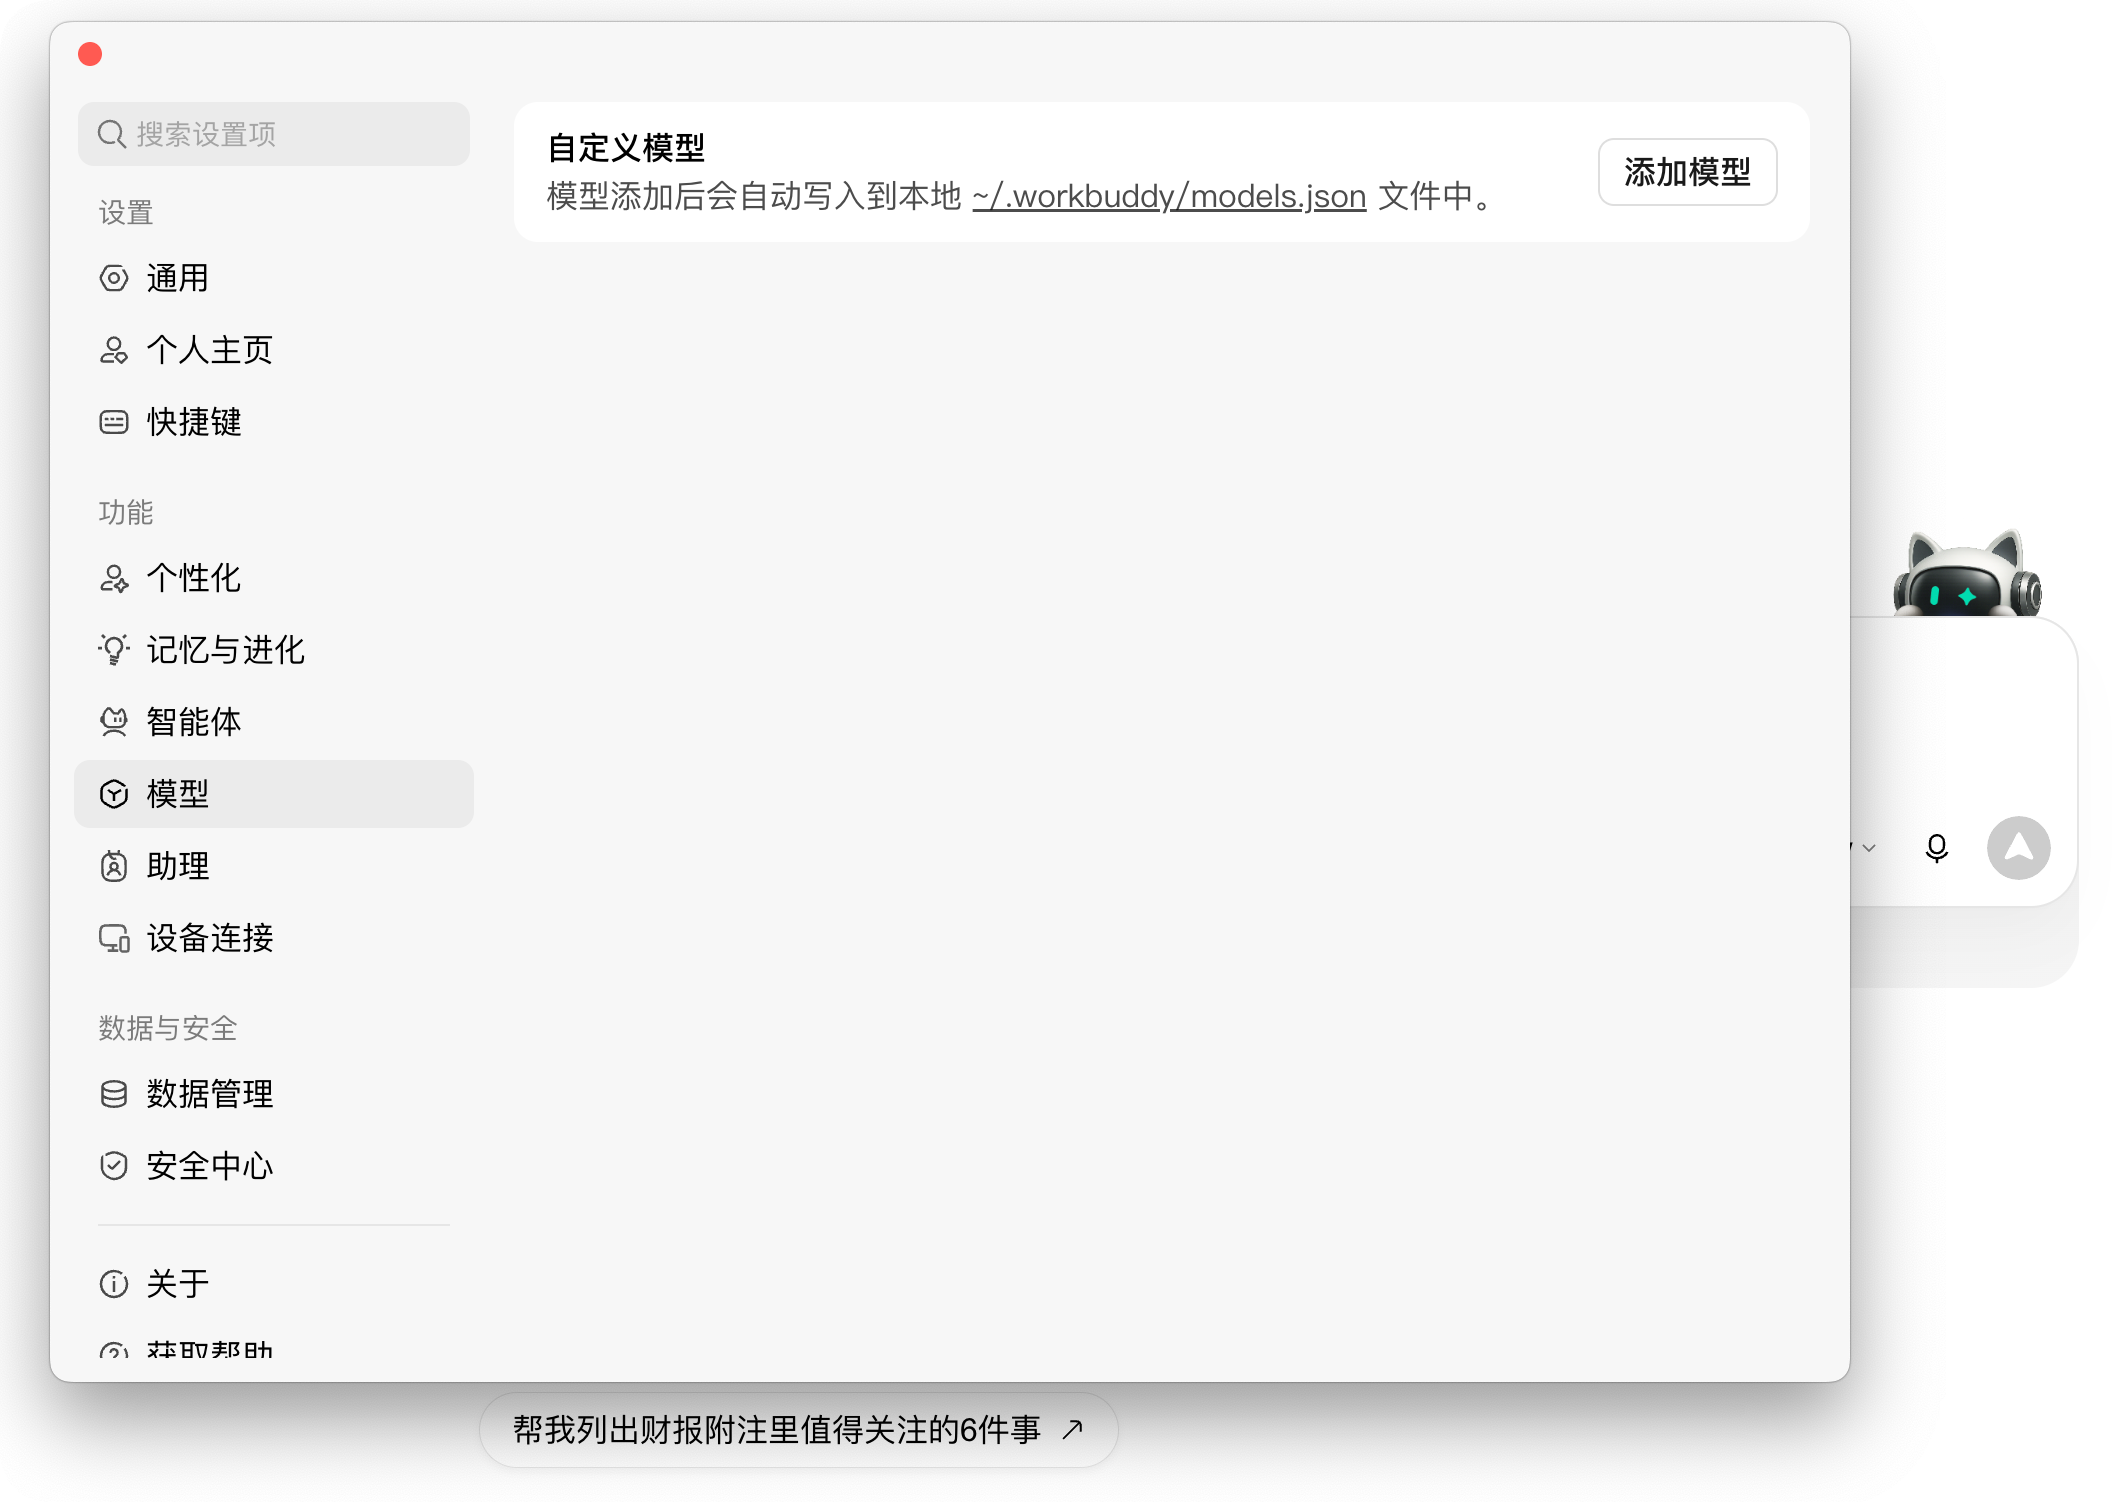
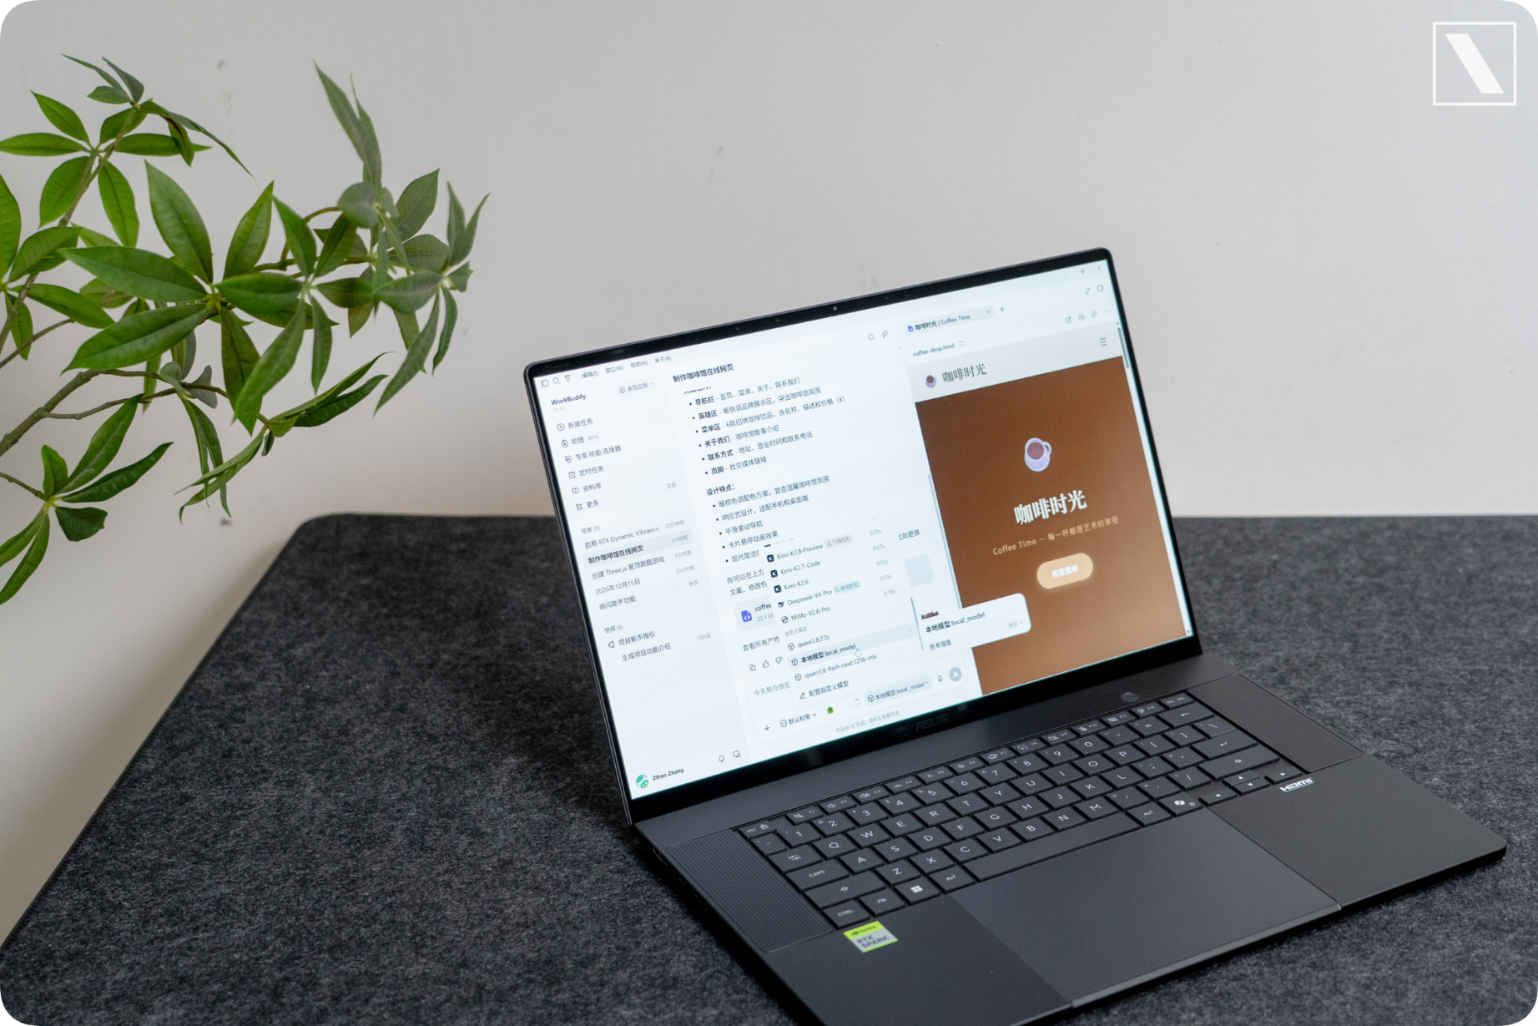
En este ASUS ProArt 16 RTX Spark, hay una función Beta adicional que nos permite descargar y administrar directamente los modelos de IA que se ejecutan localmente.
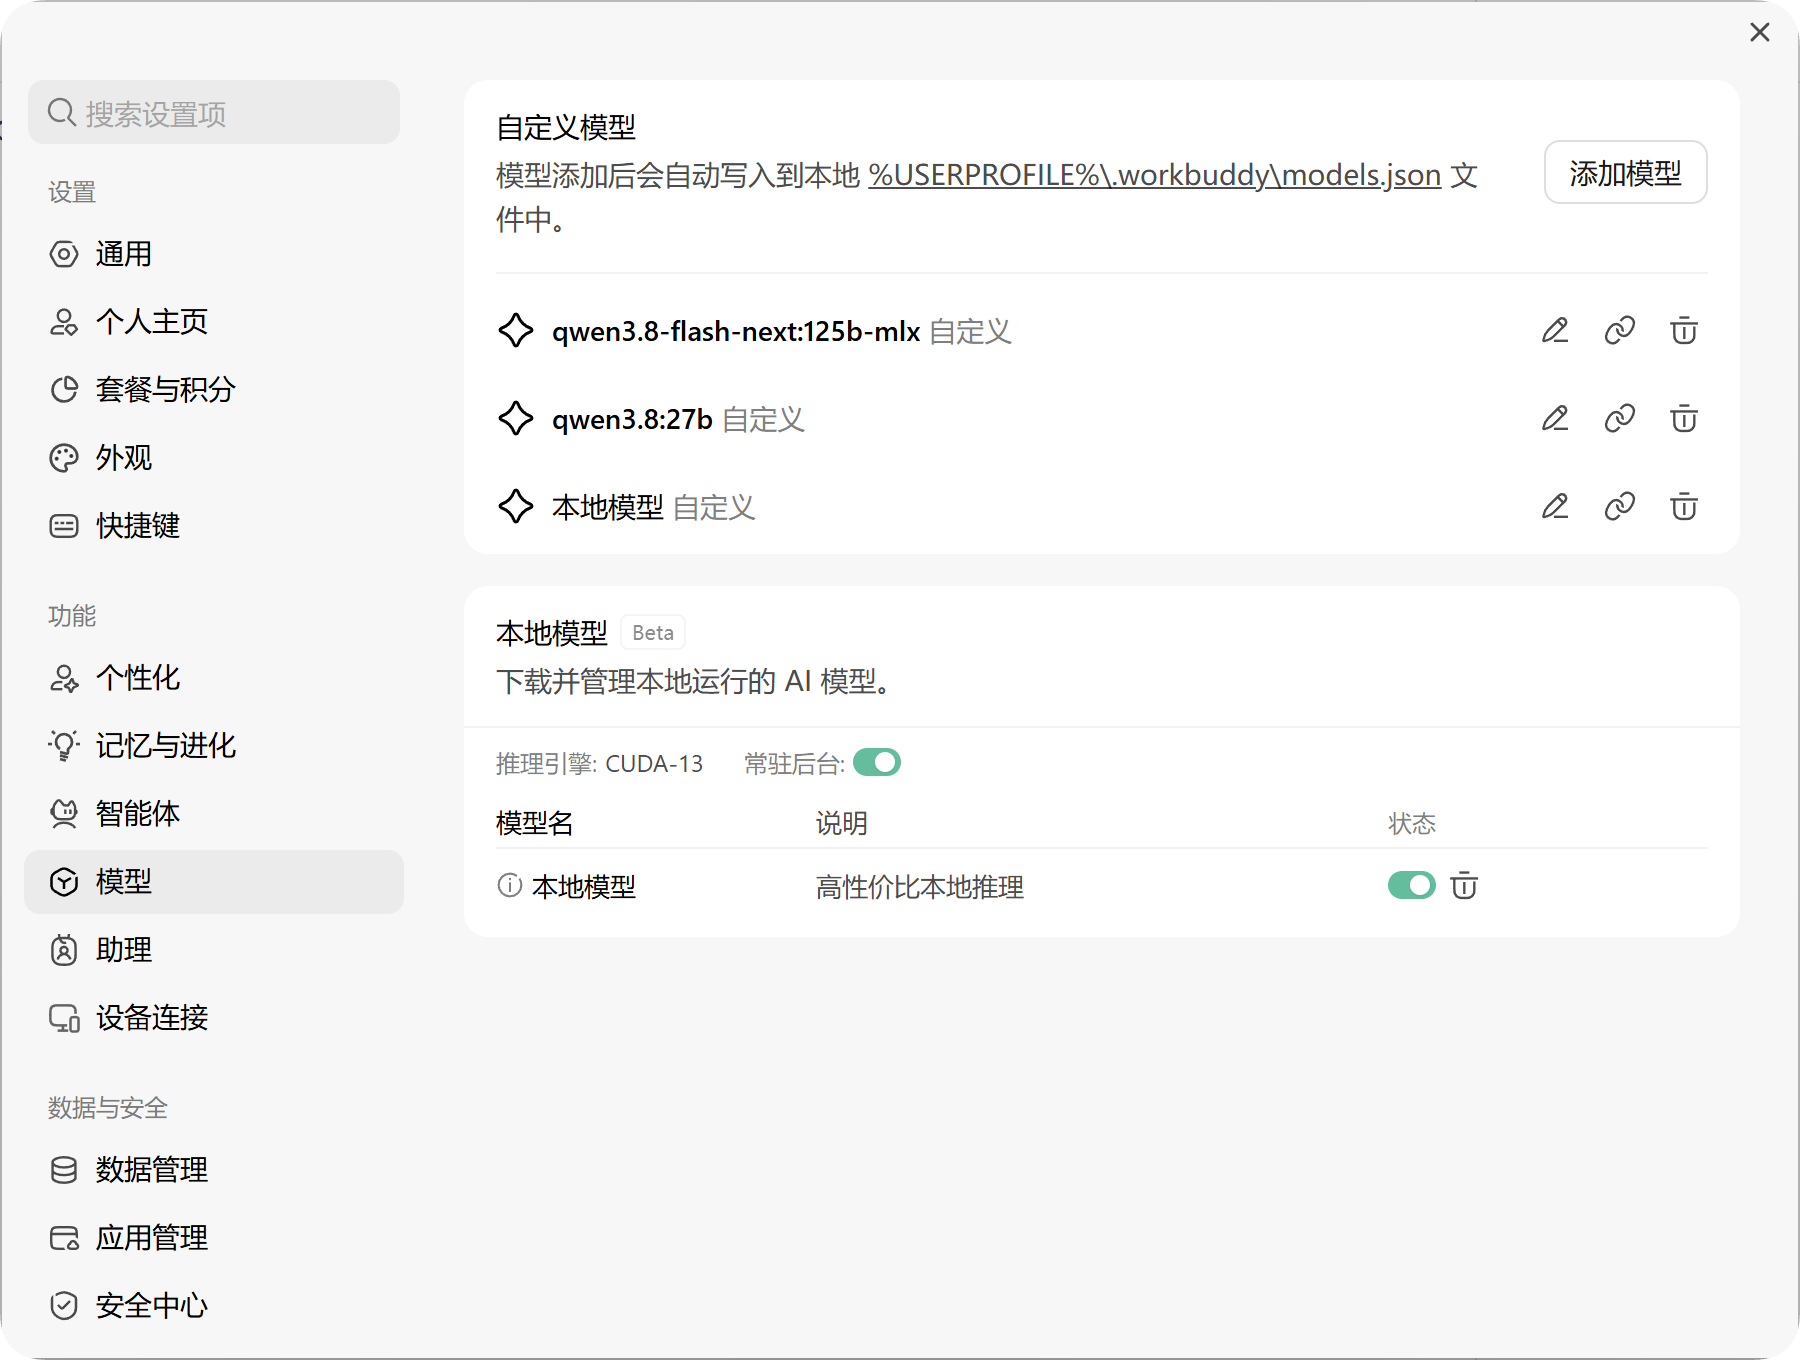
Tras hacer clic en Descargar, el ordenador comenzará automáticamente a descargar el modelo y a resolver las reglas de implementación local correspondientes. Solo necesitamos habilitarlo y mantenerlo ejecutándose en segundo plano. Después, podemos volver a la interfaz de tareas de WorkBuddy y seleccionar el modelo local para iniciar una conversación.
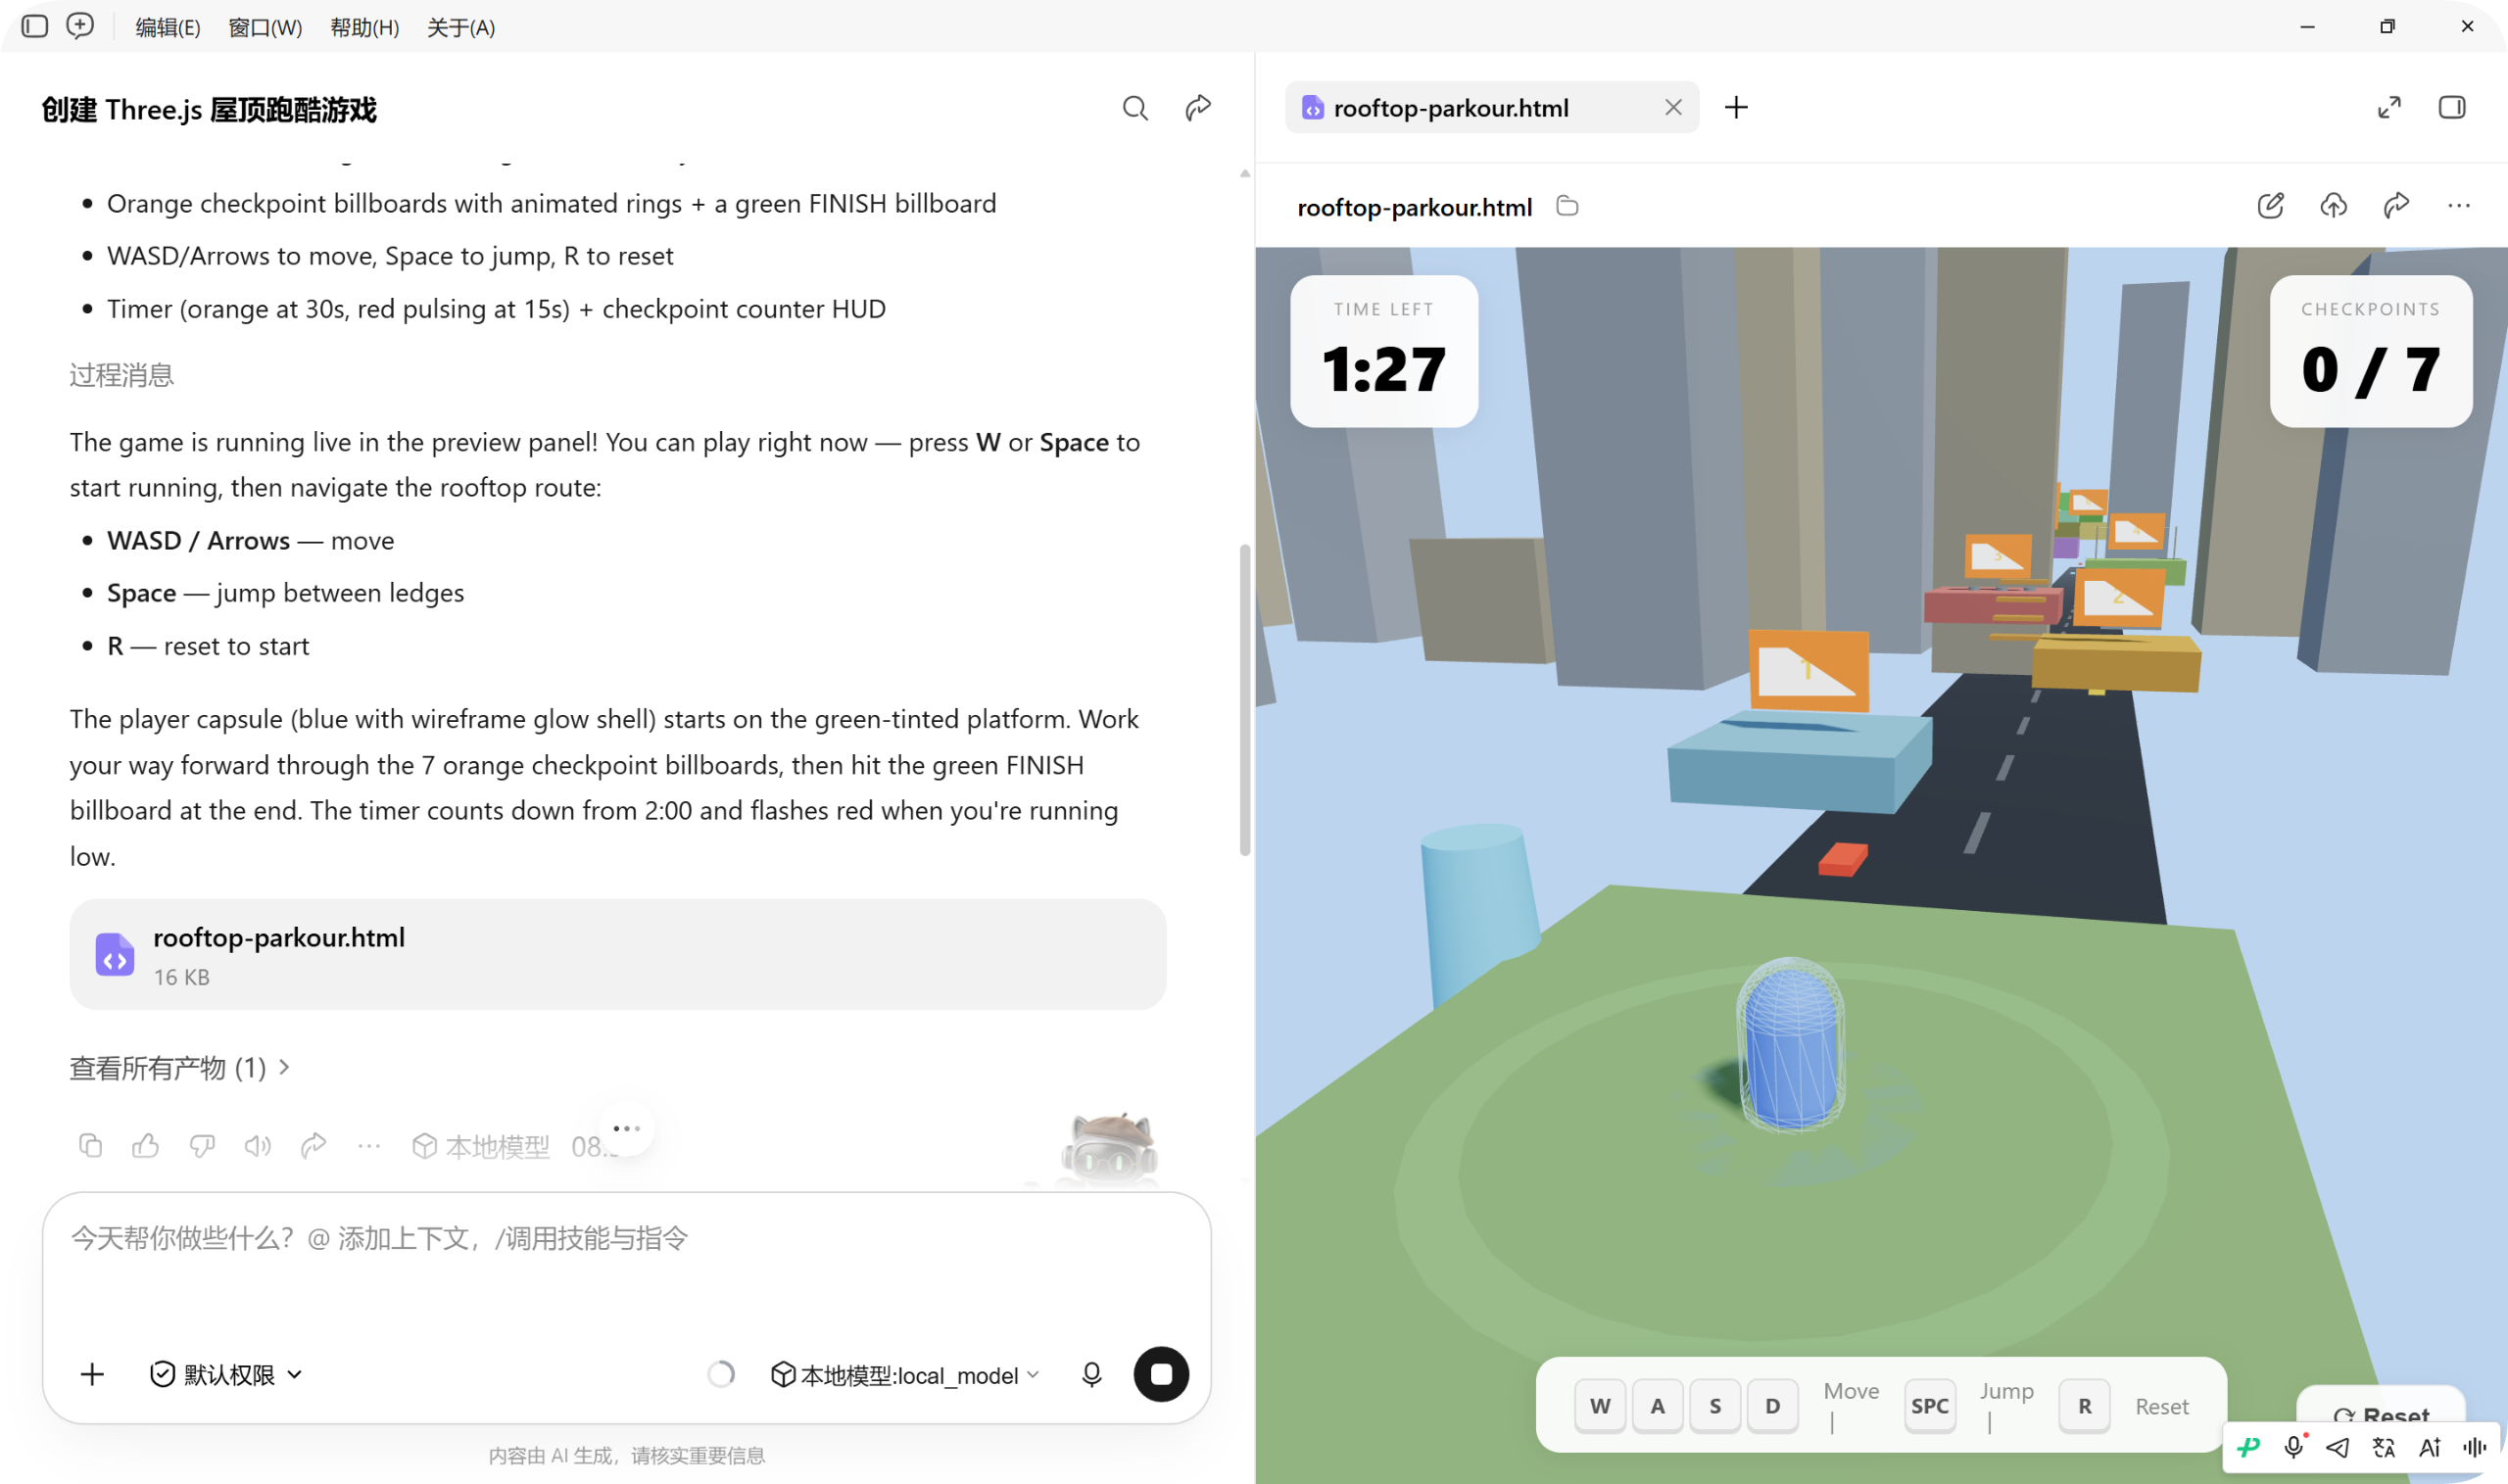
El juego de azotea de Three.js que vimos anteriormente ahora se puede implementar con WorkBuddy. Si bien el resultado puede no ser tan impresionante como el de los modelos más avanzados, vale la pena probarlo para la validación preliminar del proyecto y las pruebas de viabilidad.
La tarea completa duró 13 minutos y 59 segundos, lo que probablemente sea incluso menos tiempo que utilizando el modelo en la nube de WorkBuddy.
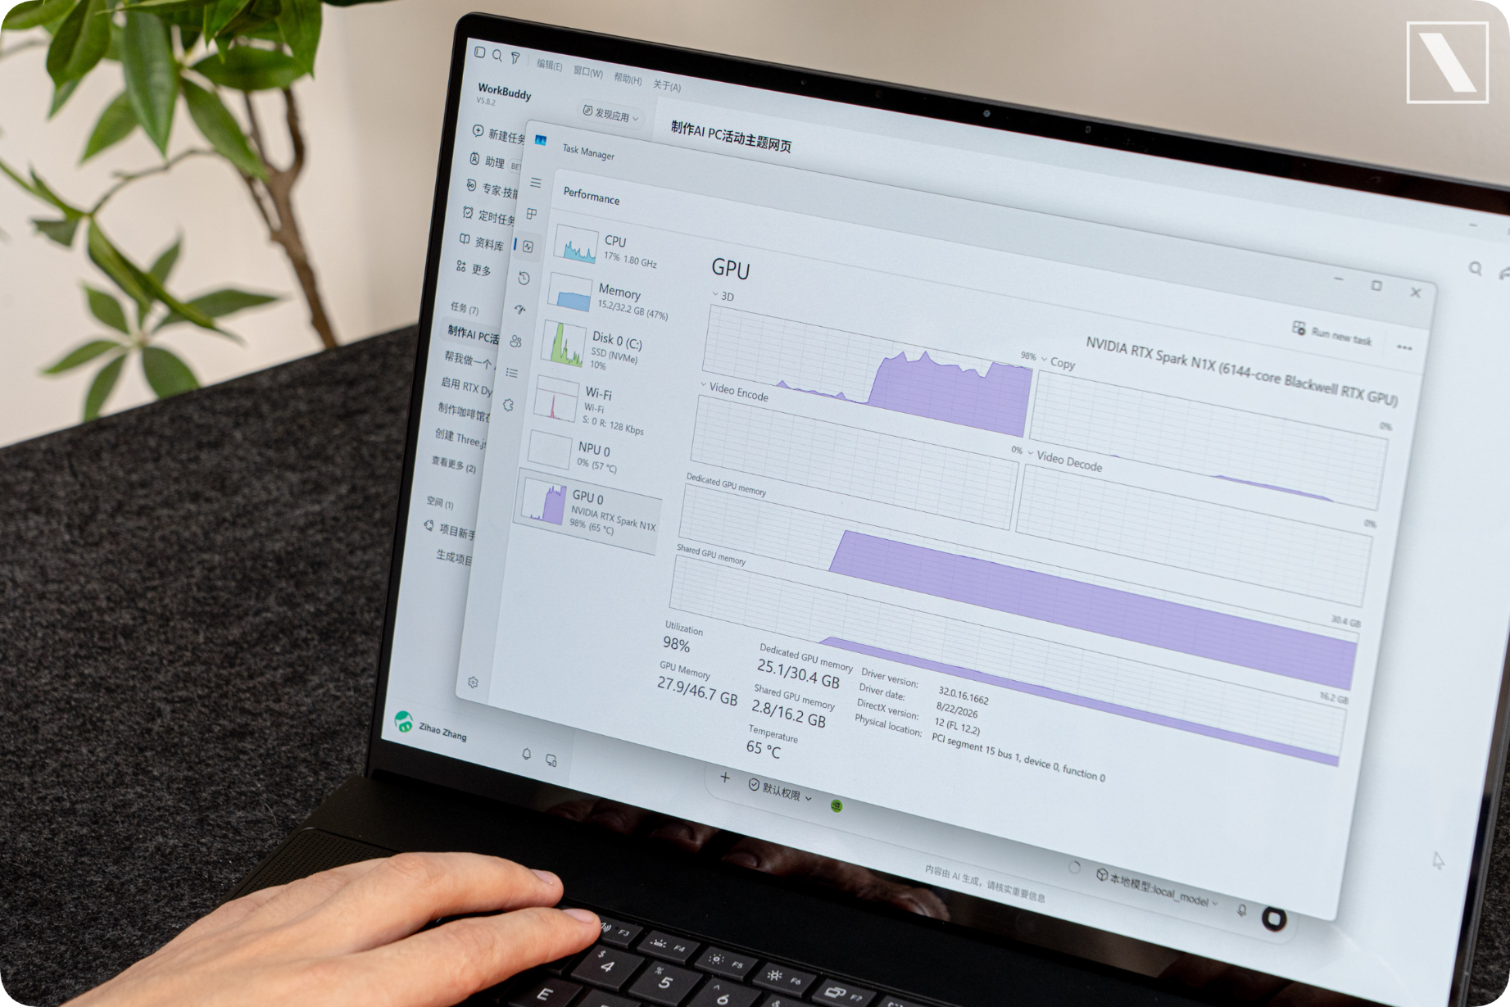
También se puede observar en el Administrador de tareas, en la sección Rendimiento, que el uso de la GPU ha comenzado a aumentar hasta el 100%, y el ruido del ventilador también es bastante notable.
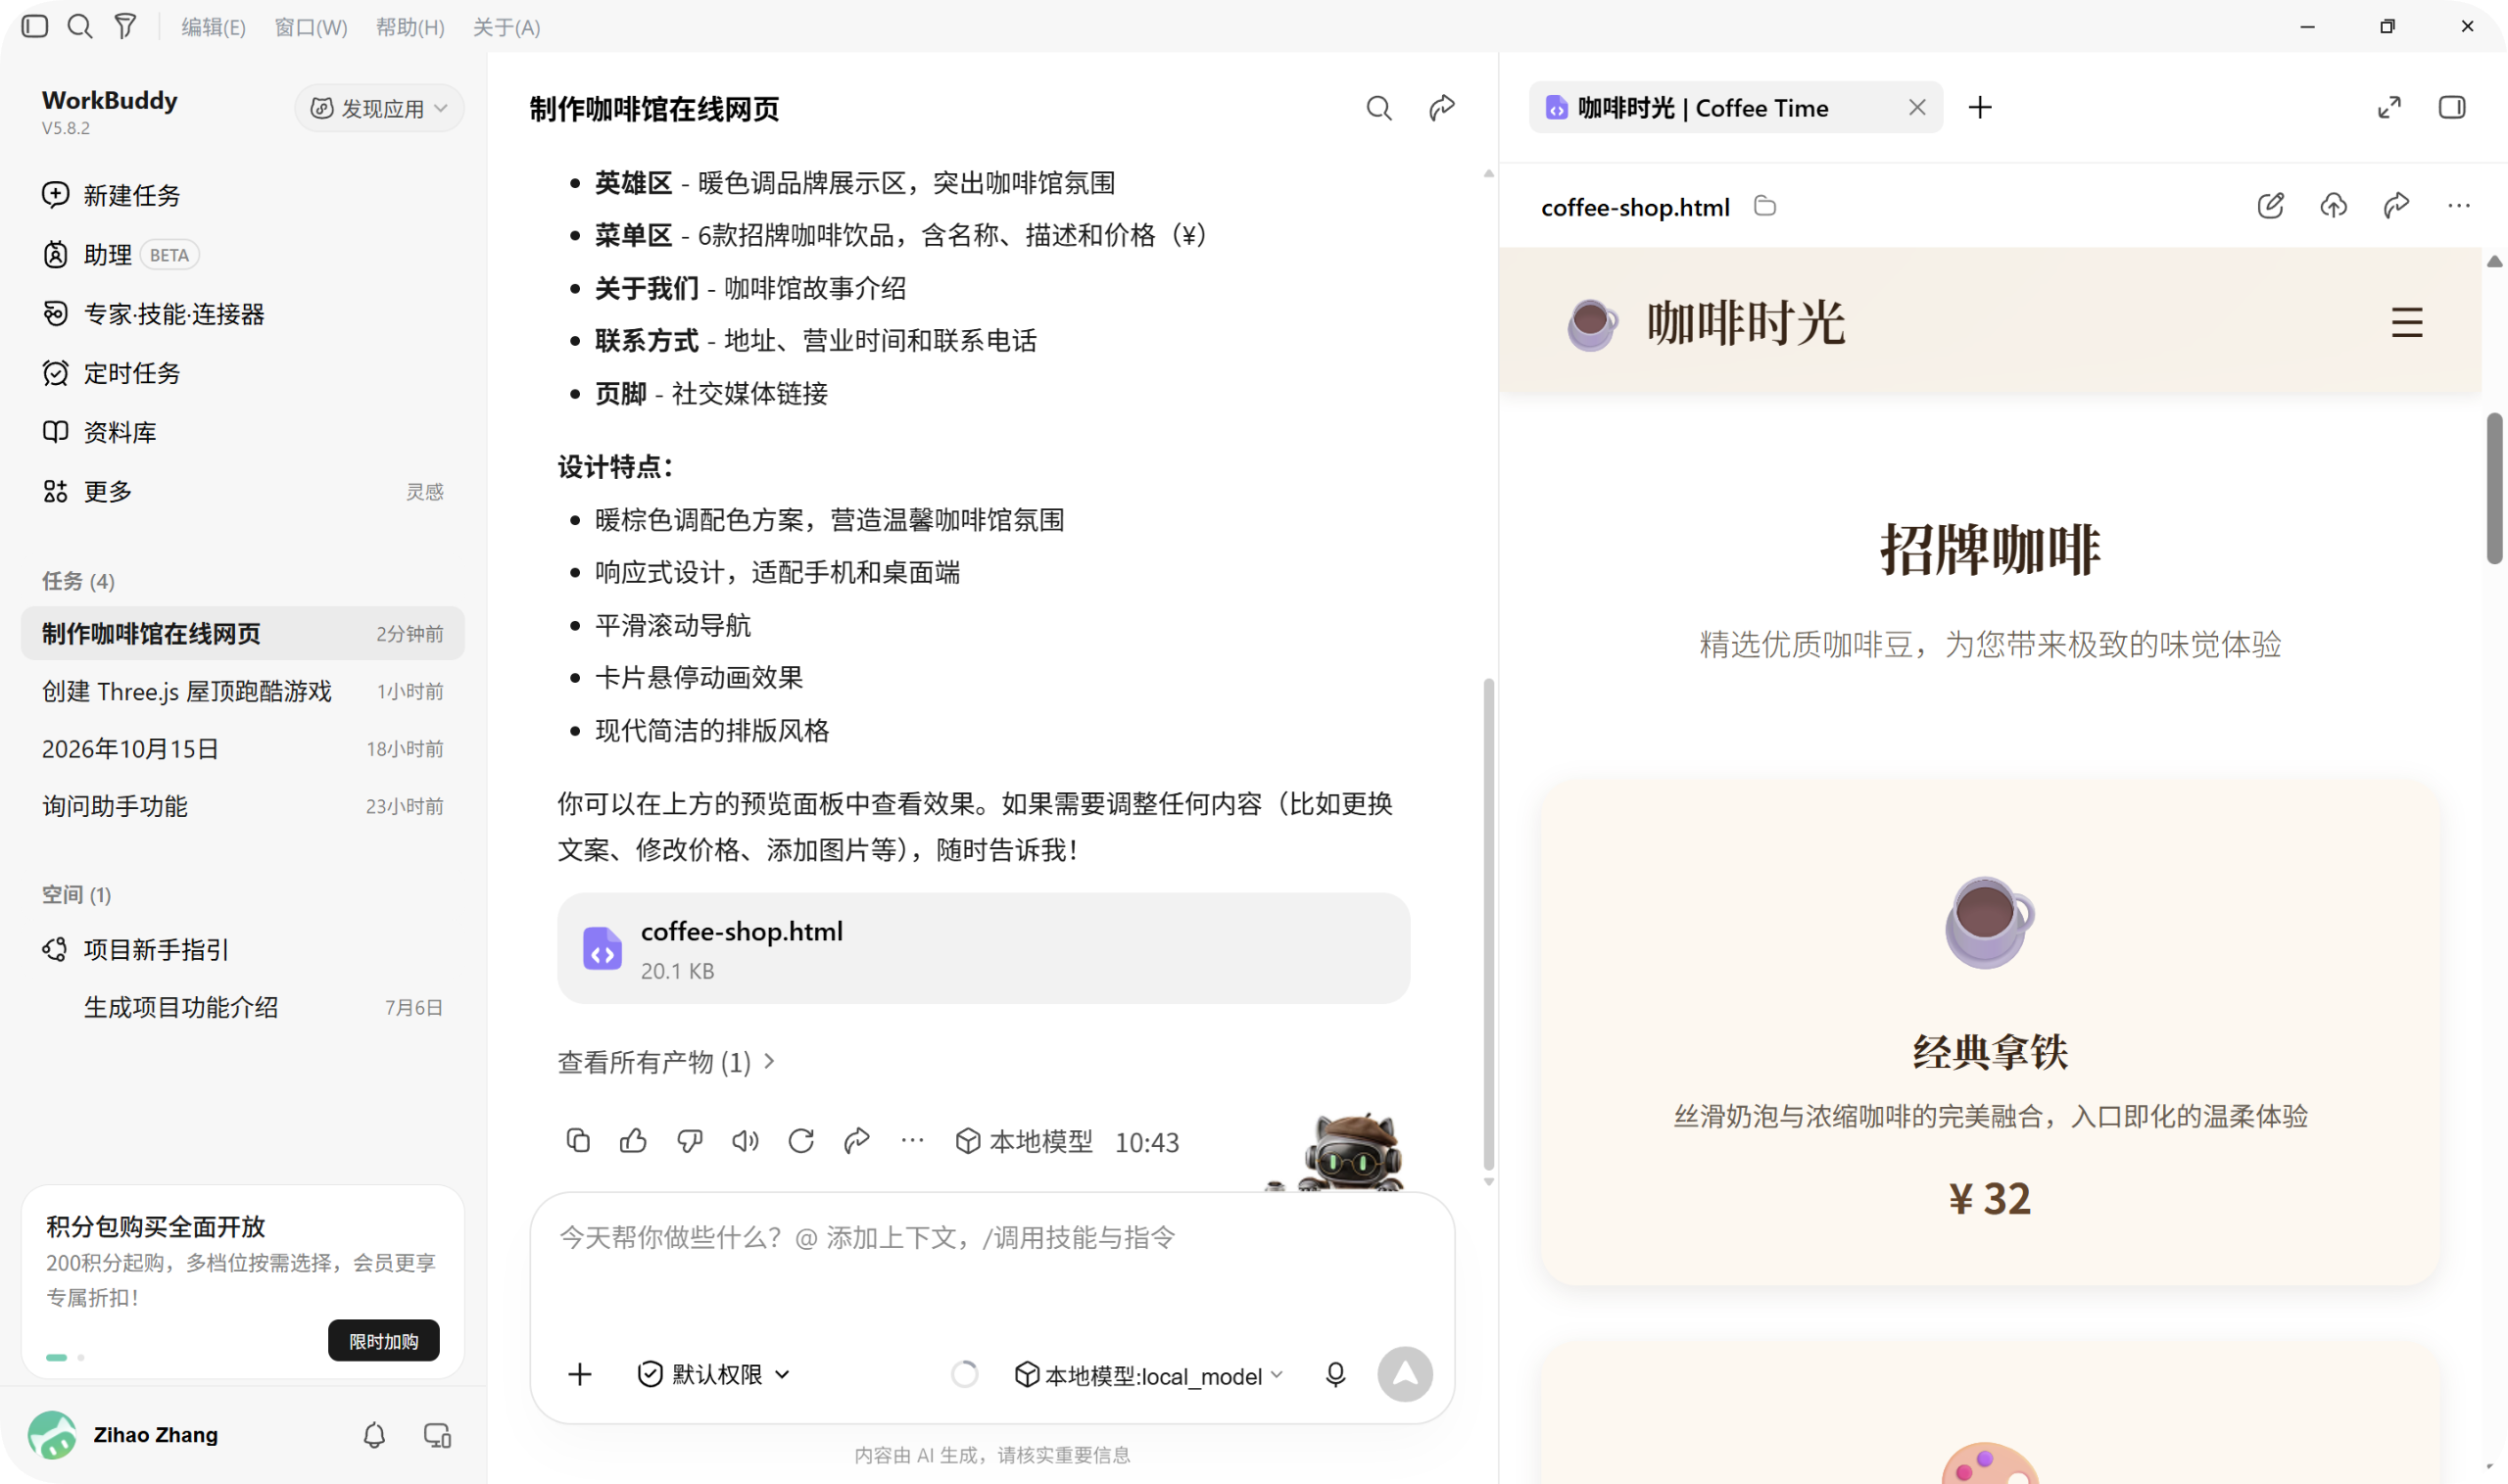
Aunque WorkBuddy no nos indica directamente de qué fabricante procede este modelo local, una simple conversación con él revela la información relevante en el encabezado del archivo del modelo.
Este modelo es un modelo local optimizado por Tencent, un modelo MoE con 50 mil millones de parámetros, un tamaño de modelo de 16 GB y acelerado mediante CUDA 13, lo que permite lograr una velocidad de inferencia más fluida en la GPU.
Gracias a las capacidades del modelo local optimizado de Tencent, también podemos identificar tareas más adecuadas para este modelo. Combinado con las funcionalidades del paquete Harness de WorkBuddy, ofrece un buen rendimiento para tareas de oficina cotidianas sencillas, como análisis de datos, visualización de datos, elaboración de informes y otras tareas tediosas.
En el futuro, gracias a la cooperación entre software y hardware, y a la tendencia actual de que los modelos de código abierto superen a los de código cerrado, así como al desarrollo de modelos Flash más rápidos y compactos, sin duda habrá más de un modelo local que se pueda descargar directamente desde WorkBuddy.
Actualmente, también podemos cargar modelos locales descargados de LM Studio en WorkBuddy a través de la API de modelos locales de LM Studio.
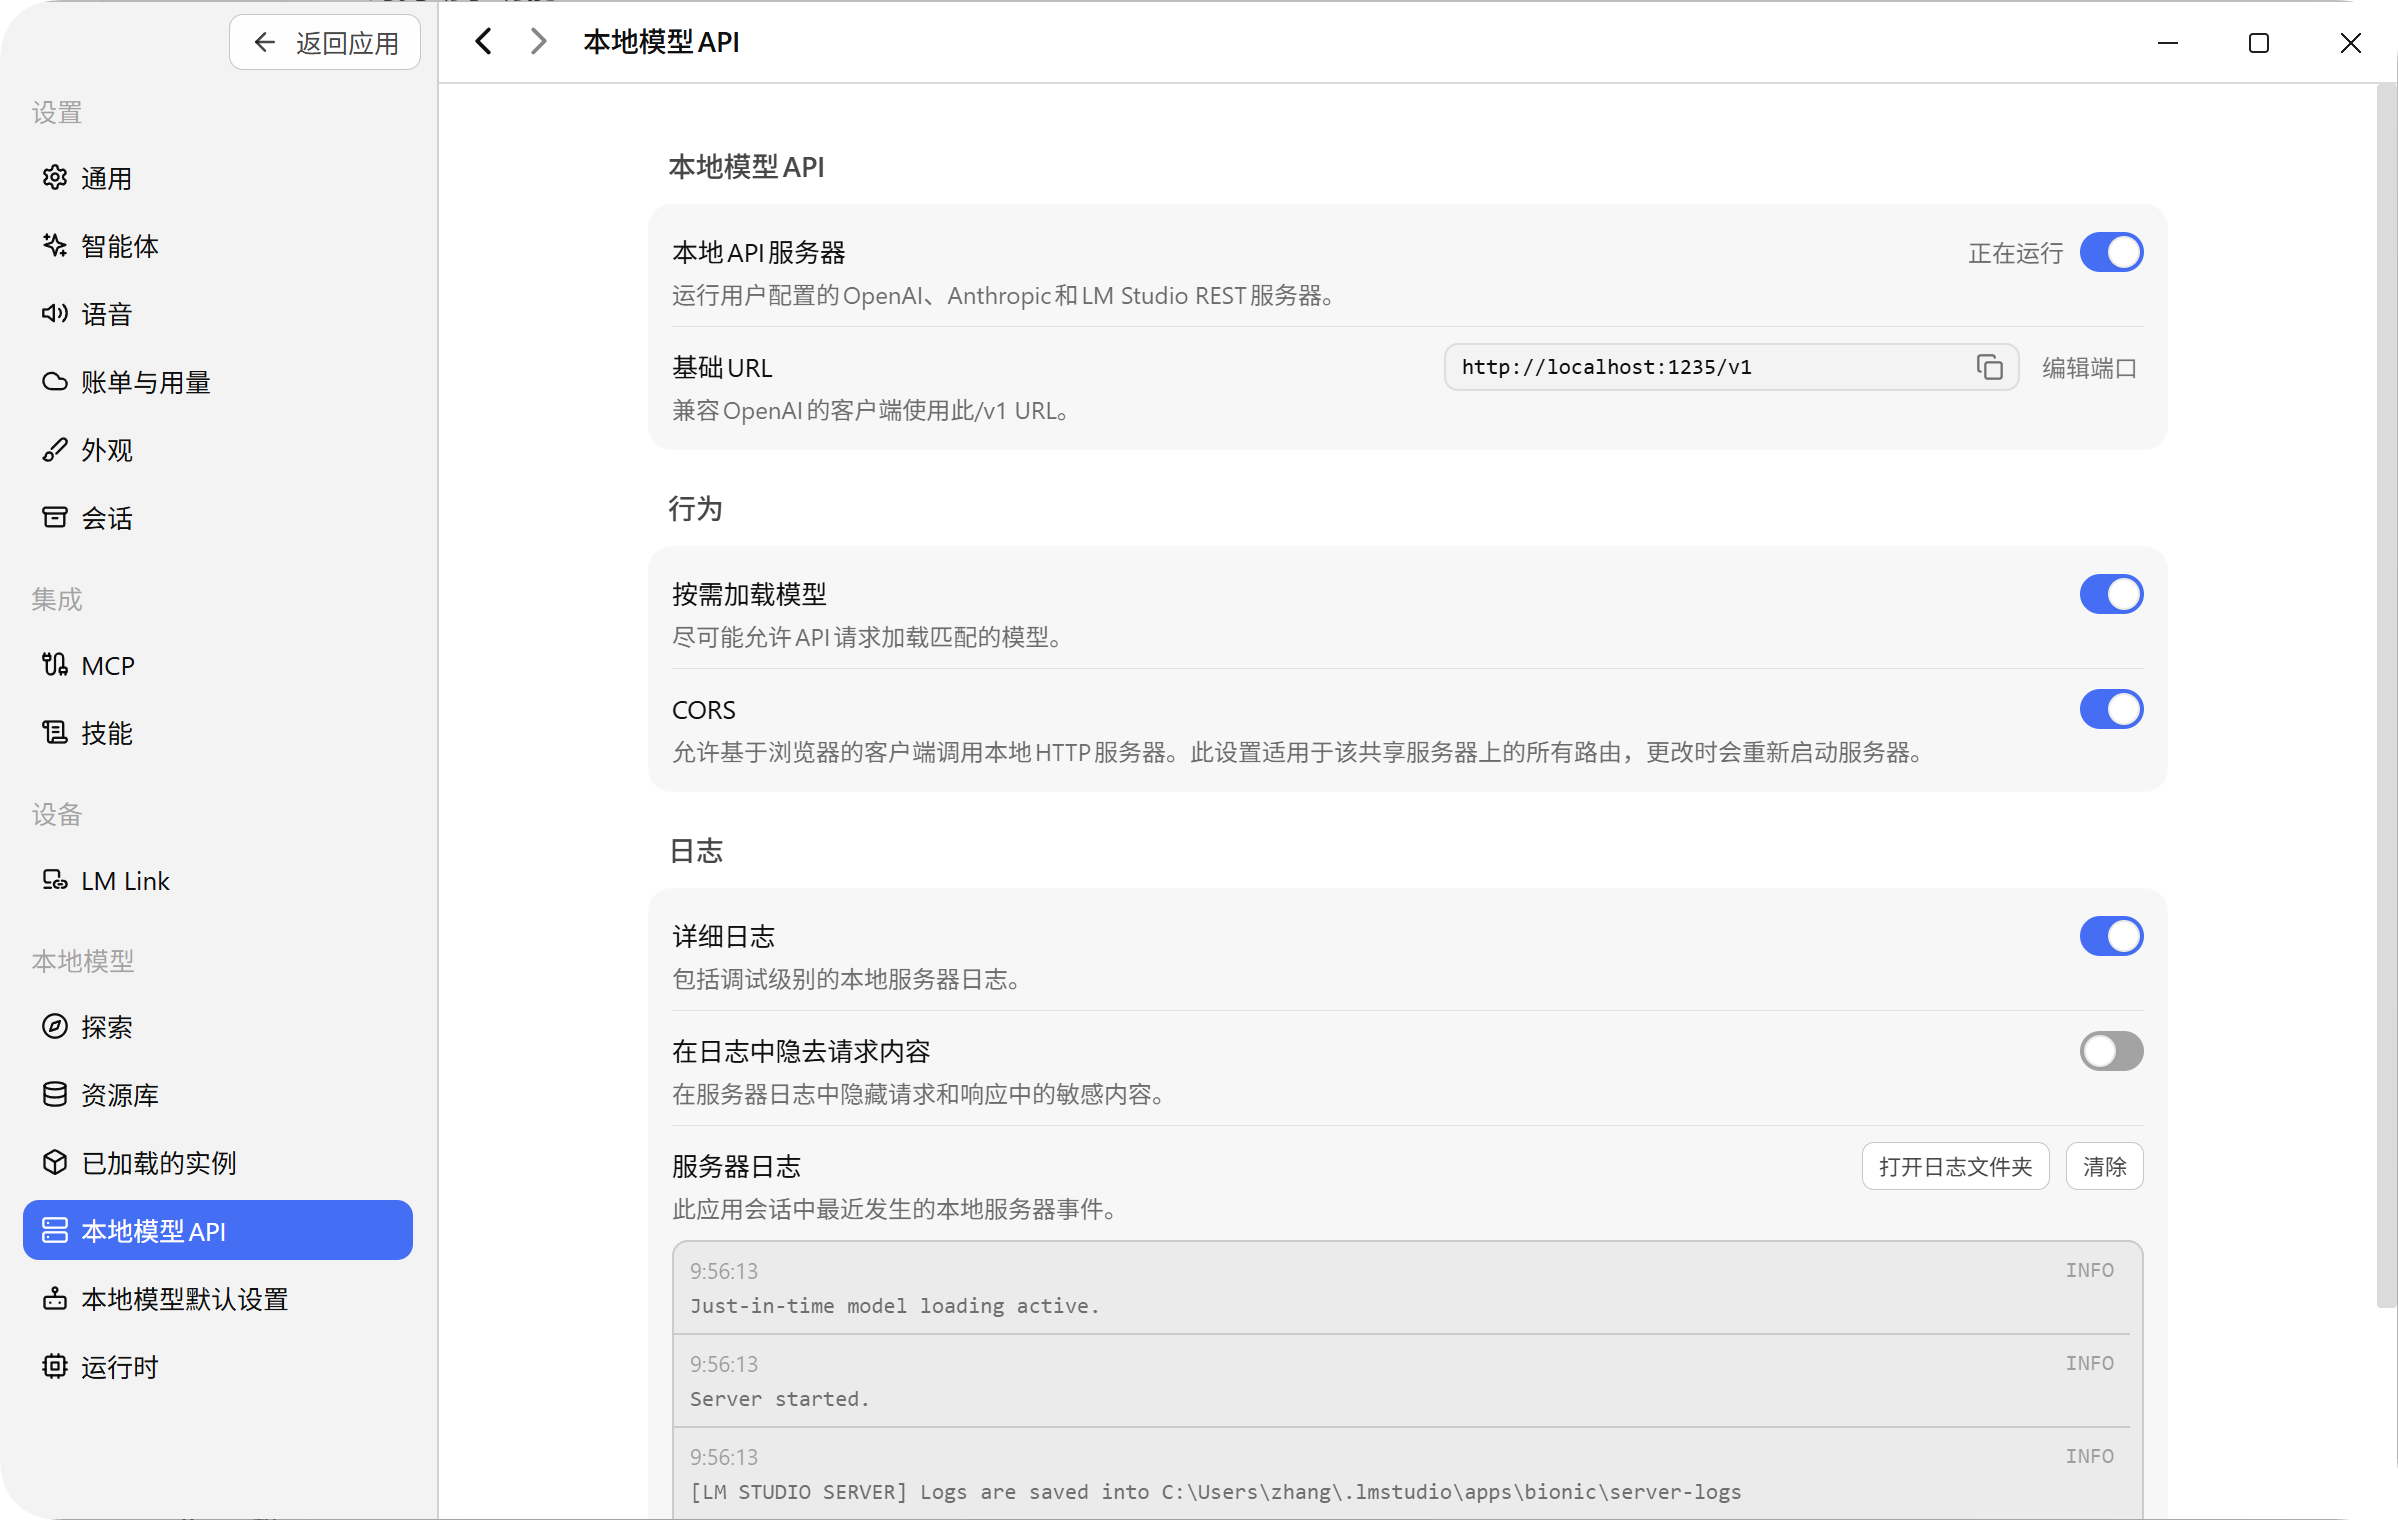
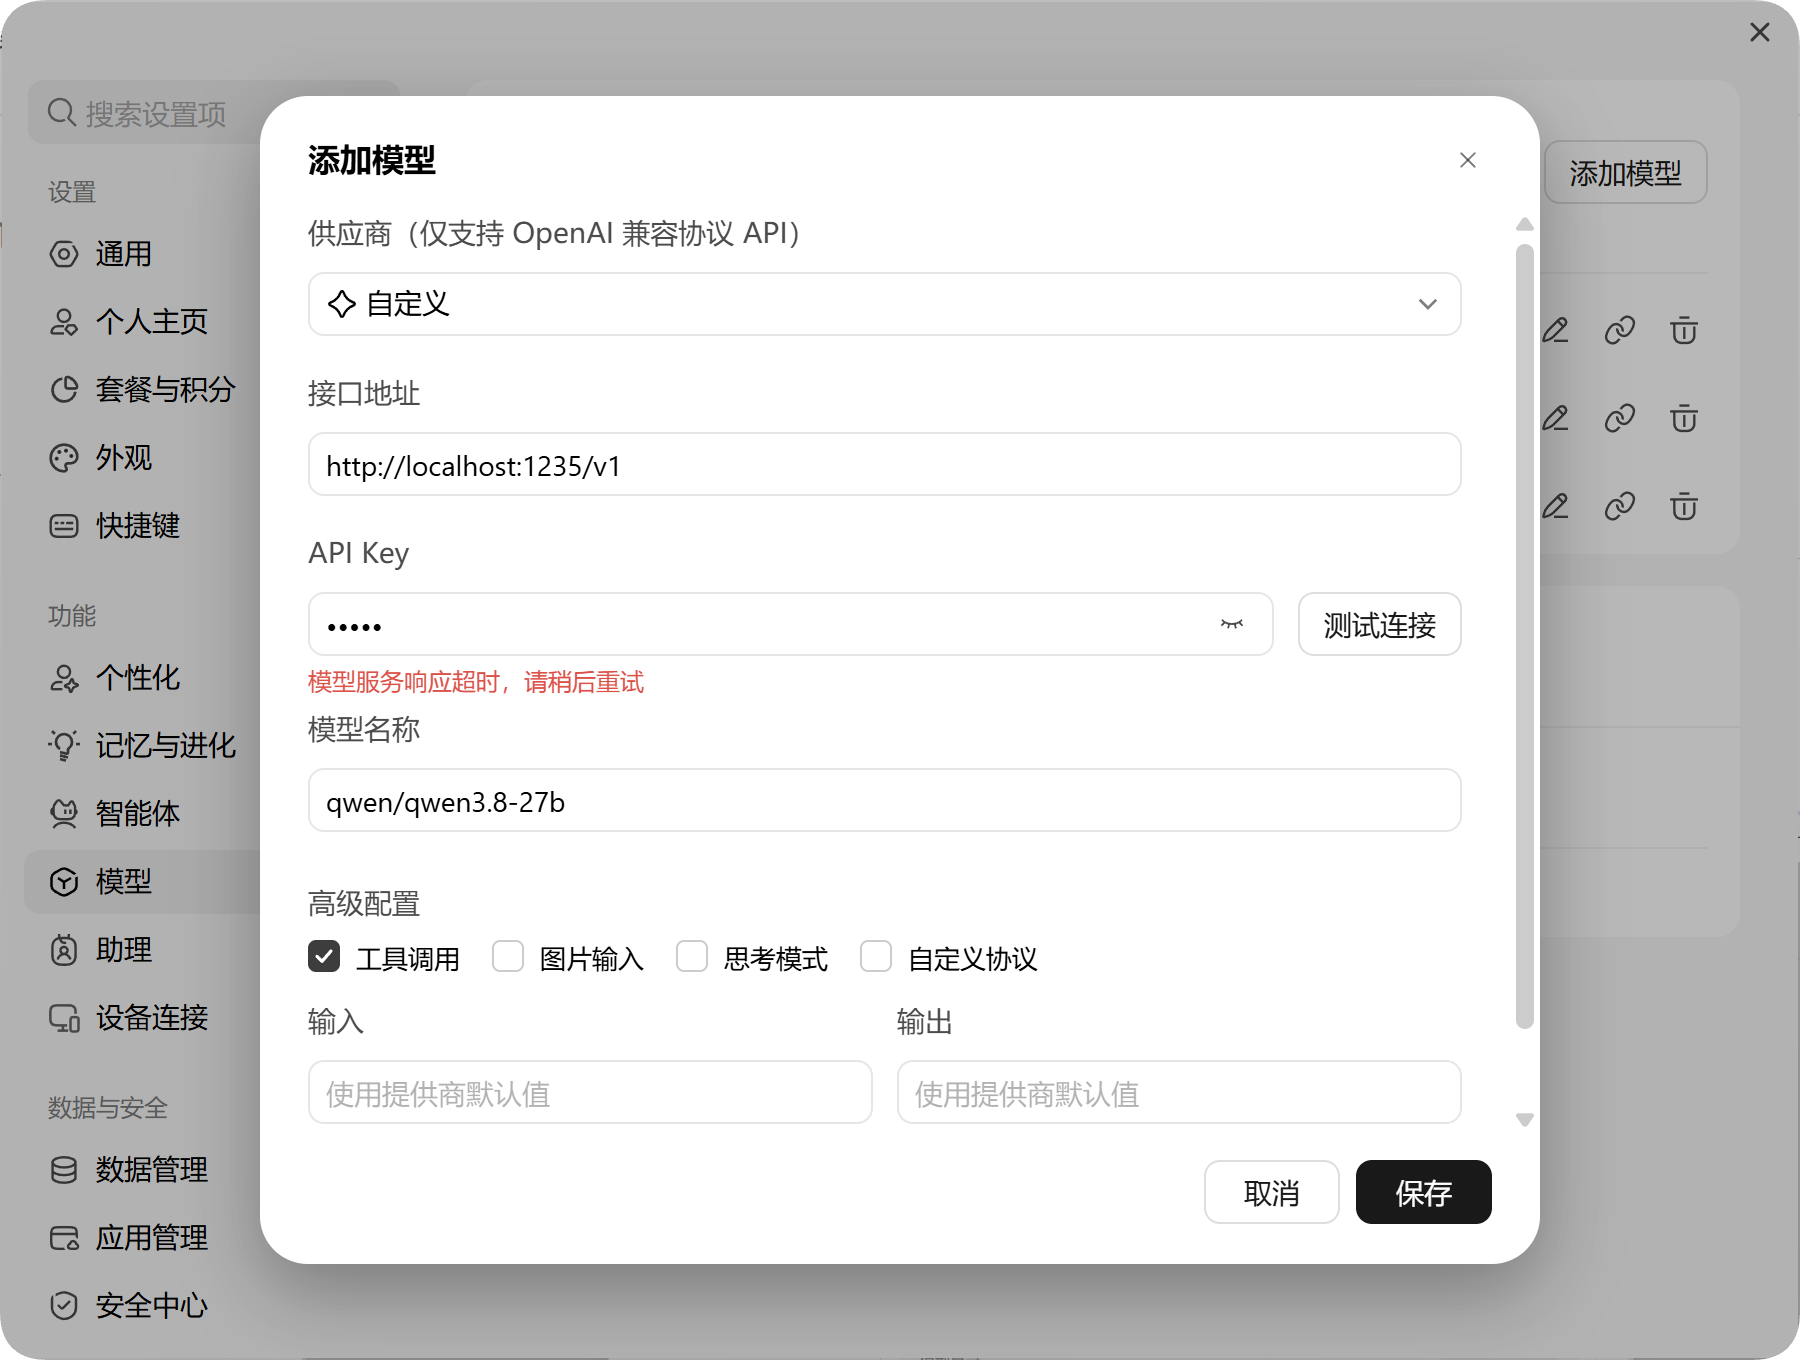
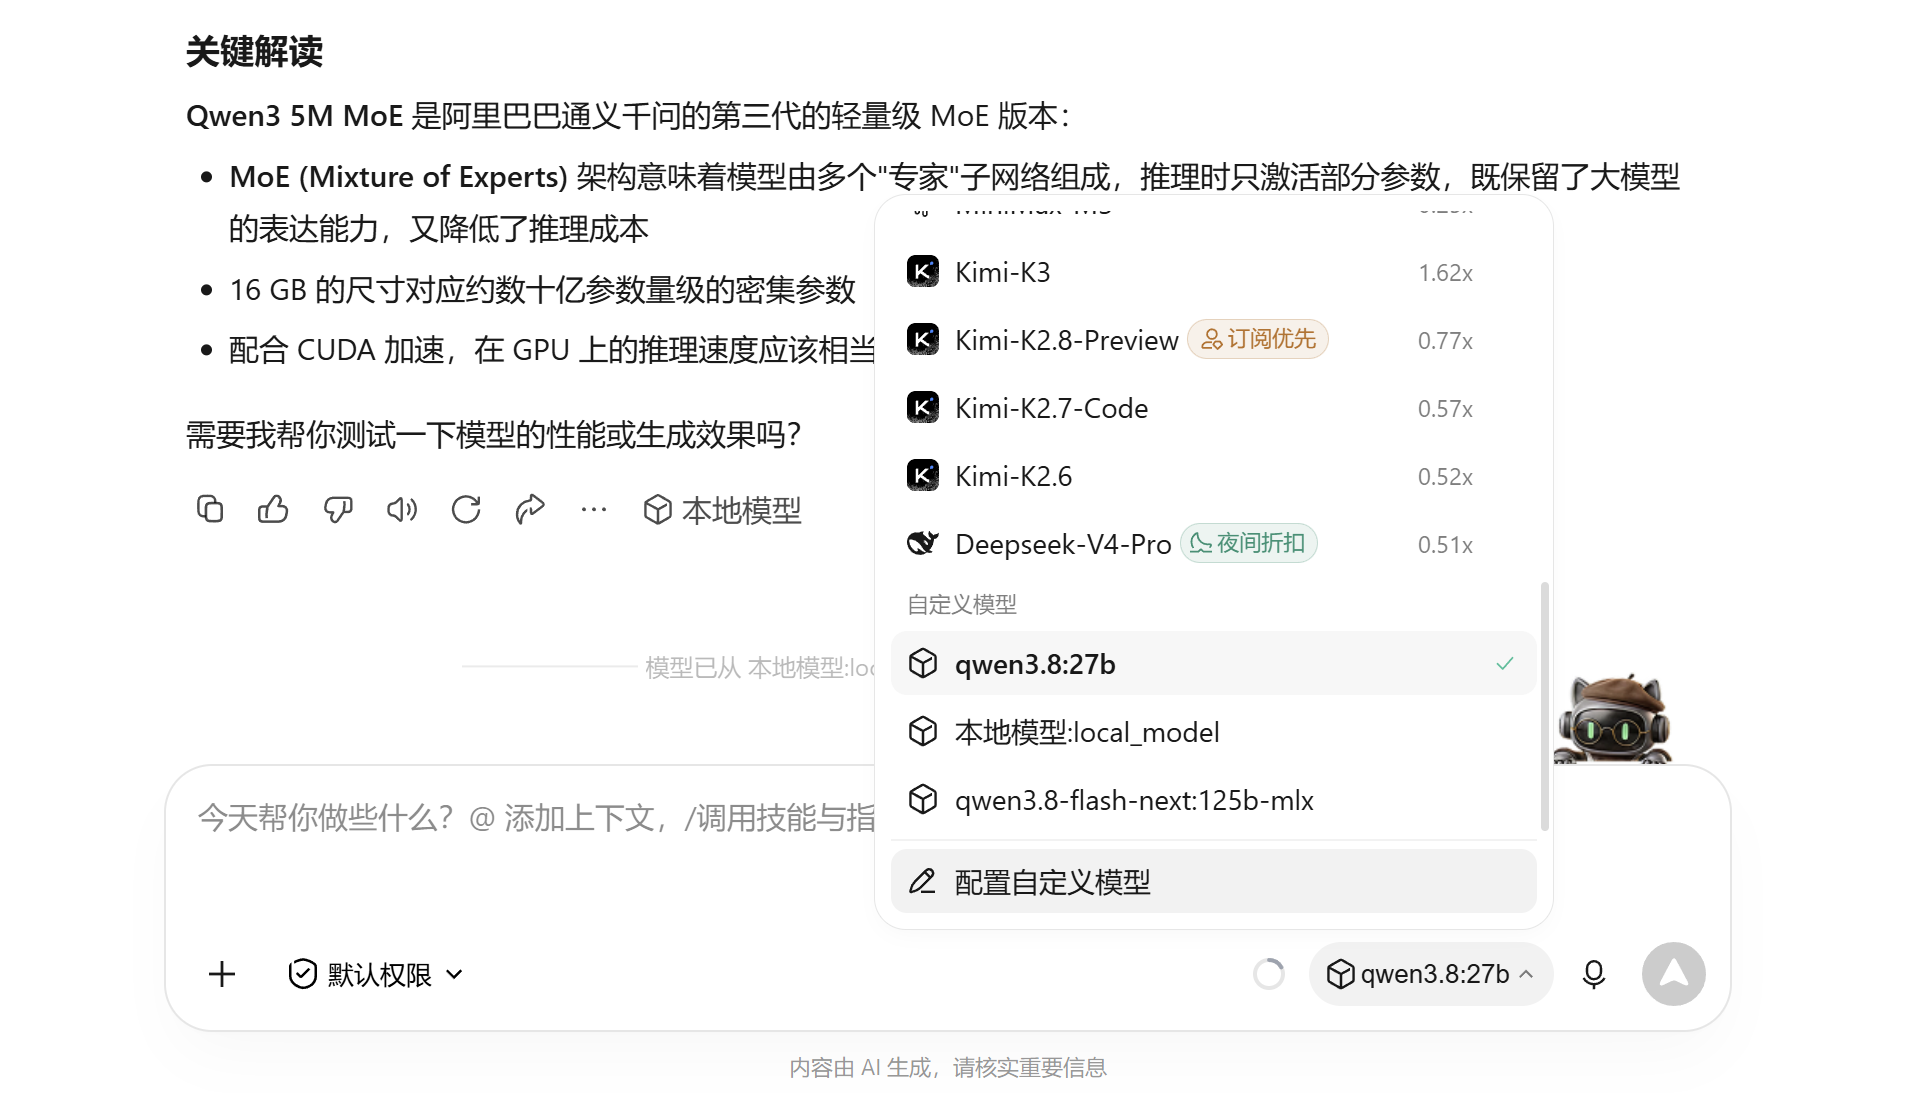
Una vez cargado correctamente, el modelo personalizado correspondiente se mostrará en WorkBuddy.
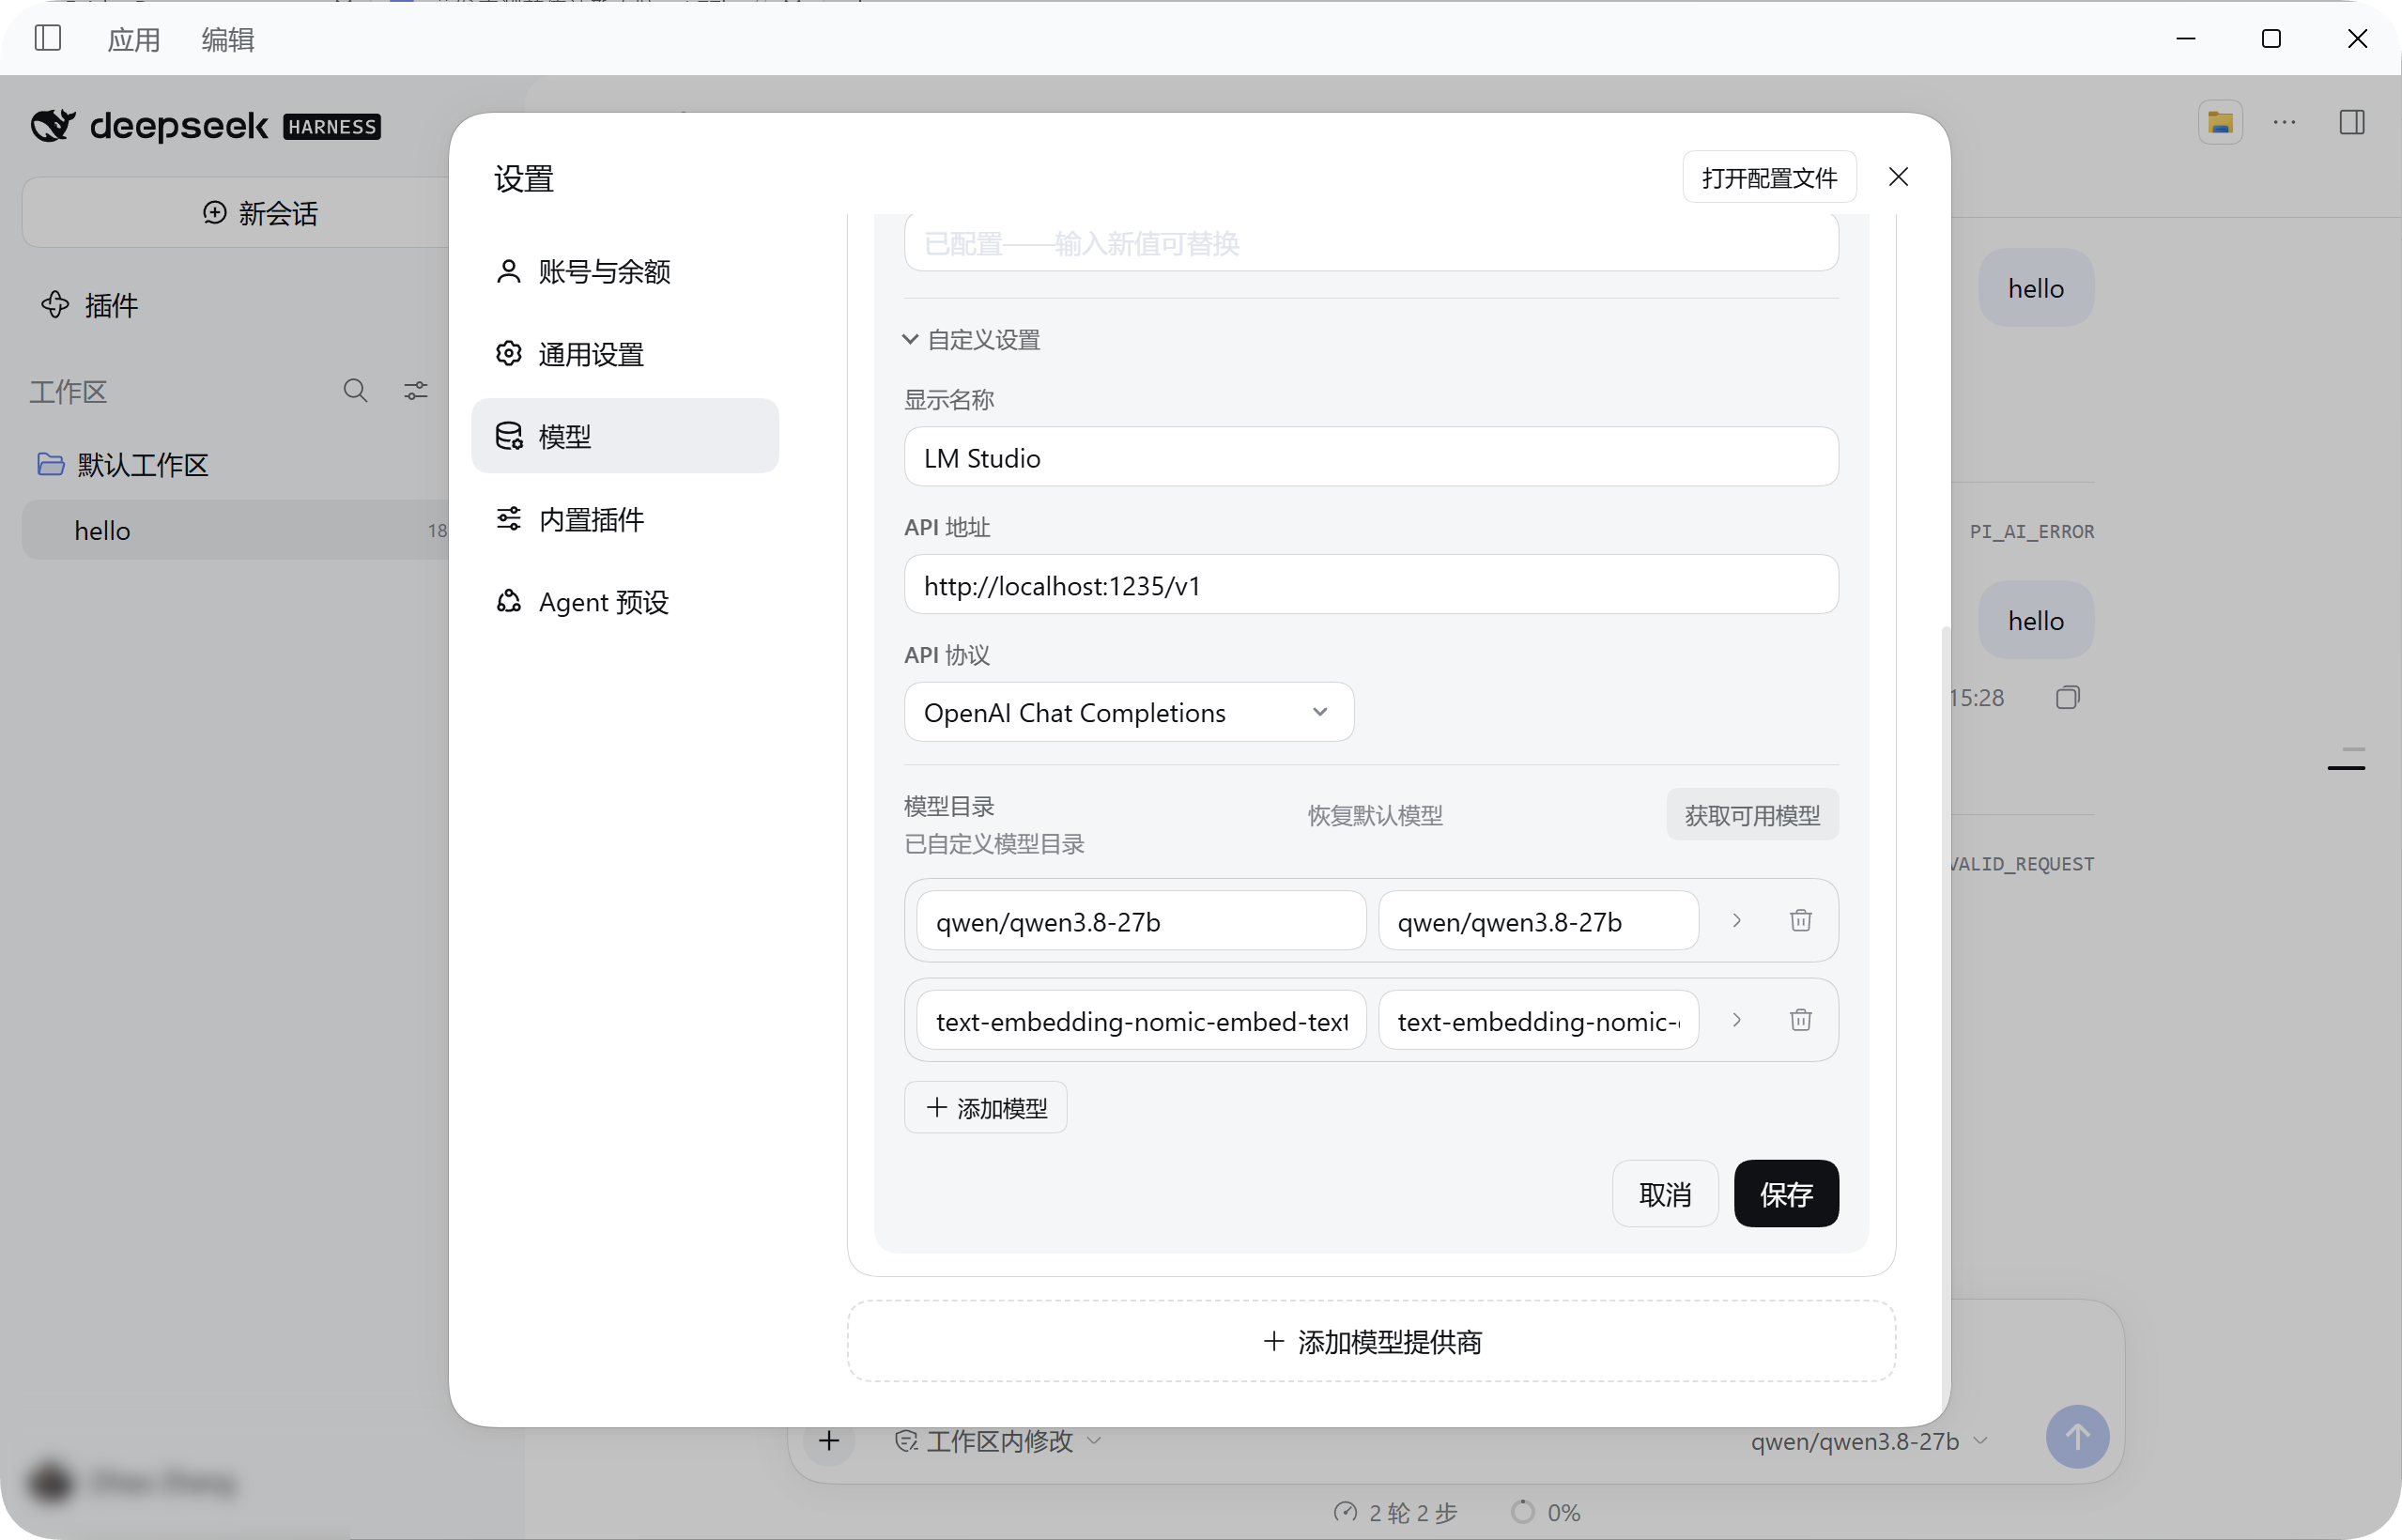
También puedes cargar modelos locales en otras herramientas de Harness que uses con frecuencia, como DeepSeek Harness, utilizando el mismo método.
La capacidad de procesamiento es muy alta y Windows también está mejorando.
Si nuestra experiencia con WorkBuddy nos hace pensar que usar IA local en Windows es bastante sencillo, entonces siempre existen diversos problemas con el desarrollo para Windows.
Esta es también la razón por la que los usuarios de los tres principales sistemas operativos (Windows, Linux y macOS) suelen tener problemas con este tema. Por un lado , muchas herramientas de desarrollo de código abierto se crearon originalmente en torno a flujos de trabajo de Unix/Linux, como los scripts de Bash, Git, OpenSSL, los compiladores y varias herramientas de línea de comandos, que a menudo utilizan métodos de llamada similares en entornos Linux/macOS.
Por otro lado, Linux también presenta problemas de compatibilidad con controladores, bibliotecas del sistema y diferentes distribuciones; macOS también puede carecer de versiones de paquetes de Python compiladas Apple Silicon y puede requerir la instalación de las herramientas de línea de comandos de Xcode.
Afortunadamente, lo que estamos viendo ahora es que Windows ha estado trabajando para solucionar estos problemas. Desde la actualización de Windows de hace unos días hasta el proyecto en curso Microsoft Execution Containers MXC, es posible proporcionar un entorno operativo más seguro y controlable para los agentes de IA que realizan operaciones con archivos y llaman a herramientas.
En lo que respecta a los modelos locales, Microsoft también anunció la compatibilidad con llama.cpp para Windows ML, lo que permite a los desarrolladores llamar a más modelos de código abierto a través del entorno de ejecución de IA de Windows.
Desde el entorno de desarrollo Linux existente de WSL hasta Windows Terminal, WinGet y las herramientas de desarrollo nativas ARM64 en constante mejora, Windows es ahora más adecuado para los desarrolladores que nunca.
Mientras tanto, la experiencia de usuario diaria de Windows también se está actualizando. La nueva versión de la Búsqueda de Windows, además de buscar archivos y aplicaciones, permite que el sistema realice las operaciones correspondientes, eliminando la necesidad de acceder al menú de configuración para buscar elemento por elemento.
Copilot también se está preparando para añadir más funcionalidades locales. Con el permiso del usuario, podrá leer archivos relevantes en el ordenador, realizar operaciones del sistema o llamar a modelos locales para completar tareas.
Entonces, ¿podría la IA ser la razón de la próxima actualización de teléfono?
Anteriormente, una estación de trabajo de IA equipada con una GPU NVIDIA de alta capacidad solía implicar un servidor de tamaño considerable, una tarjeta gráfica dedicada y un entorno de escritorio que requería alimentación eléctrica continua.
Ahora, NVIDIA ha integrado una plataforma informática capaz de ejecutar grandes modelos locales y compatible con CUDA en un portátil Windows que pesa menos de 1,8 kg.
Podemos llevarlo a la oficina, ponerlo sobre una mesa en una cafetería o incluso desenchufarlo y dejar que un modelo 27B siga funcionando.
Pero este ordenador también pone de manifiesto otra faceta de la IA local en esta fase: el hardware ya es capaz de ejecutar modelos complejos, pero el software aún no está completamente listo para que todo el mundo lo utilice con facilidad.
Productos como WorkBuddy están reduciendo las barreras de implementación, y cada vez más agentes están probando el uso directo de la potencia de cálculo local. Sin embargo, las compensaciones entre la compatibilidad del software, las capacidades del modelo, el rendimiento y la duración de la batería seguirán afectando la experiencia final.
Por lo tanto, si necesita ejecutar modelos locales, desarrollar aplicaciones de IA o gestionar datos que resultan inconvenientes para subir a la nube a diario, esta generación de portátiles ASUS ProArt 16 RTX Spark ofrece una nueva opción que merece la pena considerar.
Sin embargo, si normalmente solo utiliza herramientas de IA basadas en la nube, como ChatGPT y Gemini, no es necesario reemplazar su computadora portátil solo para ejecutar un modelo grande localmente.
Actualmente, la tendencia general en los ordenadores personales apunta hacia una mayor memoria, una mayor potencia de procesamiento y una mayor integración de inteligencia artificial.
A medida que los agentes de IA se integran cada vez más en nuestro trabajo diario, la capacidad de procesamiento de las computadoras recuperará su importancia. Anteriormente, tal vez solo necesitábamos una computadora conectada a una IA en la nube; en el futuro, algunas tareas podrían completarse directamente en la computadora.