Desde una sola frase hasta un mundo completamente funcional, VAST ha liberado el código fuente de toda la cadena
En el juego, si te acercas a una puerta y no estás seguro de si puedes entrar, lo habitual es darte la vuelta, retroceder dos pasos y luego saltar dos veces para ver si puedes pasar por encima del muro que tienes al lado.
Todas estas son acciones muy comunes en los videojuegos, pero imagina que la escena frente a ti fuera generada por IA. El modelo tendría que seguir el ritmo de cada acción impulsiva del jugador: detenerse repentinamente, girar bruscamente o correr y saltar repentinamente. Durante este proceso, cada fotograma tendría que ser estable.
Esto es lo que puede hacer EdenLive, el nuevo modelo de mundo en tiempo real de código abierto de VAST. Se trata de un renderizador generativo en tiempo real de la serie Project Eden. Las reglas y los estados del contenido interactivo, como las vistas previas de juegos y animaciones, se mantienen gracias al sistema interactivo principal. Modelos en blanco, escenas 2D/3D o grabaciones del mundo real pueden servir como referencia para generar imágenes. Cuando mueves a tu personaje hacia adelante o giras la cámara hacia atrás, el sistema interactivo convierte el estado actualizado en imágenes en blanco y negro y descripciones de escenas, las introduce en EdenLive y el modelo renderiza los efectos visuales correspondientes en tiempo real , lo que te permite ver el mundo generado por IA mientras juegas.
Las referencias no tienen por qué ser un juego perfectamente diseñado; cualquier material visual sirve. Un modelo 3D básico en blanco, una escena 2D o incluso un videoclip existente pueden aportar estructura y movimiento. La misma referencia puede generar estilos completamente diferentes —realistas, dibujos a mano, caricaturas, pixel art o pintura al óleo— simplemente cambiando el primer fotograma o una palabra clave.
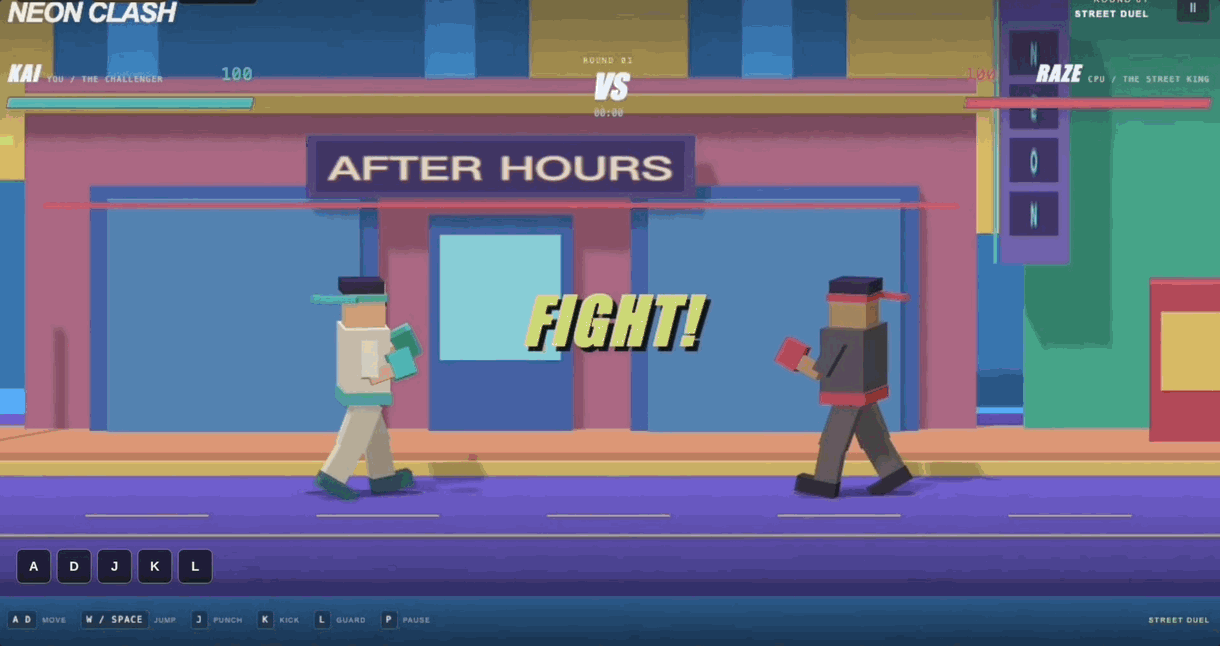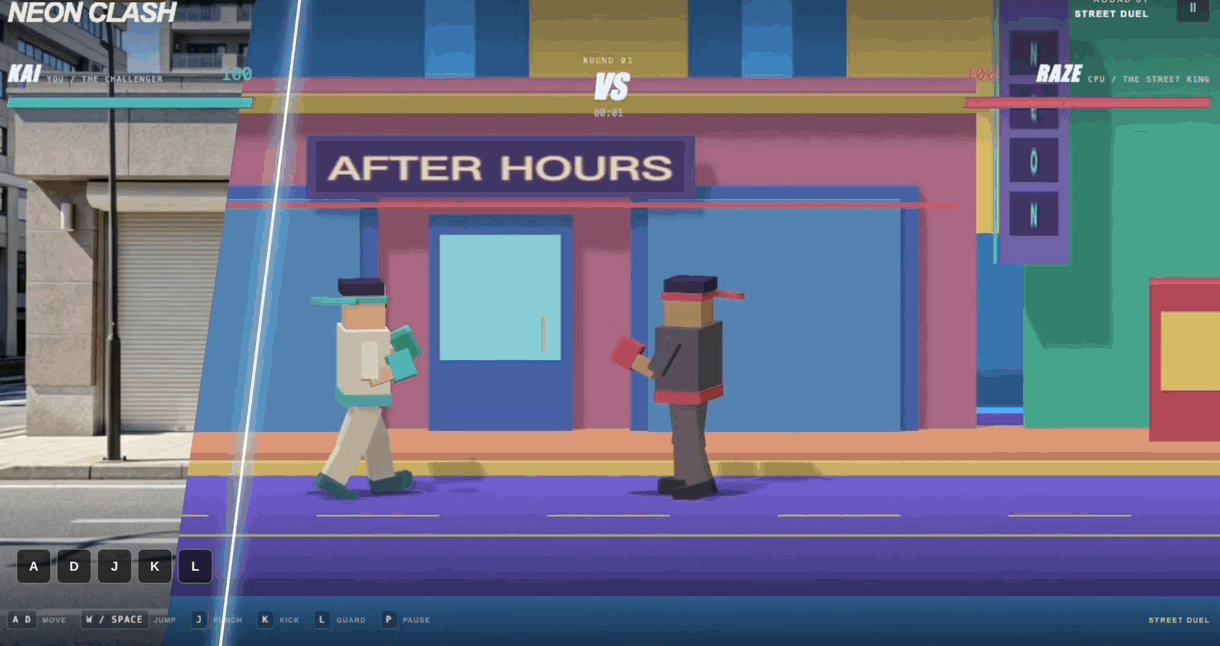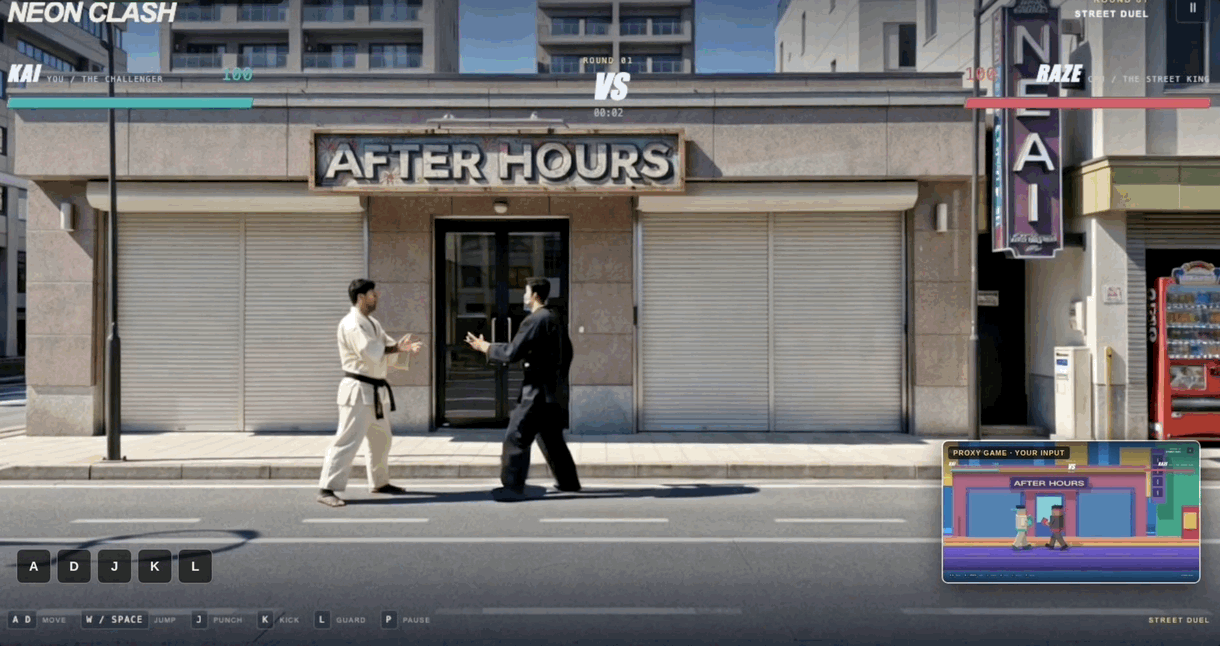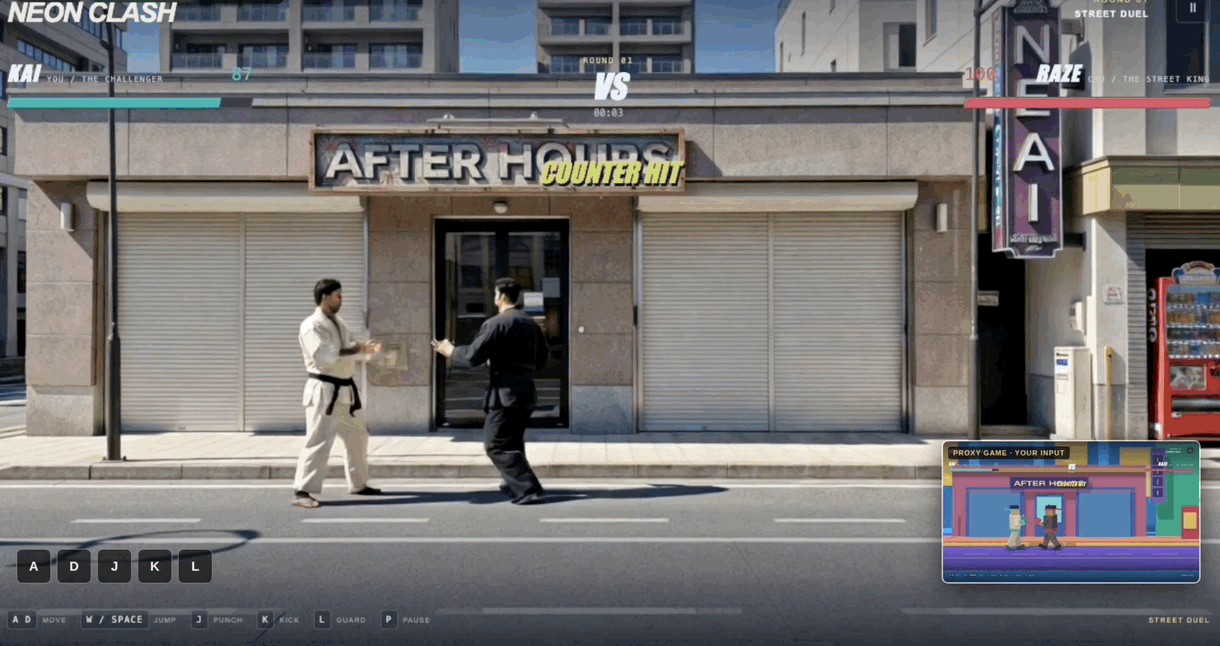
Utilice cualquier referencia visual para generar imágenes mientras interactúa con el usuario.
EdenLive es realmente versátil. Puede generar continuamente secuencias de juego basadas en las acciones del jugador, conservar la trayectoria del movimiento y los ángulos de cámara de un vídeo, y modificar el estilo de los personajes y el entorno. En escenarios con personajes, un vídeo grabado en primera persona con la mano humana puede transformarse en una versión desde la perspectiva de un brazo robótico.
Para lograrlo, EdenLive implementa una "división del trabajo": el fotograma de referencia determina la estructura, el movimiento y los ángulos de la cámara, mientras que el modelo generativo se encarga de reescribir el aspecto final de estos elementos. Los tres tipos de entradas de EdenLive tienen funciones claramente definidas: el vídeo de referencia determina la disposición de la escena, el movimiento de la cámara, las trayectorias de los objetos y la sincronización de los eventos; el primer fotograma objetivo determina el sujeto, los materiales, la paleta de colores y el estilo artístico; y las indicaciones de texto complementan el estilo y los detalles, con la posibilidad de añadir una descripción durante las interacciones cuando se producen eventos. Esto permite que la renderización generativa vaya más allá de la generación de vídeo offline y se aplique en diversos escenarios, como interacciones de juegos de larga duración, transformaciones de estilo de vídeo y aumento de datos incorporados.
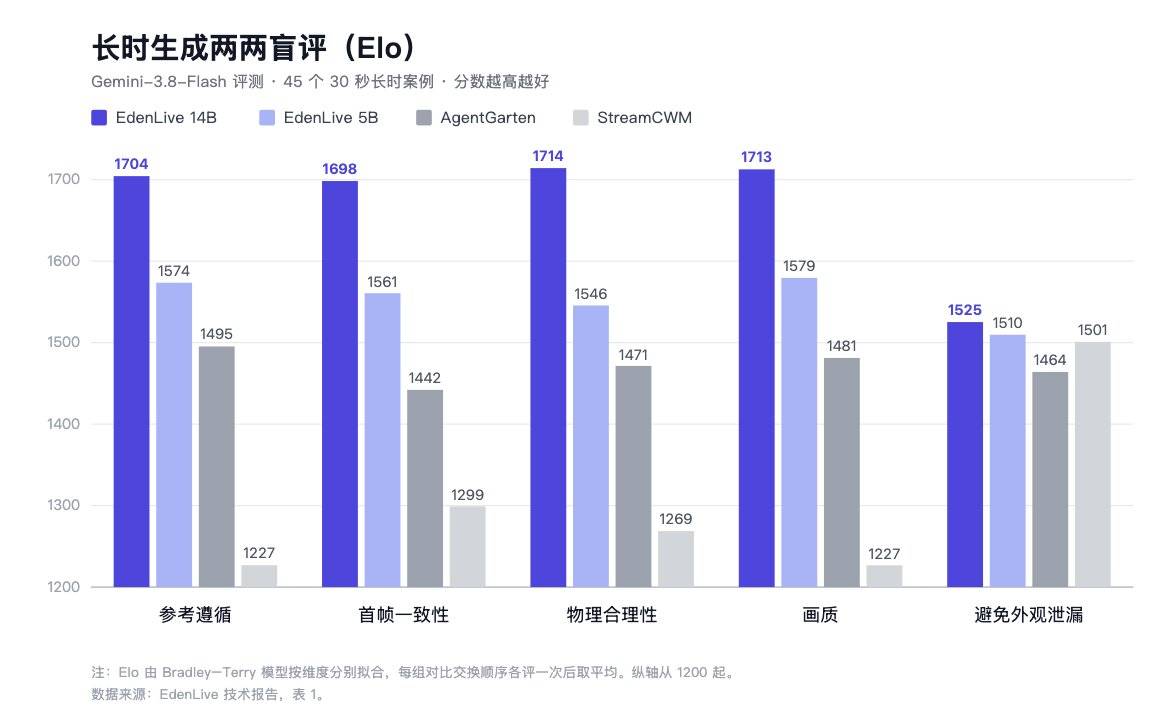
existirEdenLive ha logrado avances significativos en las capacidades de generación a largo plazo necesarias para una interacción sostenida. Basándose en una evaluación ciega por pares de 45 casos a largo plazo utilizando Gemini-3.8-Flash (cada par se evaluó una vez con el orden invertido y las puntuaciones Elo se calcularon por dimensión), EdenLive 14B y 5B se clasificaron en primer y segundo lugar respectivamente en cinco dimensiones: cumplimiento de la referencia, consistencia del primer fotograma, plausibilidad física, calidad de la imagen y evitación de fugas de apariencia. Por ejemplo, en términos de cumplimiento de la referencia, 14B obtuvo una puntuación de 1704, aproximadamente 200 puntos más que AgentGarten.
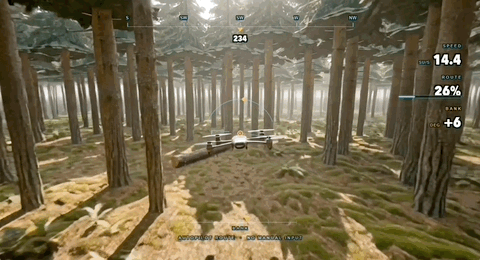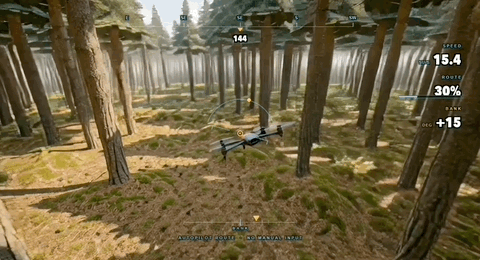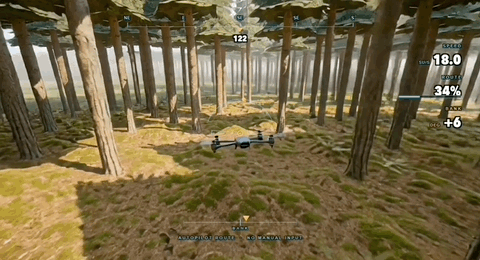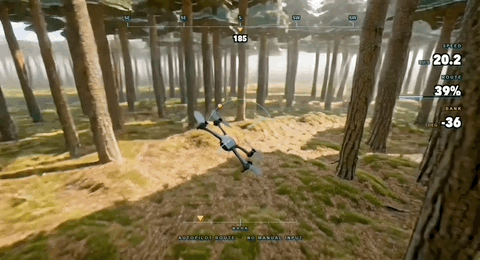
En las previsualizaciones de escenas y animaciones, las referencias pueden ser escenas con modelos blancos, animaciones preliminares creadas por artistas o vídeos de mapas normales renderizados a partir de modelos detallados. Al mantener la referencia sin cambios y modificar únicamente el primer fotograma y las palabras clave, se pueden comparar diferentes materiales, iluminación y esquemas de color dentro de la misma escena y segmento de animación. Cuando la cámara se aleja de una ubicación y luego regresa, la estructura de la referencia permanece intacta y EdenLive continúa renderizando según la misma estructura, sin necesidad de volver a inferir a partir de metraje anterior.
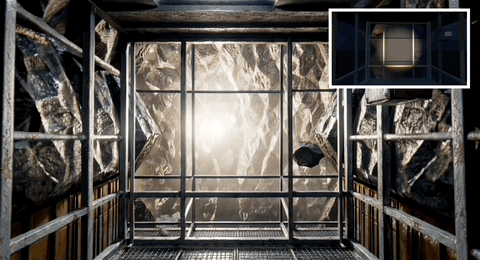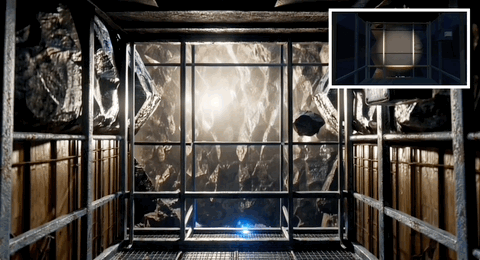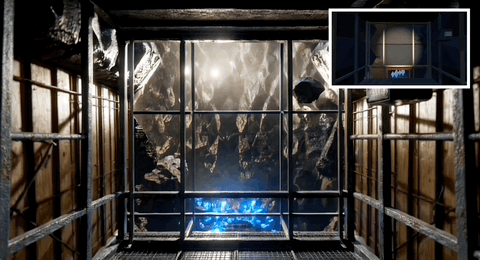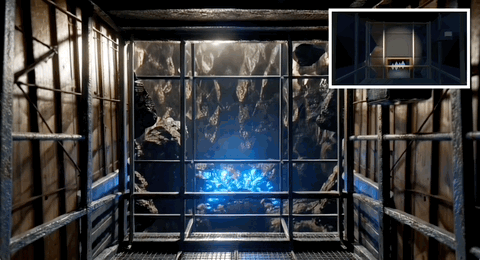
En el juego, esta continuidad y coherencia también deben coordinarse con las acciones del jugador. Por ejemplo, tras entrar en el elevador, mientras este desciende, la valla y la rejilla deben mantener su forma original, pero el entorno exterior debe cambiar gradualmente.
Otro uso que a menudo se pasa por alto es la mejora de datos incorporados.
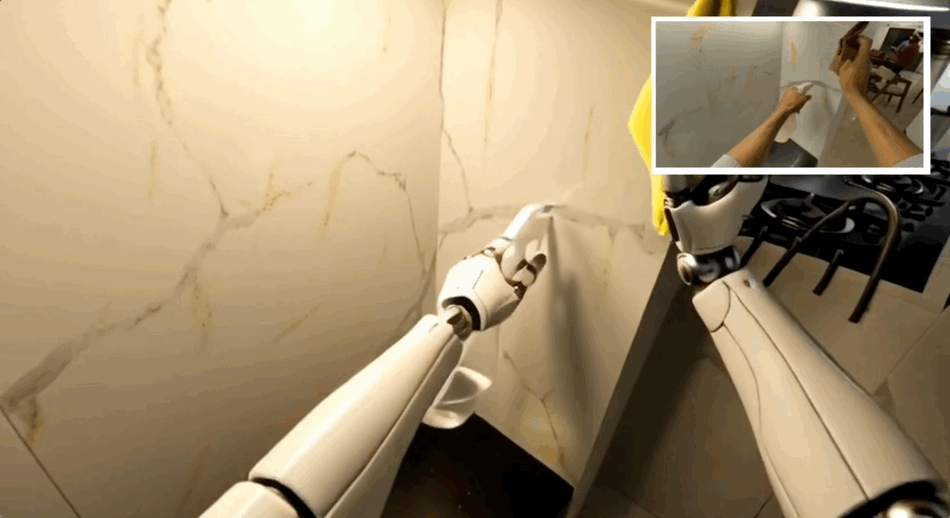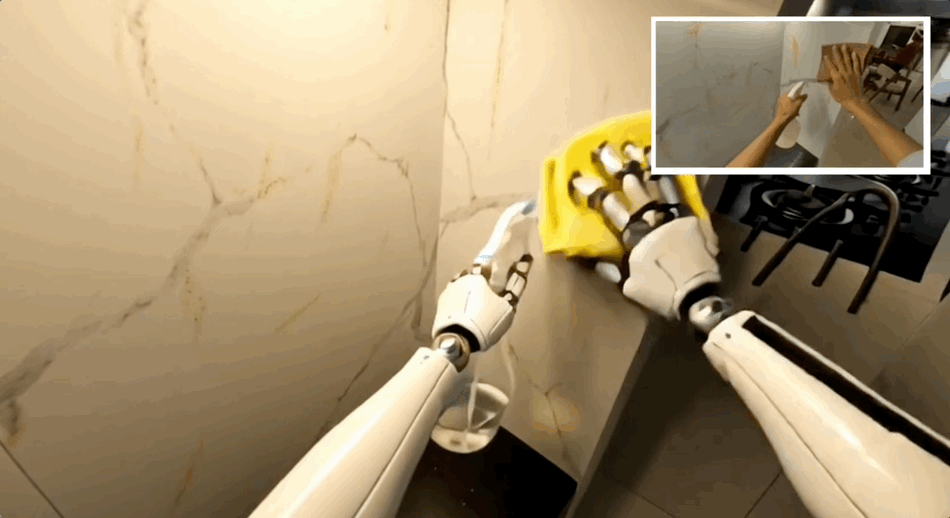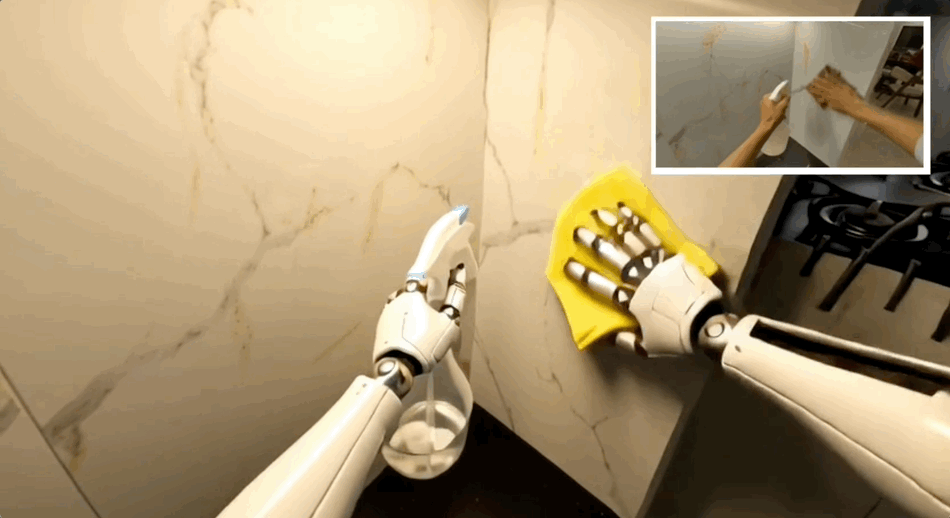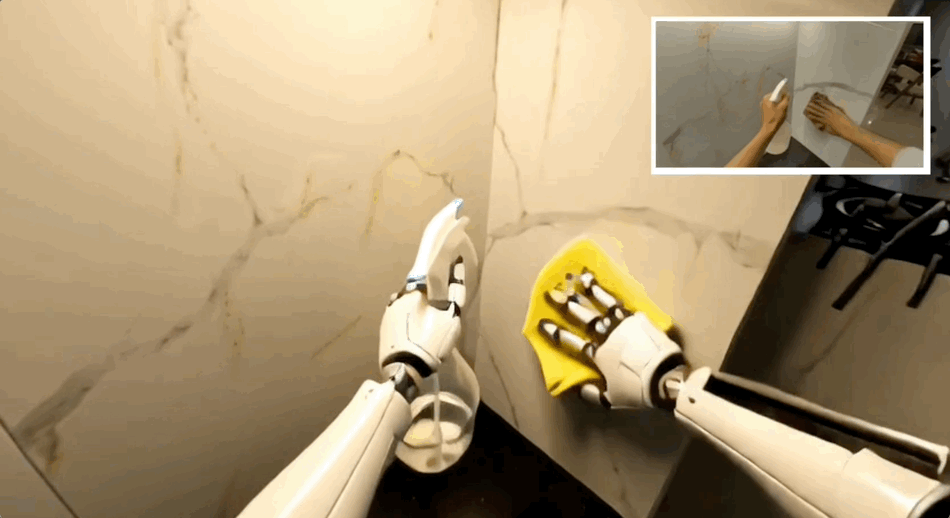
La formación de robots no carece de conocimientos sobre "cómo los humanos limpian una mesa", pero sí carece de materiales de formación sobre "cómo un brazo robótico se acerca a un objeto, lo agarra y completa la acción desde la perspectiva del robot ".
Obtener una perspectiva similar no es difícil; basta con que alguien lleve una cámara y se grabe limpiando una mesa, abriendo cajones y vertiendo agua. Se pueden grabar muchos vídeos en un día. Sin embargo, las grabaciones en vivo muestran los brazos y los dedos de una persona, mientras que el robot, al ser desplegado, ve un brazo robótico y una pinza. Las formas, los rangos de movimiento y los métodos de oclusión son diferentes. Si el modelo se entrena principalmente con vídeos en vivo, puede encontrar diferencias significativas en la distribución visual al ser visto a través de la cámara del robot.
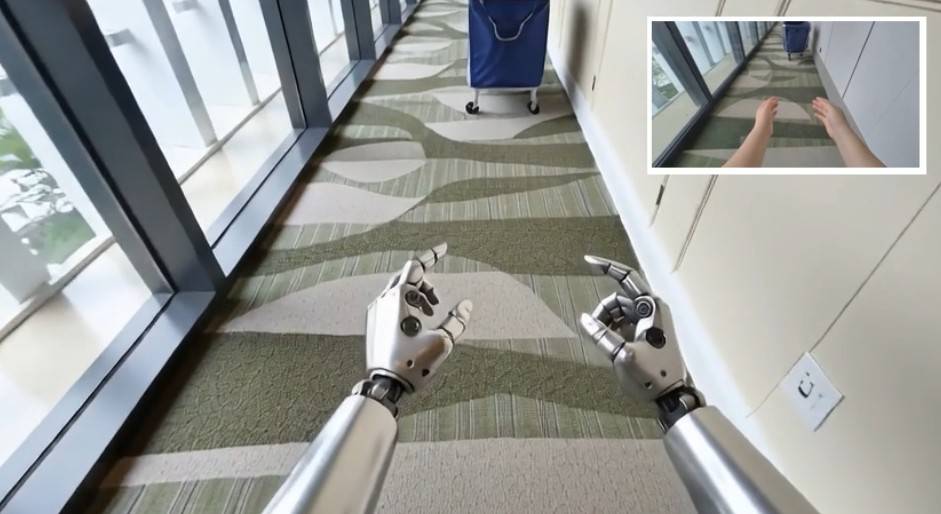
Al sustituir las manos humanas por manos robóticas mediante EdenLive, los datos se transforman en información que se asemeja más a lo que un robot vería en realidad durante su trabajo. Por ejemplo, se conservan la acción de una persona al coger una tetera, la posición relativa de la tetera con respecto a la mesa y el movimiento de la cámara en primera persona; solo se cambia el ejecutor por una mano robótica, lo que ayuda al modelo a adaptarse a "lo que ve el robot".
Los distintos tipos de material de referencia producen efectos diferentes y tienen sus propias limitaciones. Las grabaciones existentes solo proporcionan tomas y acciones, y tras su renderizado, siguen siendo simplemente un vídeo; la reproducción depende del código fuente. Sin embargo, EdenLive cuenta con una estructura de trabajo y reglas bien definidas, por lo que los resultados generados pueden variar durante el proceso.
El modelo del mundo necesita desacoplar el estado de la representación.
Al ver estas demostraciones, es fácil suponer que el jugador manipula directamente un modelo de vídeo. En realidad, EdenLive no determina lo que sucede en el juego ni es responsable del funcionamiento del mundo. En Project Eden, lanzado en mayo, VAST divide la investigación del modelo del mundo en una arquitectura de tres capas: un estado del mundo en constante evolución, que registra las posiciones y atributos de los objetos, las reglas de interacción y las consecuencias de las acciones; una interfaz que convierte el estado actual en restricciones de diseño, geometría y eventos desde un punto de vista específico; y un renderizador generativo, que genera imágenes de alta fidelidad basadas en estas restricciones. EdenLive implementa las dos últimas capas, pero no se limita a la primera.
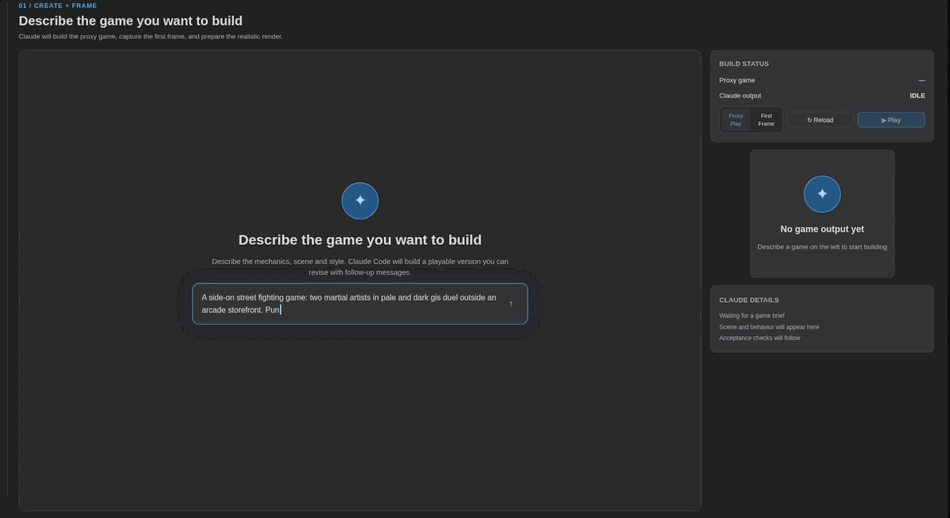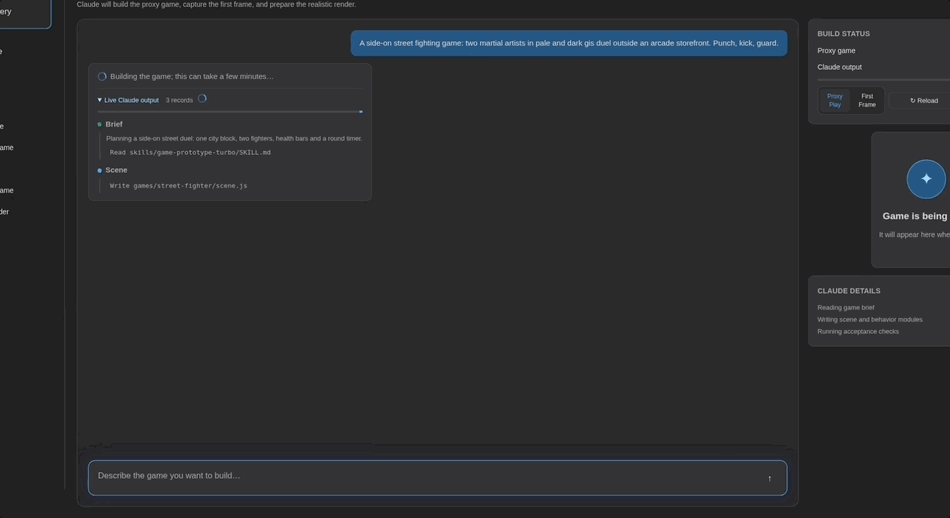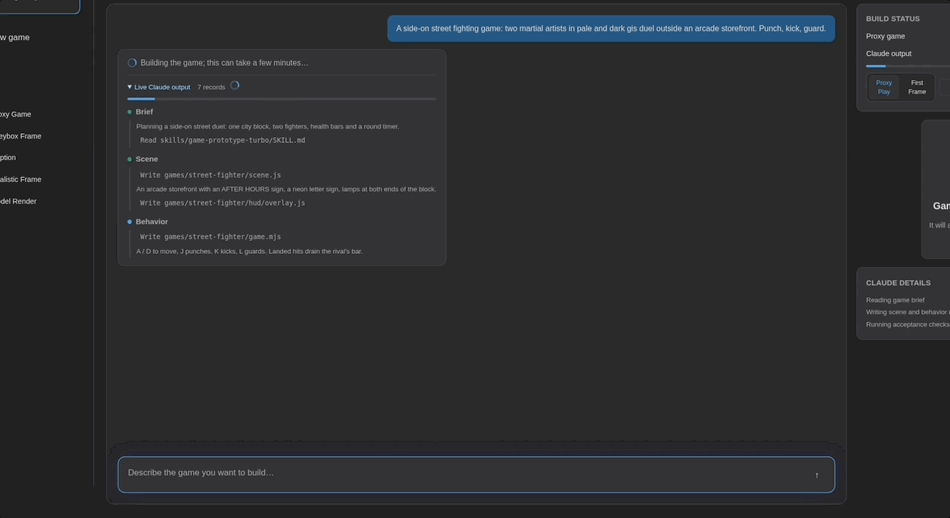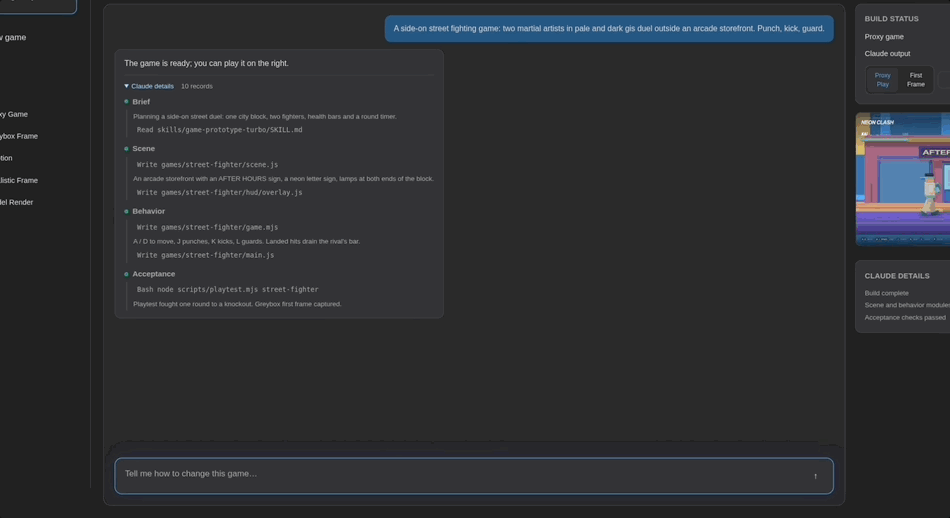
En los juegos de lucha, cuando un jugador pulsa el botón de ataque, el comando primero pasa por el sistema de interacción previo. Este determina si la patada alcanza al oponente, cuánta salud se le debe restar y, a continuación, actualiza las barras de estado y salud de ambos personajes.
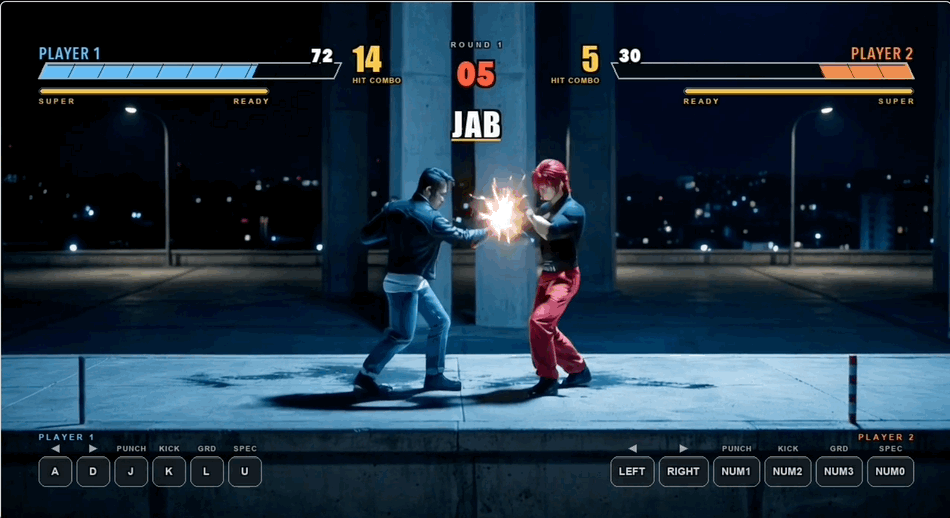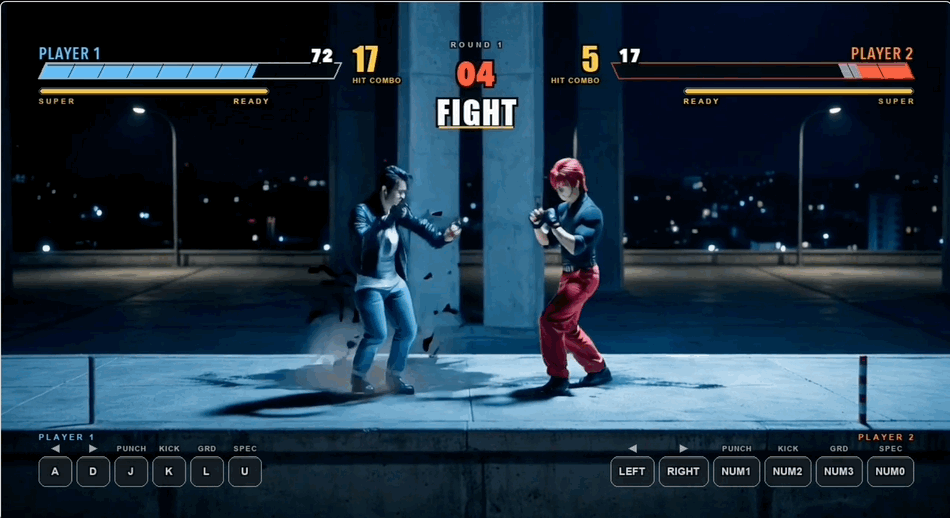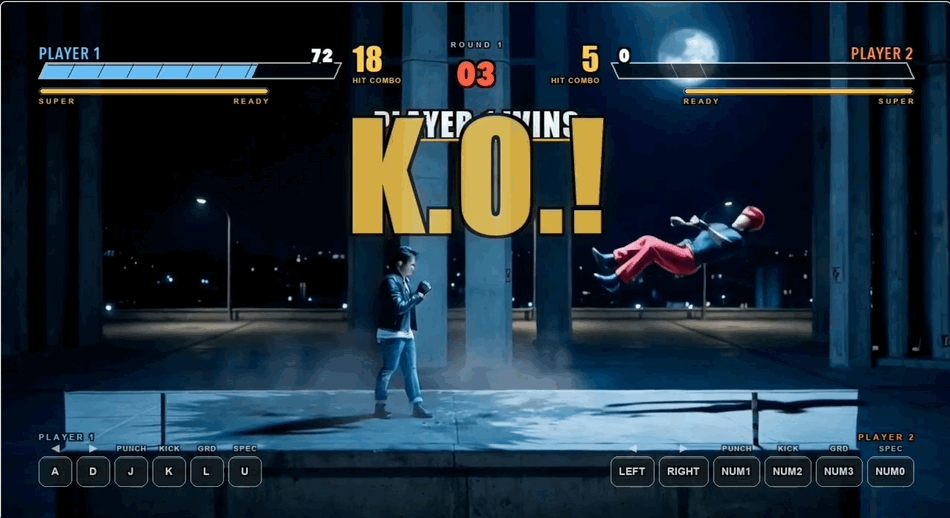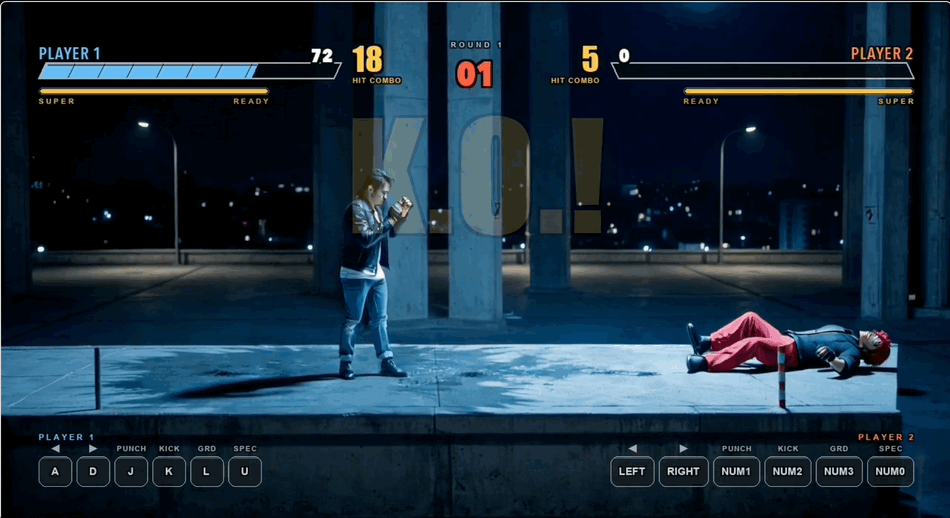
Los modelos de vídeo destacan por generar imágenes aparentemente plausibles, pero no pueden mantener por sí solos reglas para aspectos como la salud, las colisiones, la identidad de los objetos y las condiciones de victoria/derrota. Por lo tanto, EdenLive deja los estados deterministas al sistema de interacción previo y confía la presentación visual al modelo generativo.
pagarEl sistema convierte cada cambio en una nueva imagen en blanco y negro, a partir de la cual un codificador visual especialmente ajustado extrae la disposición, los ángulos de la cámara y el movimiento. No necesita detalles de la piel, la ropa ni la iluminación; solo necesita explicar claramente la disposición espacial, las trayectorias del movimiento y cómo se desplaza la cámara.
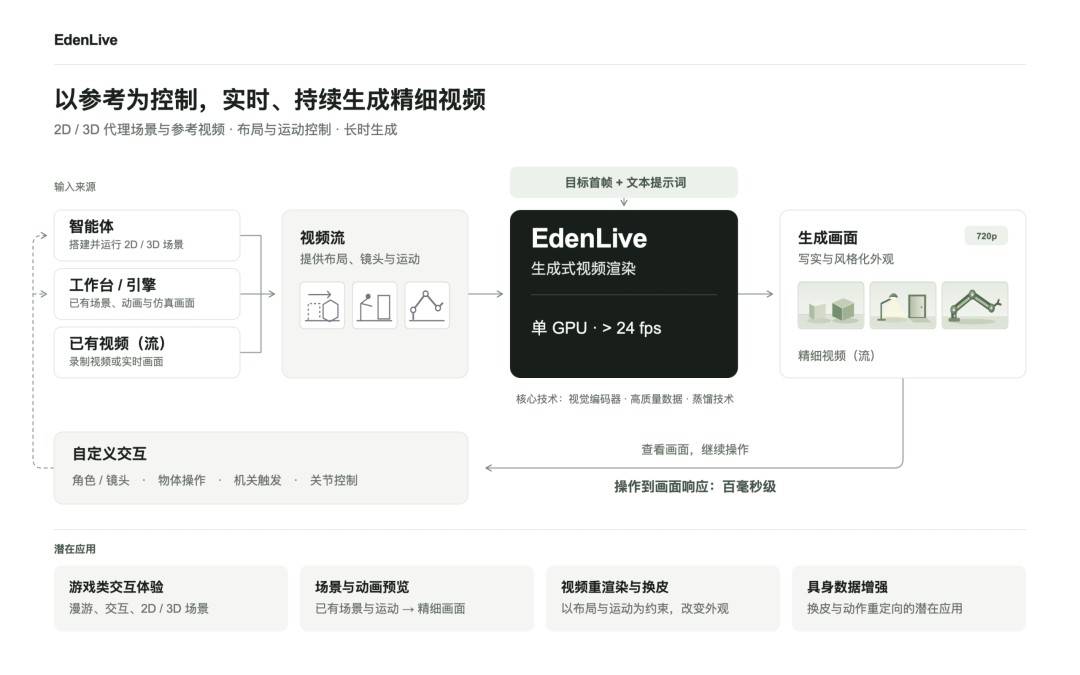
Las reglas las gestiona el sistema de interacción, y los elementos visuales, el modelo. Esta división de tareas resuelve el problema de que los modelos de vídeo no almacenan bien las reglas durante mucho tiempo, lo que garantiza una presentación estable de los elementos visuales. Por supuesto, esta división de tareas aún debe probarse con periodos más largos e interacciones más complejas.
El modelo mundial cuenta con numerosas demostraciones, pero carece de ejemplos de uso.
En enero de 2026, un estudio realizado por investigadores de Oxford enumeró la "confusión visual" como un desafío que los modelos del mundo deben abordar: las representaciones visuales realistas no significan que el modelo comprenda la causalidad y las leyes físicas, y abogó por que los modelos del mundo deberían pasar de motores visuales que generan imágenes a simuladores operativos que puedan representar dinámicas y restricciones.
Antes de que este enfoque se convirtiera en la narrativa principal para los modelos del mundo, el Proyecto Edén, lanzado por VAST en mayo de este año, ya había incorporado el sistema interactivo que mantenía el estado del mundo y el modelo generativo responsable de la presentación visual en su arquitectura completa; unos meses más tarde, EdenLive avanzó aún más su renderizado generativo a una operación continua en tiempo real.
Propuestas similares no comenzaron a aparecer con mayor frecuencia en el mercado hasta agosto y septiembre.
Esta versión de código abierto incluye pesos de modelo de 5B y 14B (cada uno con dos versiones: generación bidireccional y generación de flujo en pocos pasos), código de inferencia de flujo en tiempo real, EdenGolem v0.1 y un entorno de desarrollo front-end, junto con un informe técnico. Los desarrolladores pueden acceder a sus propias fuentes de referencia para medir la latencia, la estabilidad y el cumplimiento de las referencias.
Junto con EdenLive, también se lanzó V·STAR, un programa de alto rendimiento para jóvenes profesionales de algoritmos e investigación de todo el mundo. La selección se centra en tres áreas: modelos generativos 3D, comprensión 3D e IA automatizada, y modelos del mundo. Tanto para puestos a tiempo completo como para prácticas, V·STAR ofrece la oportunidad de participar directamente en proyectos clave y percibir salarios más competitivos que los de las principales empresas tecnológicas, sin límite máximo para los profesionales con un talento excepcional, además de opciones sobre acciones a largo plazo.
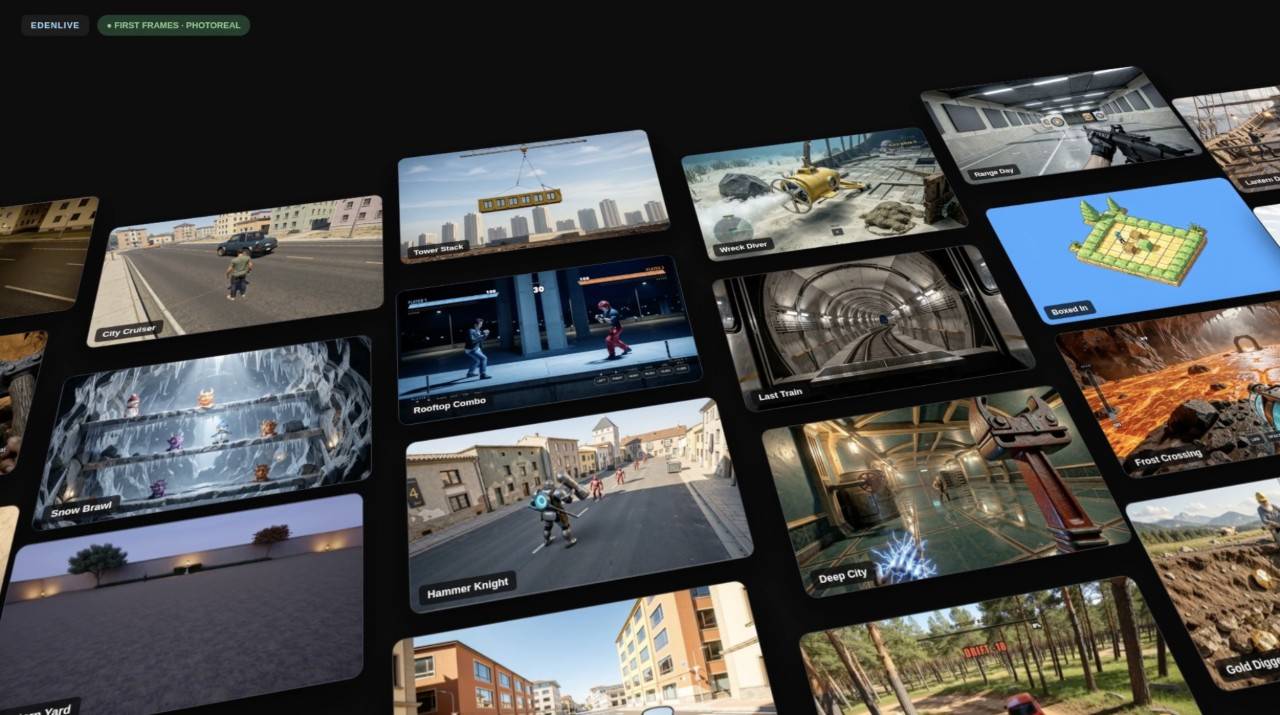
Las demostraciones de modelos de mundos anteriores solían usar un video para probar que el modelo podía imaginar un mundo. EdenLive ha dado un paso importante. A medida que más personas aporten su código, escenas y referencias visuales, la tecnología evolucionará gradualmente hasta convertirse en un flujo de trabajo creativo verdaderamente útil, abriendo aún más posibilidades para el mundo.
Pesos del modelo: https://huggingface.co/VAST-AI/EdenLive
Informe técnico: https://assets.vast-eden.ai/assets/edenlive/EdenLive-tech-report.pdf
Unbound Loop: http://loop.unbound.io
Para participar en el programa V·STAR Top Talent, envíe su currículum a [email protected].