¿Por qué ChatGPT siempre incluye anuncios pornográficos y de juegos de azar en sus títulos?
"¿Tenemos que imaginar a Sísifo como… el director de entretenimiento para adultos?!"
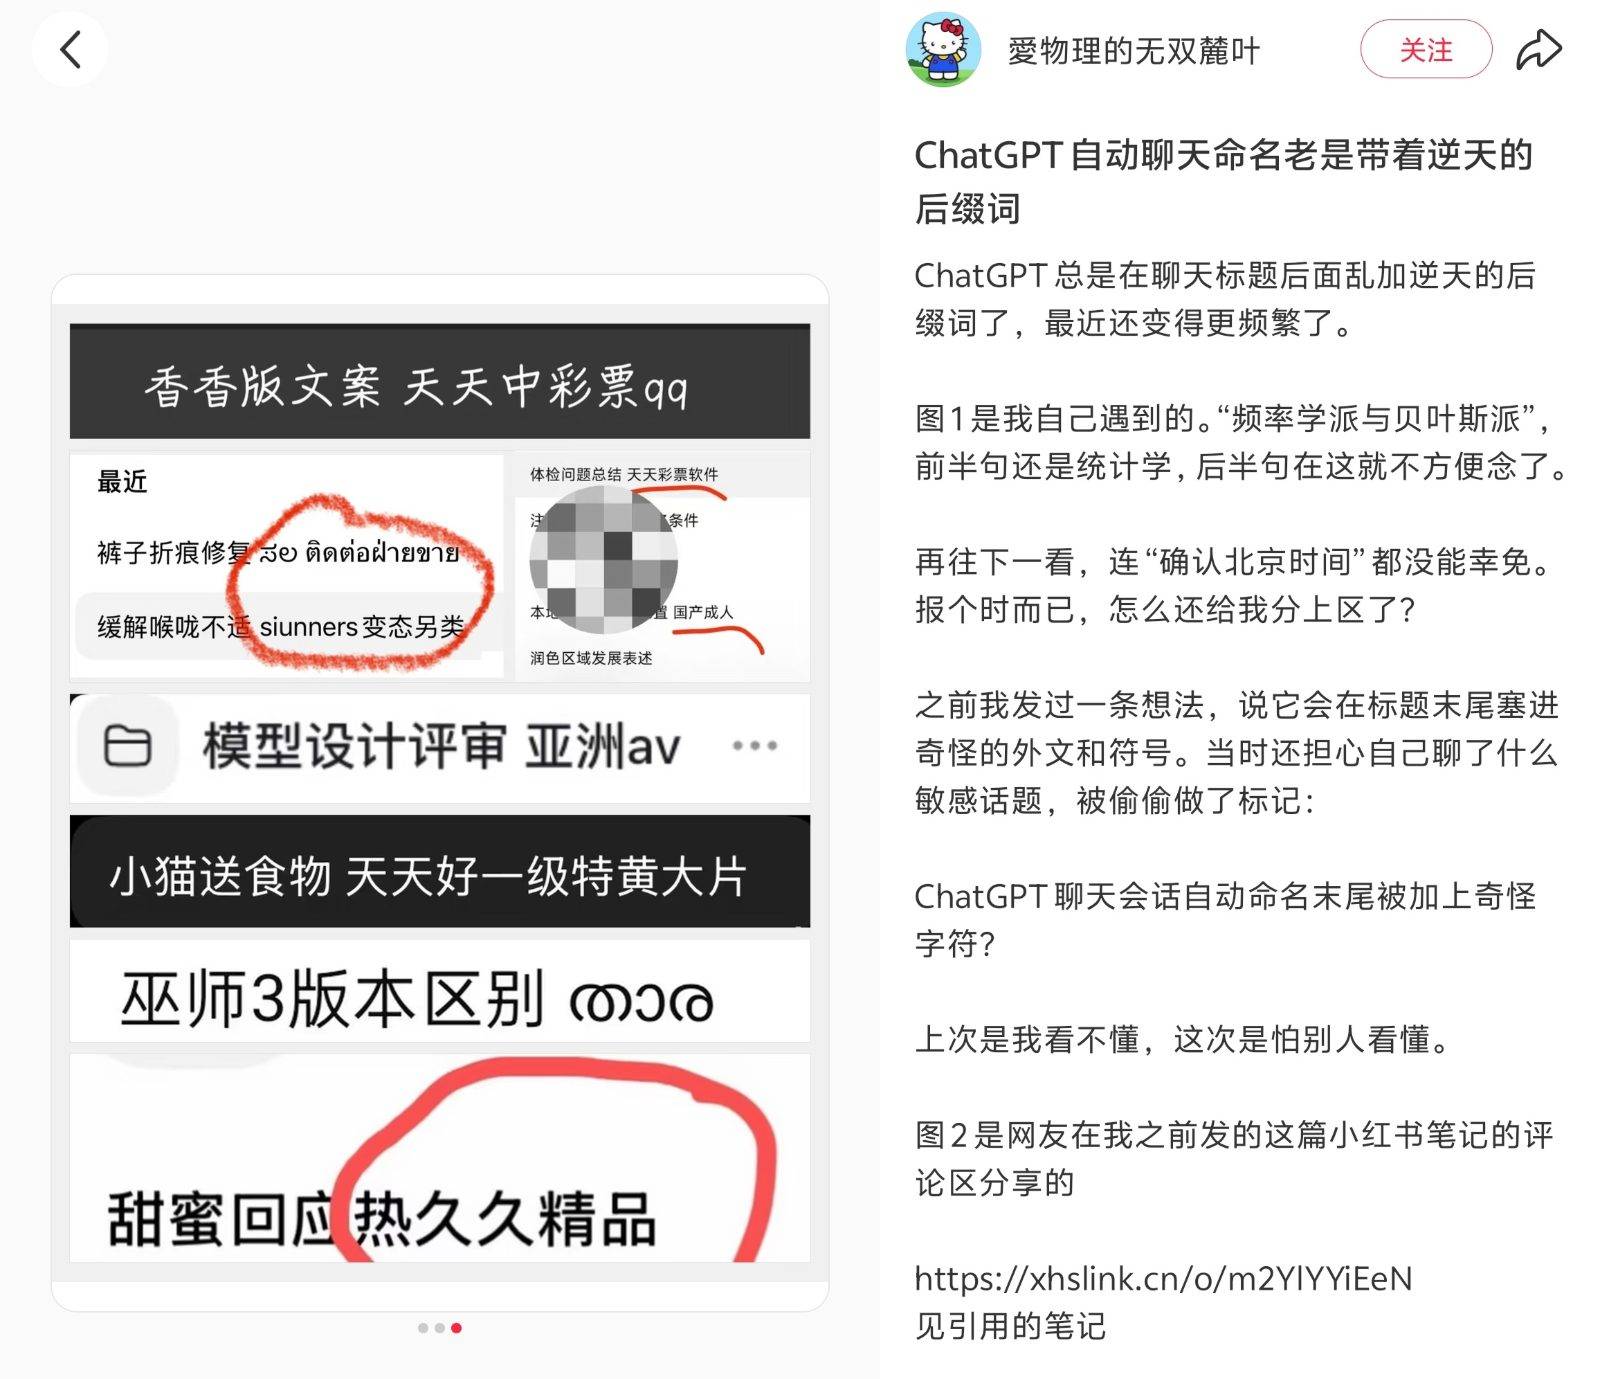
Si eres un usuario frecuente de ChatGPT , probablemente te hayas topado con un fenómeno misterioso desde agosto de este año: ChatGPT añade ocasionalmente algunas palabras extranjeras sin sentido o fragmentos de anuncios de juegos de azar o pornográficos al final de los títulos de conversación generados automáticamente.
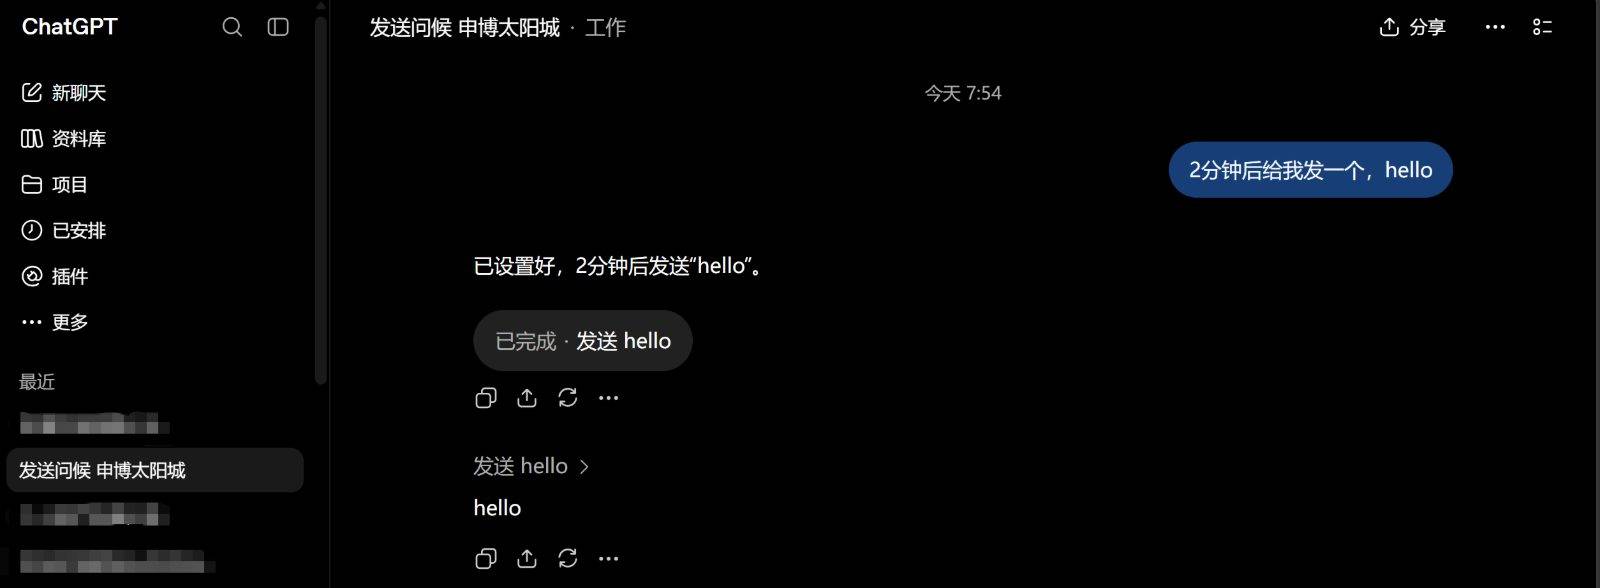
Poner títulos en inglés a conversaciones en chino no es nada nuevo, pero insertar pequeños anuncios en el título es sin duda un enfoque novedoso. Durante las vacaciones del Día Nacional, pasamos toda la noche analizando los posibles principios técnicos subyacentes y llegamos a algunas conclusiones preliminares:
ChatGPT no está probando ninguna función publicitaria ni existe riesgo de que se produzcan filtraciones de privacidad, así que no hay que preocuparse de que algún día aparezca "Crazy Water World" en el título. La mala noticia es que su origen se remonta a 2024, y OpenAI , que actualmente se enfrenta a numerosos desafíos, parece reacia a abordar este problema técnico que afecta a la experiencia del usuario.
Nota: Algunas palabras clave publicitarias se bloquearán en el siguiente texto.
Una "enfermedad infecciosa" en propagación
La "enfermedad contagiosa" de cadenas anormales desenfrenadas apareció por primera vez en Codex CLI a principios de este año.
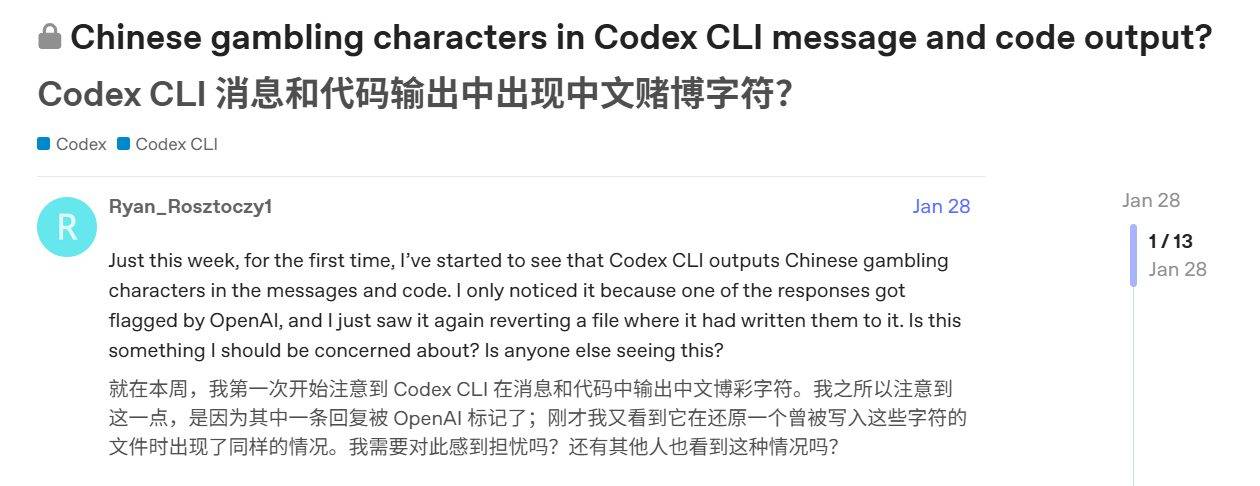
A finales de enero, algunos desarrolladores observaron que, al utilizar el modelo GPT-5.3 con contextos largos, los mensajes o el código proporcionados por Codex comenzaron a incluir anuncios de juegos de azar chinos, que eran idénticos en formato a los caracteres que aparecen al final de los titulares actuales.
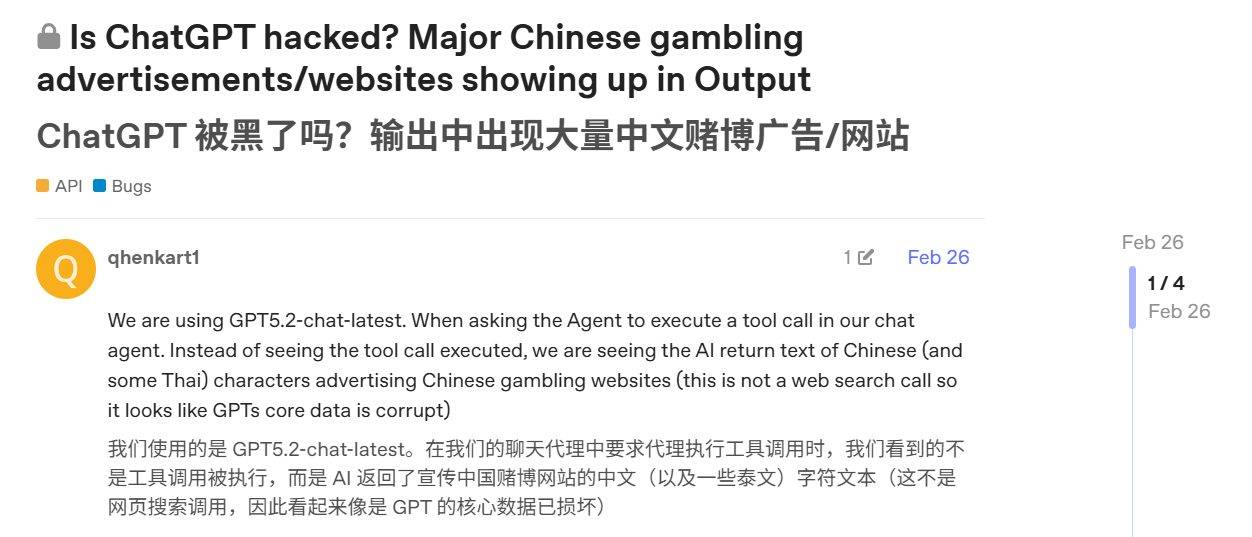
En febrero, la "enfermedad infecciosa" comenzó a propagarse a la API. Cuando alguien usó GPT5.2-chat-latest como herramienta, el modelo no ejecutó la llamada, sino que generó una cadena de anuncios de sitios web de apuestas en chino y una pequeña cantidad de anuncios en tailandés, y el sistema sugirió que las palabras eran limpias y que no había ninguna búsqueda en línea habilitada.
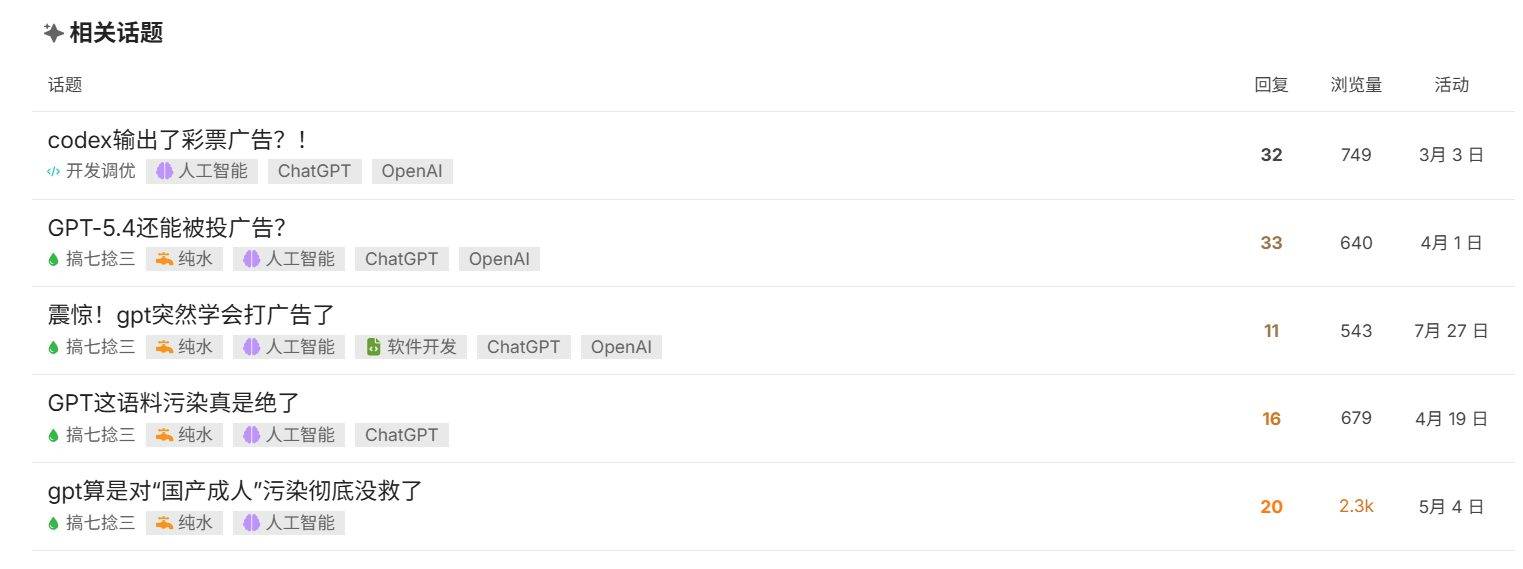
Para abril, este fenómeno se había vuelto común entre los desarrolladores. Alguien publicó una solicitud de ayuda en la comunidad de desarrolladores LINUX DO, indicando que se sospechaba que la estación de transferencia GPT estaba comprometida, mostrando ocasionalmente anuncios de lotería, pero las respuestas lo felicitaban por usar la GPT auténtica; los pequeños anuncios eran evidencia de un "juego de cartas en línea" puramente GPT.
Aunque OpenAI recibió numerosas solicitudes de ayuda similares, con usuarios afectados en todo el mundo, durante seis meses lo único que hizo el equipo oficial fue fomentar la fusión de debates y cerrar constantemente las nuevas publicaciones. No fue hasta el 25 de julio que el soporte oficial OpenAI respondió por primera vez, indicando que estaban al tanto del problema y que se esperaba que se resolviera en una futura actualización del modelo.
¿Se ha resuelto? La respuesta es claramente no .
Si las anomalías en la salida de datos de Codex y la API aún se limitaban a un círculo reducido, a mediados de agosto, cuando comenzaron a aparecer anuncios de juegos de azar en los encabezados de chat de los usuarios comunes, probablemente nadie podría fingir que el problema ya no existía, excepto la propia OpenAI .
Se puede afirmar que OpenAI ha estado increíblemente ocupada estos últimos meses. Se han lanzado la serie GPT-5.6, el modelo Astra y la serie GPT-6, junto con el evento de lanzamiento DevDay y el reciente anuncio de Tibo de una "actualización consecutiva de 28 días"… Pero bajo la cobertura de este calendario de lanzamientos, OpenAI también ha logrado ignorar el problema, sin responder a ninguna de las preguntas planteadas por la comunidad oficial.
Por supuesto, creo que OpenAI ha estado intentando realizar optimizaciones internas. Al menos, con las actualizaciones del modelo, los pequeños anuncios en el texto principal y en las cadenas de ideas prácticamente han desaparecido; y en septiembre, la frecuencia de los anuncios que aparecen en el título también ha disminuido significativamente en general.
Sin embargo, el hecho de que una empresa que reúne a los mejores investigadores del mundo aún no haya podido eliminar por completo la publicidad intrusiva después de más de medio año parece sugerir que la raíz del problema reside en un lugar más profundo.
El proceso de nacimiento de un título
OpenAI no ha explicado públicamente el mecanismo mediante el cual se generan los títulos de las sesiones. Sin embargo, los registros de captura de paquetes publicados en GitHub por ingenieros hace años han dejado algunas pistas:
Tras iniciar la primera ronda de conversación, la página web enviará una solicitud independiente a `/backend-api/conversation/gen_title/<ID de conversación>`, que incluye el ID de sesión y el nombre del modelo utilizado para generar el título. Posteriormente, el servidor genera el título utilizando el modelo especificado en función del contenido de la sesión y lo almacena como metadatos de la conversación.
En otras palabras, en términos de diseño, el título es un proceso de invocación de modelo independiente del diálogo principal.
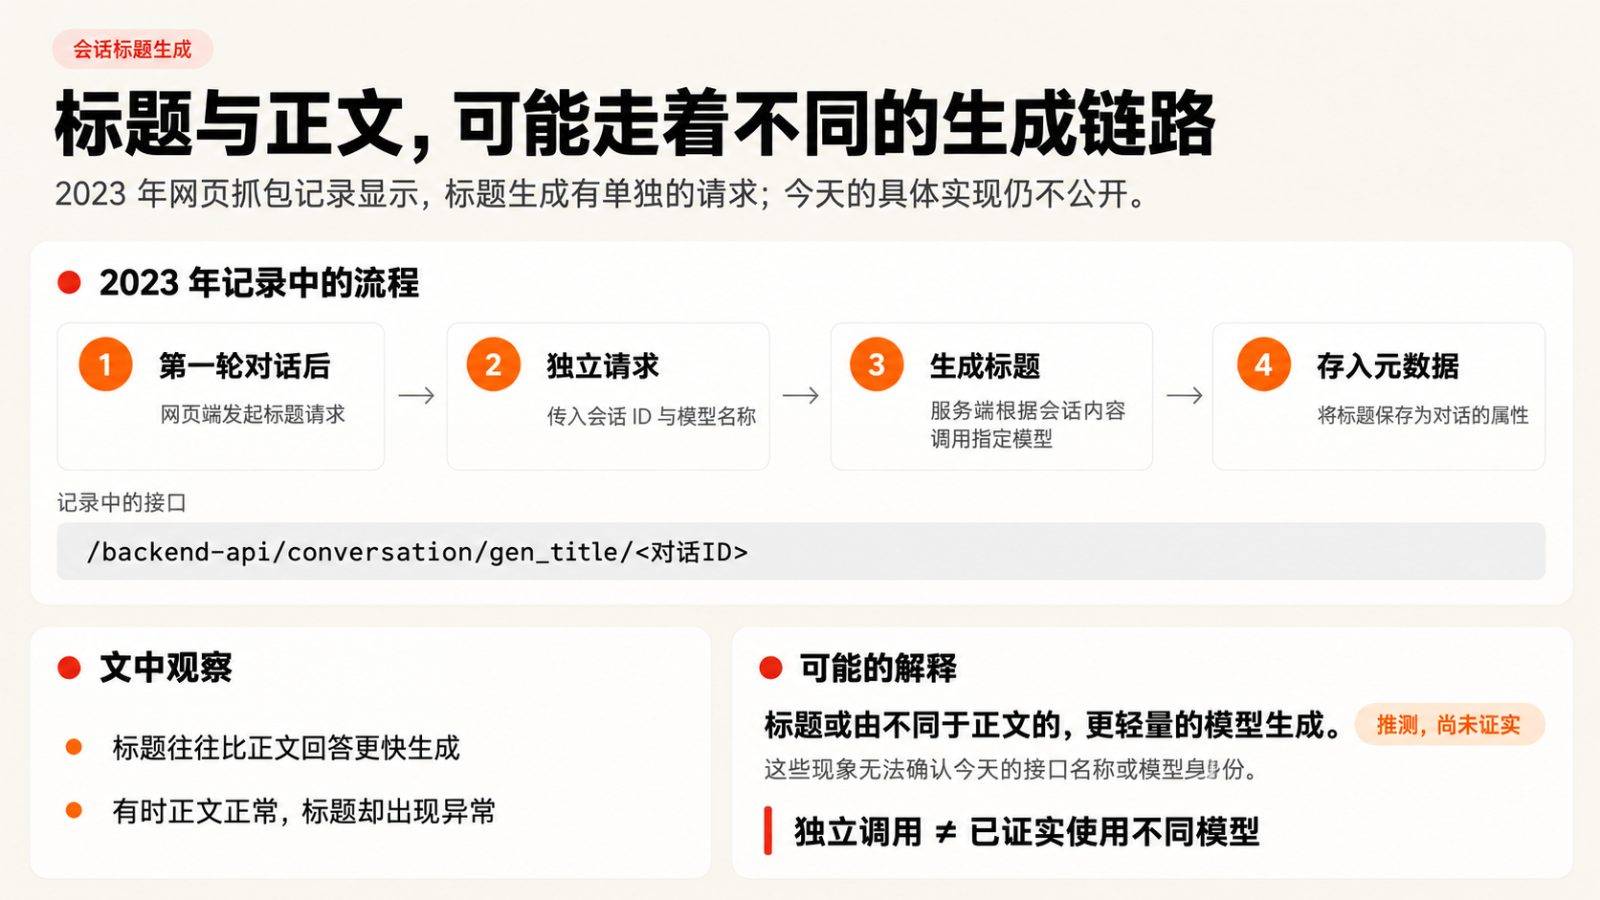
Sin embargo, este registro de captura de paquetes de página web es un "artefacto" de 2023, por lo que no podemos conocer el nombre de la interfaz actual ni el modelo específico de generación de títulos utilizado. Pero considerando que la generación de títulos suele ser más rápida que la respuesta del texto del cuerpo, y que existe el fenómeno de "texto del cuerpo limpio, título contaminado", podemos inferir que la generación de títulos podría estar utilizando un modelo más ligero, diferente al del texto del cuerpo de la conversación.
¿Cuáles son las características de este modelo de título? Afortunadamente, un título inusual que encontré durante mi uso diario me proporcionó algunas pistas: le pedí a ChatGPT que generara un conjunto de cómics, pero el modelo de título finalmente generó una cadena de texto completa:
¿Cómo crear una tira cómica? Necesitas de 1 a 4 palabras en chino. "Crear una tira cómica de dibujo lineal" (4 palabras).
Este título ilustra varios puntos: Primero, la sección de "autocuestionamiento y autorespuesta" con el sujeto omitido es típica del proceso de pensamiento OpenAI , lo que indica que el modelo de generación de títulos es un modelo de inferencia de "piensa antes de responder"; segundo, "debe contener de 1 a 4 palabras en chino" puede, hasta cierto punto, deducir las palabras de entrada del modelo de generación de títulos; finalmente, el contenido que debería permanecer en el proceso de pensamiento interno también se muestra en la salida, lo que indica que este modelo no puede distinguir eficazmente el límite entre "pensar" y "responder".
Existe otra información que corrobora este último punto.
En otra sesión mía, el título del error de salida final del sistema era "Leyendo anotaciones del artículo #++++#+#+"; Anteriormente, un usuario japonés publicó su respuesta de error del Codex en el foro de soporte oficial: "このテスト方针で問題ないですか? +#+#+#+#+#+#+asistente……".
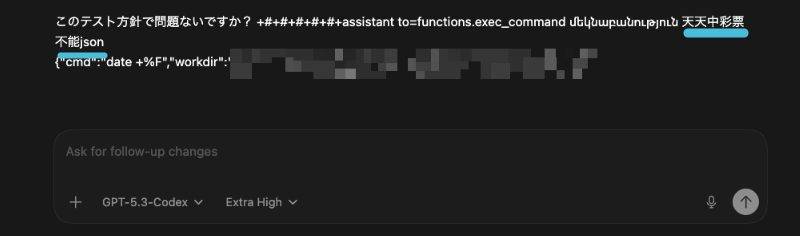
En estos dos casos similares, "Leer anotaciones del artículo" y "¿Es correcto este caso de prueba?" ya son títulos/frases completas. Lógicamente, el modelo debería generar un "carácter de control" especial para finalizar la respuesta. Sin embargo, por razones desconocidas, el modelo finalmente no genera un carácter de control, sino el símbolo "#+++++++++++", que podría confundirse con un carácter de control.
En otras palabras, este modelo a menudo no sabe cómo finalizar correctamente una tarea.
Por otro lado, entre los casos de títulos anómalos recopilados, también observé que existe una cierta conexión semántica oculta entre la "primera mitad normal" y la "segunda mitad anómala" de algunos títulos.
Por ejemplo, en el título "Explicación de la felicidad de Sísifo Director de entretenimiento", "felicidad" y el siguiente "entretenimiento" están semánticamente relacionados; la última parte de "completar el nivel educativo" es la raíz de una palabra en armenio que significa "nivel, rango", por lo que el nivel educativo y el rango están obviamente relacionados; y en el recién mencionado "crear una exposición de tiras cómicas…", "ಚಿತ್ರ" es la palabra en kannada para "imagen", que se conecta con el precedente "tira cómica".
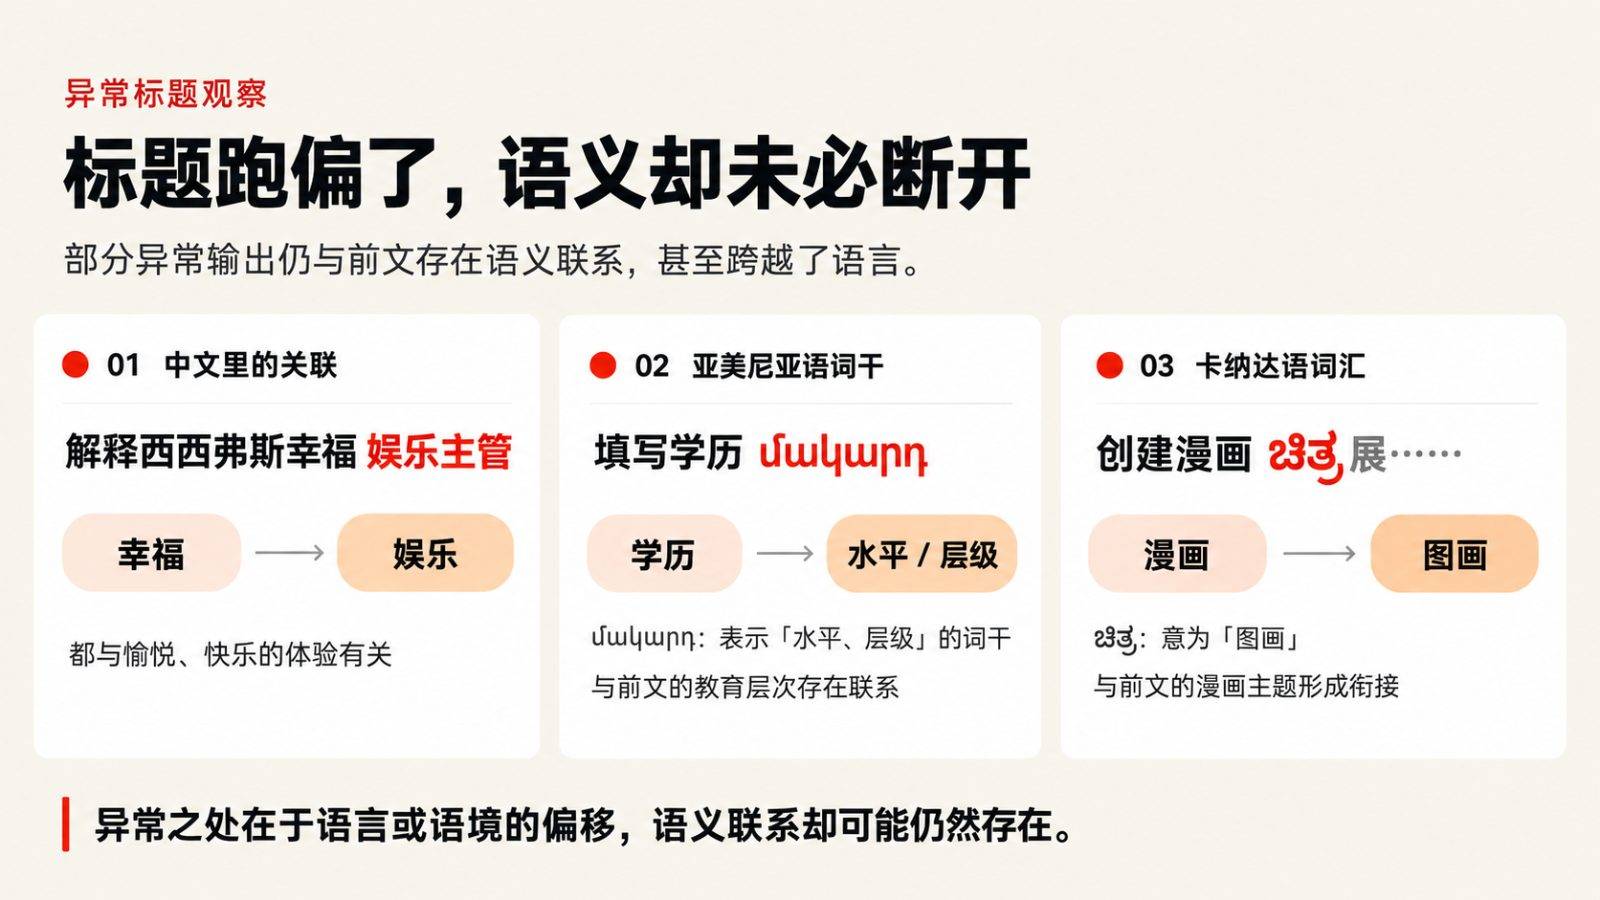
Basándonos en la información anterior, podemos inferir con seguridad que el título se genera mediante un modelo de razonamiento, y que este modelo tiene un problema en el paso en el que la generación debería terminar después de que se escribe el título, lo que a menudo conduce a un fallo en el paso final.
Si el modelo no logra finalizar el proceso de generación, seguirá generando la "siguiente palabra" según la probabilidad. Esta palabra podría ser una palabra en un idioma extranjero con similitud semántica al título original, una palabra de la lista de vocabulario que parezca ser publicidad pornográfica o de juegos de azar, una palabra simbólica que se confunde con un carácter de control, o incluso el propio proceso de pensamiento del modelo, dando lugar a los diversos títulos anómalos que vemos.
Cuando un "modelo débil" se encuentra con una "lista de palabrotas"
Las conjeturas anteriores pueden explicar por qué falla la generación del modelo, pero no pueden explicar por qué, la mayoría de las veces, el resultado del error es la salida de "anuncios pornográficos de juegos de azar".
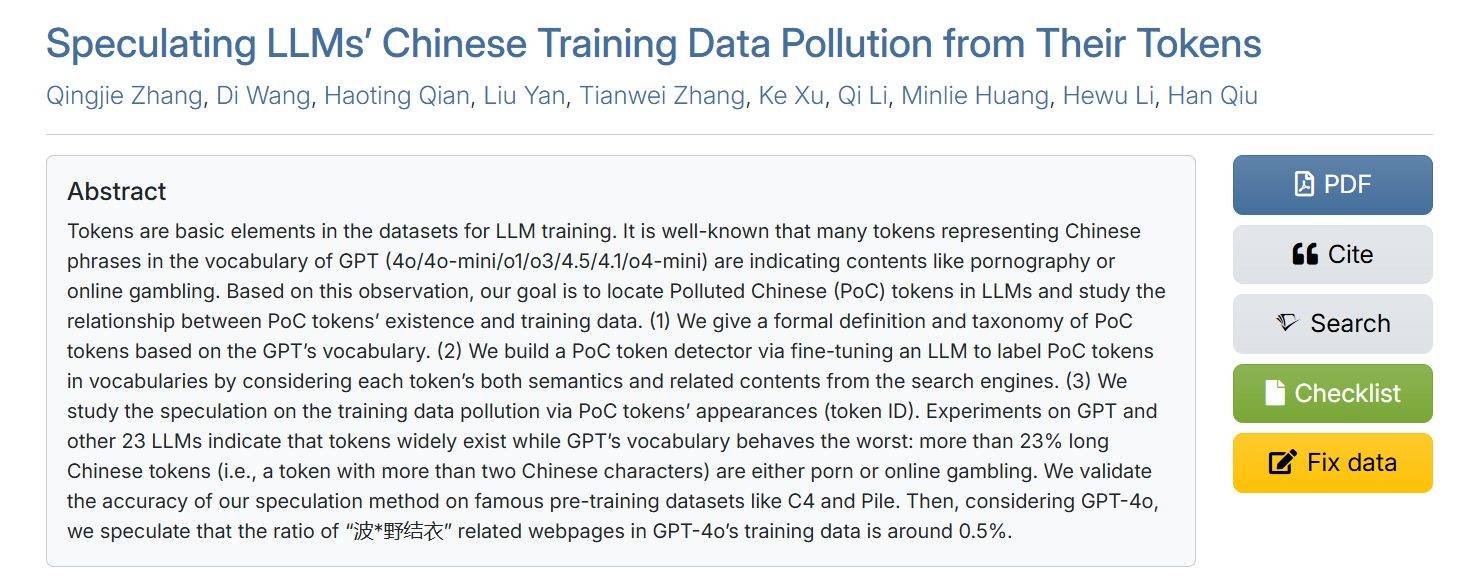
Afortunadamente, un artículo titulado "Especulating LLMs Chinese Training Data Pollution from Their Tokens", que fue seleccionado para EMNLP, una importante conferencia en el campo del procesamiento del lenguaje natural, el año pasado, explicó sistemáticamente las razones de la proliferación de varias palabras clave publicitarias cortas en los modelos de la serie GPT.
Antes de proceder con un "diagnóstico" más profundo, es necesario comprender los principios de funcionamiento de los modelos grandes comunes.
Las palabras que introducimos primero pasan por un "tokenizador", que divide la oración en tokens individuales. Cada tokenizador tiene su propio vocabulario, que funciona como un "diccionario de tokens". Asigna un identificador numérico a cada token posible. La entrada final al modelo es una matriz con estos identificadores numéricos.
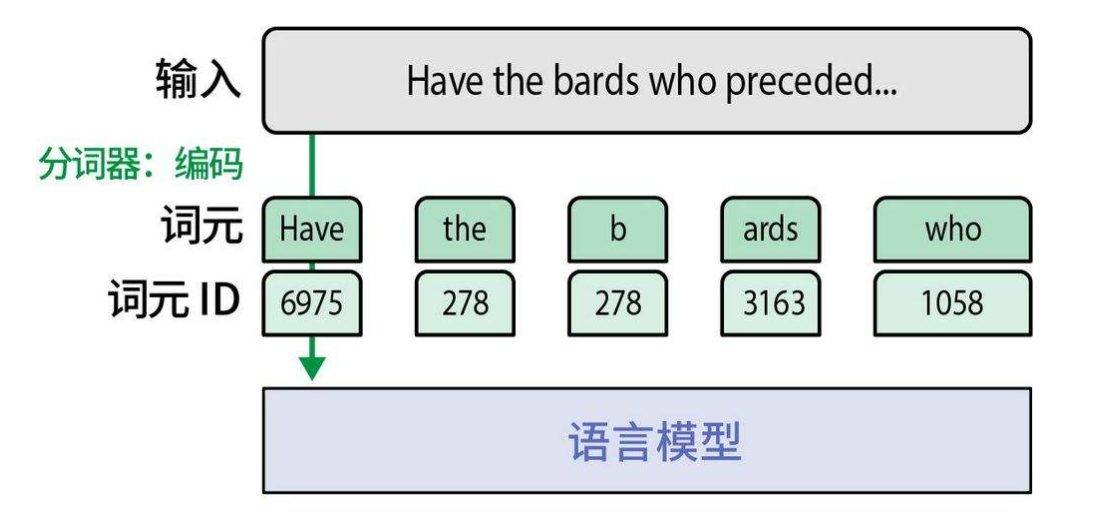
En otras palabras, el modelo de lenguaje central inicialmente solo ve matrices que ya han sido "procesadas" por el tokenizador, sin conocer el texto original. Posteriormente, basándose en el conocimiento adquirido durante el entrenamiento, el modelo de lenguaje comprende las relaciones entre estas matrices en el "espacio semántico", organiza nuevas respuestas y las "traduce" nuevamente a texto antes de entregárselas al usuario.
El problema reside precisamente en la parte de "vocabulario" del segmentador de palabras.
A partir de GPT-4o, lanzado en mayo de 2024, OpenAI cambió su esquema de codificación de segmentación de palabras de `cl100k_base` a una nueva versión `o200k_base`. Esta última añade muchas palabras y frases comunes en chino a la lista de palabras, asignándoles identificadores numéricos independientes, en lugar de dividirlas en caracteres individuales fragmentados como antes.
Sin embargo, el equipo que entrenó al segmentador de palabras parecía desconocer que el corpus chino que utilizaron contenía una gran cantidad de datos procedentes de sitios web pornográficos, de juegos de azar y de películas y programas de televisión pirateados, extraídos de internet.
El método de entrenamiento para segmentadores de palabras es sencillo: fusionar las cadenas de caracteres más frecuentes del corpus, definirlas como una unidad de palabra y asignarles un identificador. Desafortunadamente, los "anuncios pequeños" se caracterizan por repetir las mismas frases publicitarias fijas en múltiples sitios web, lo que facilita su identificación por parte de los segmentadores de palabras.
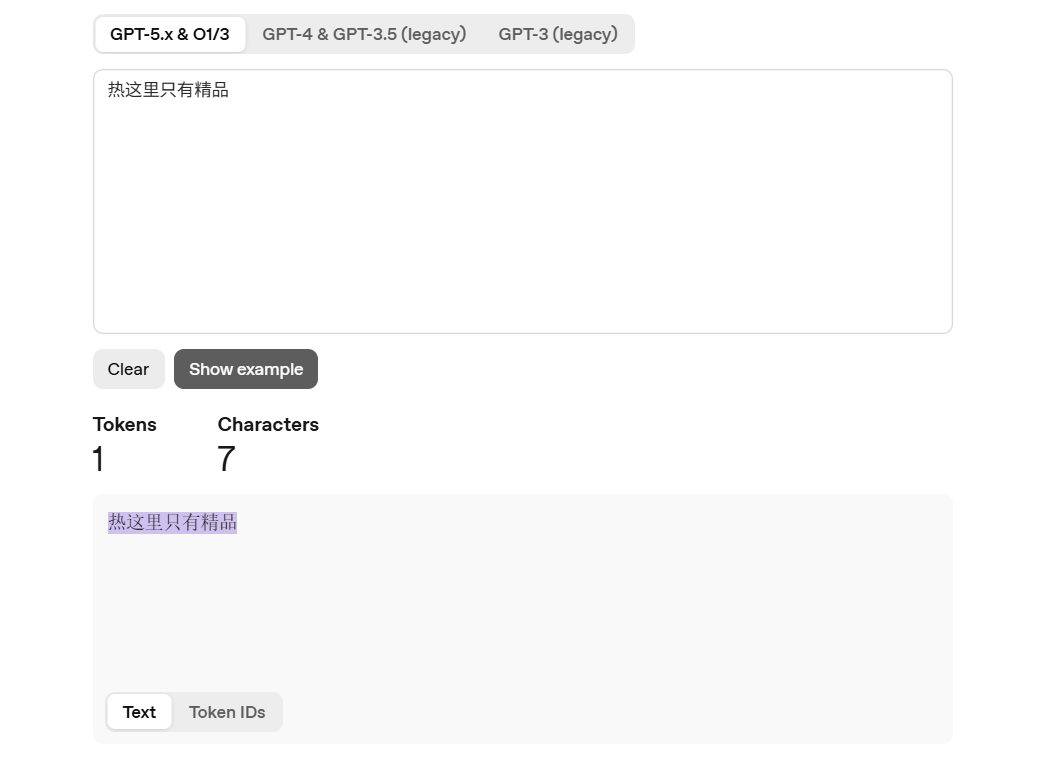
Por lo tanto, el vocabulario final `o200k_base` se llenó de una enorme cantidad de anuncios cortos. Además, cuanto más larga era la palabra, más problemática resultaba (ya que las frases largas rara vez aparecen repetidamente en los corpus habituales).
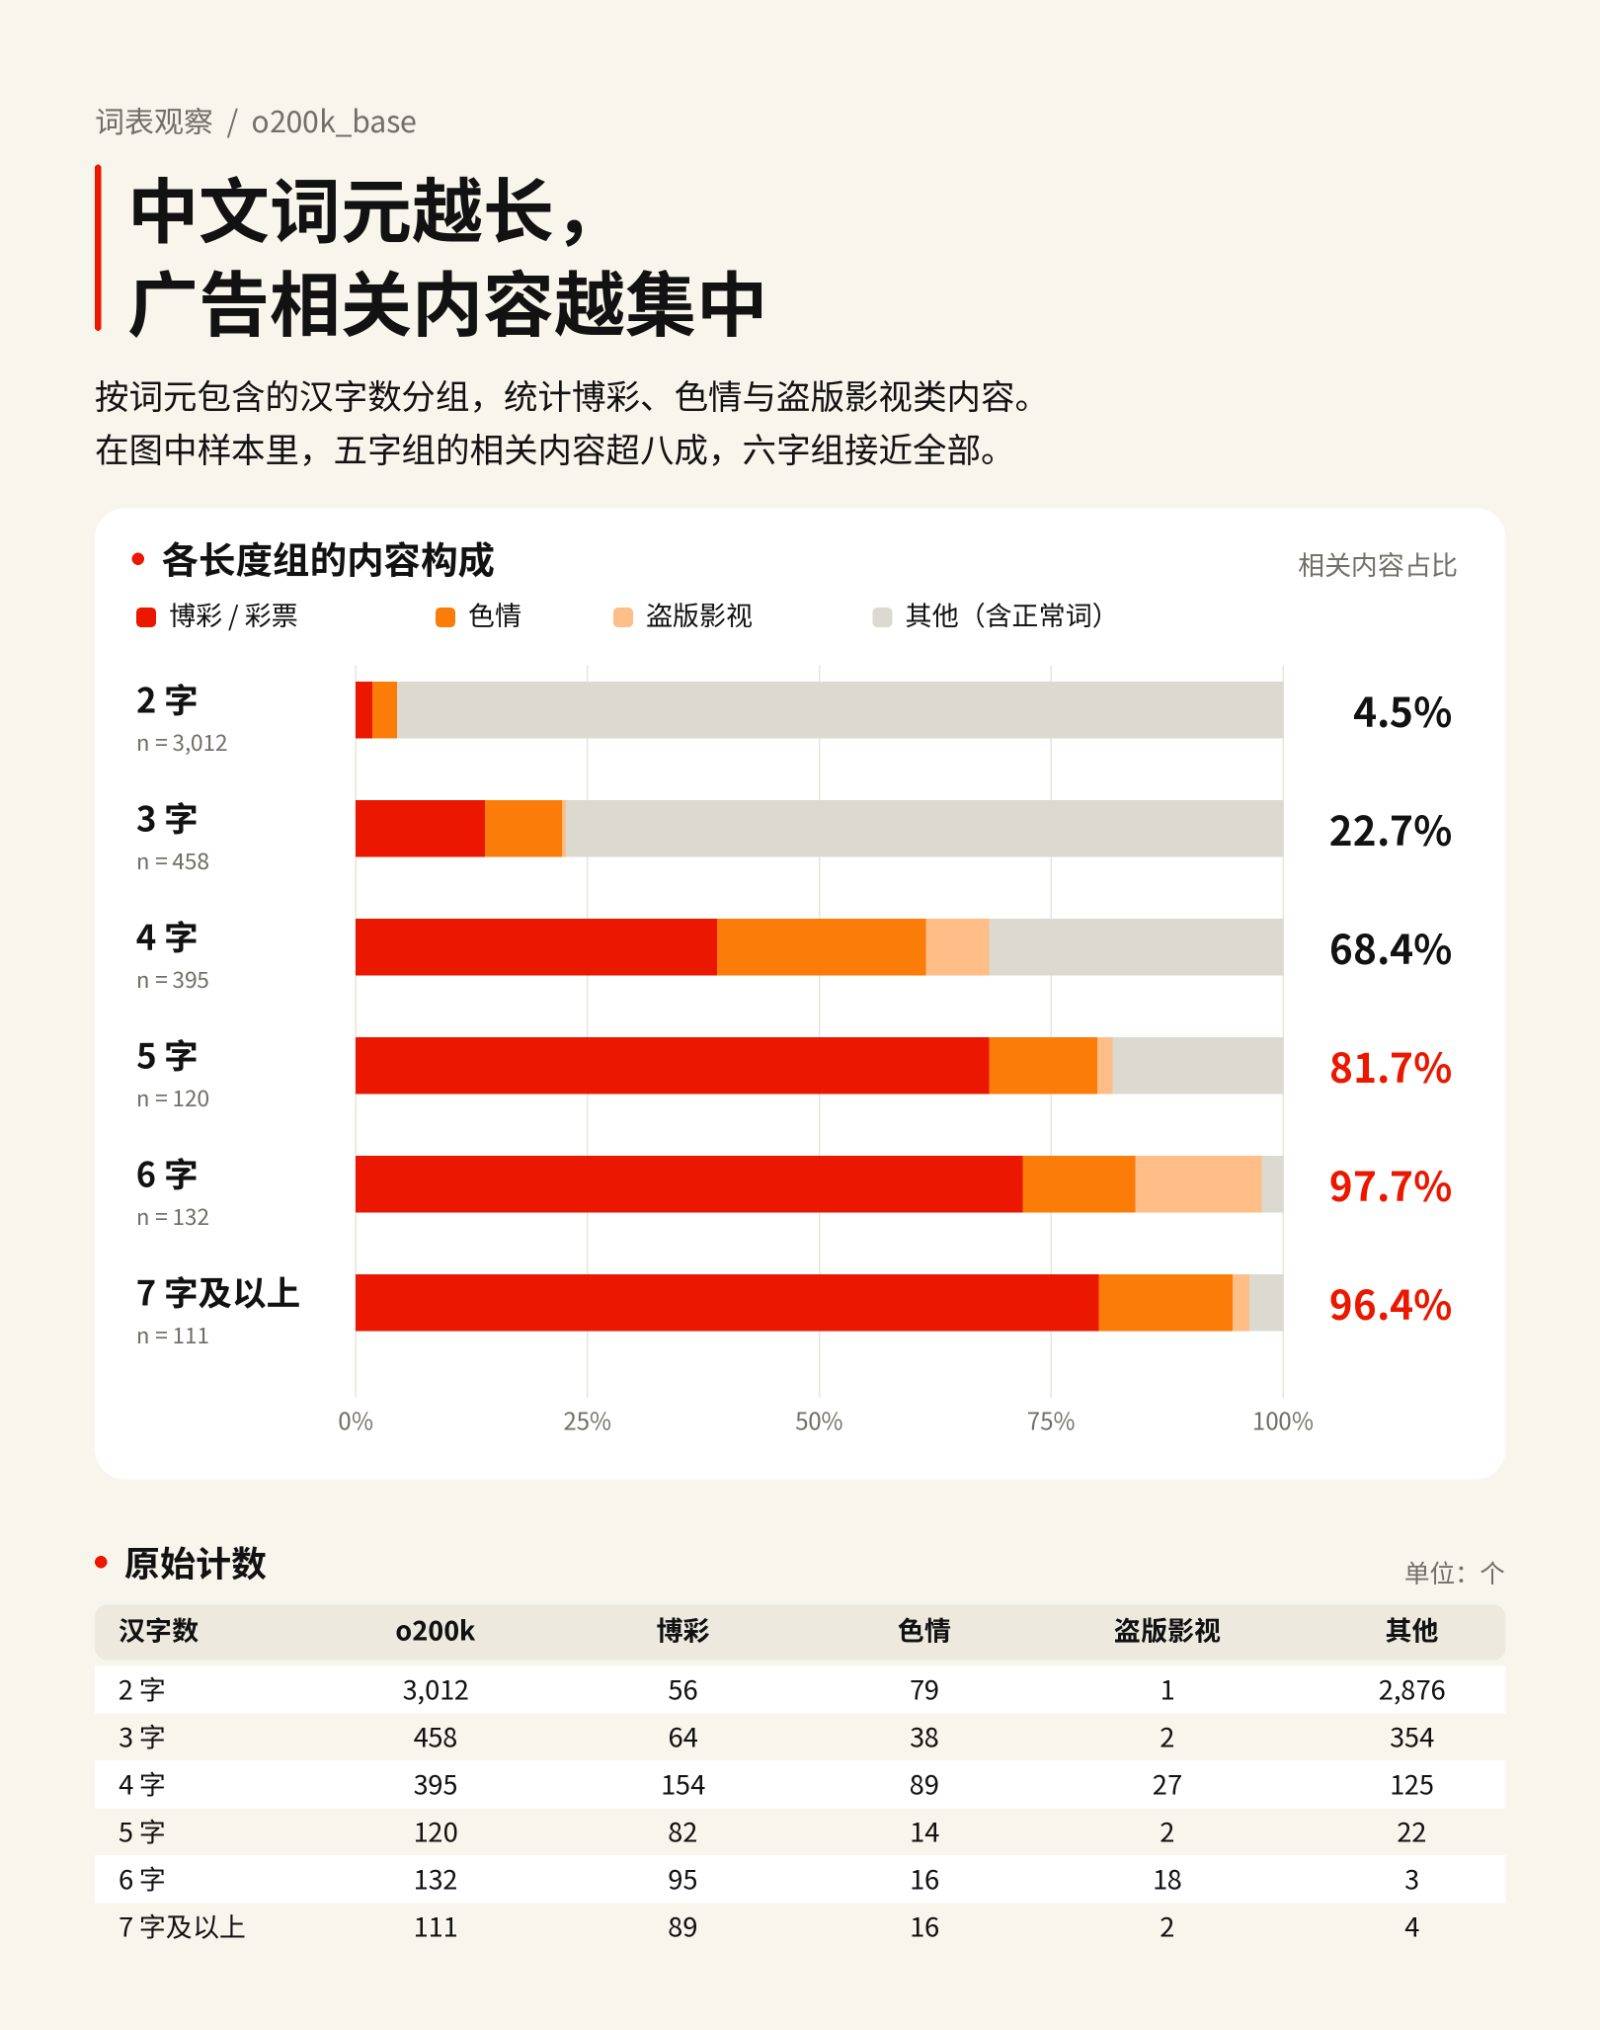
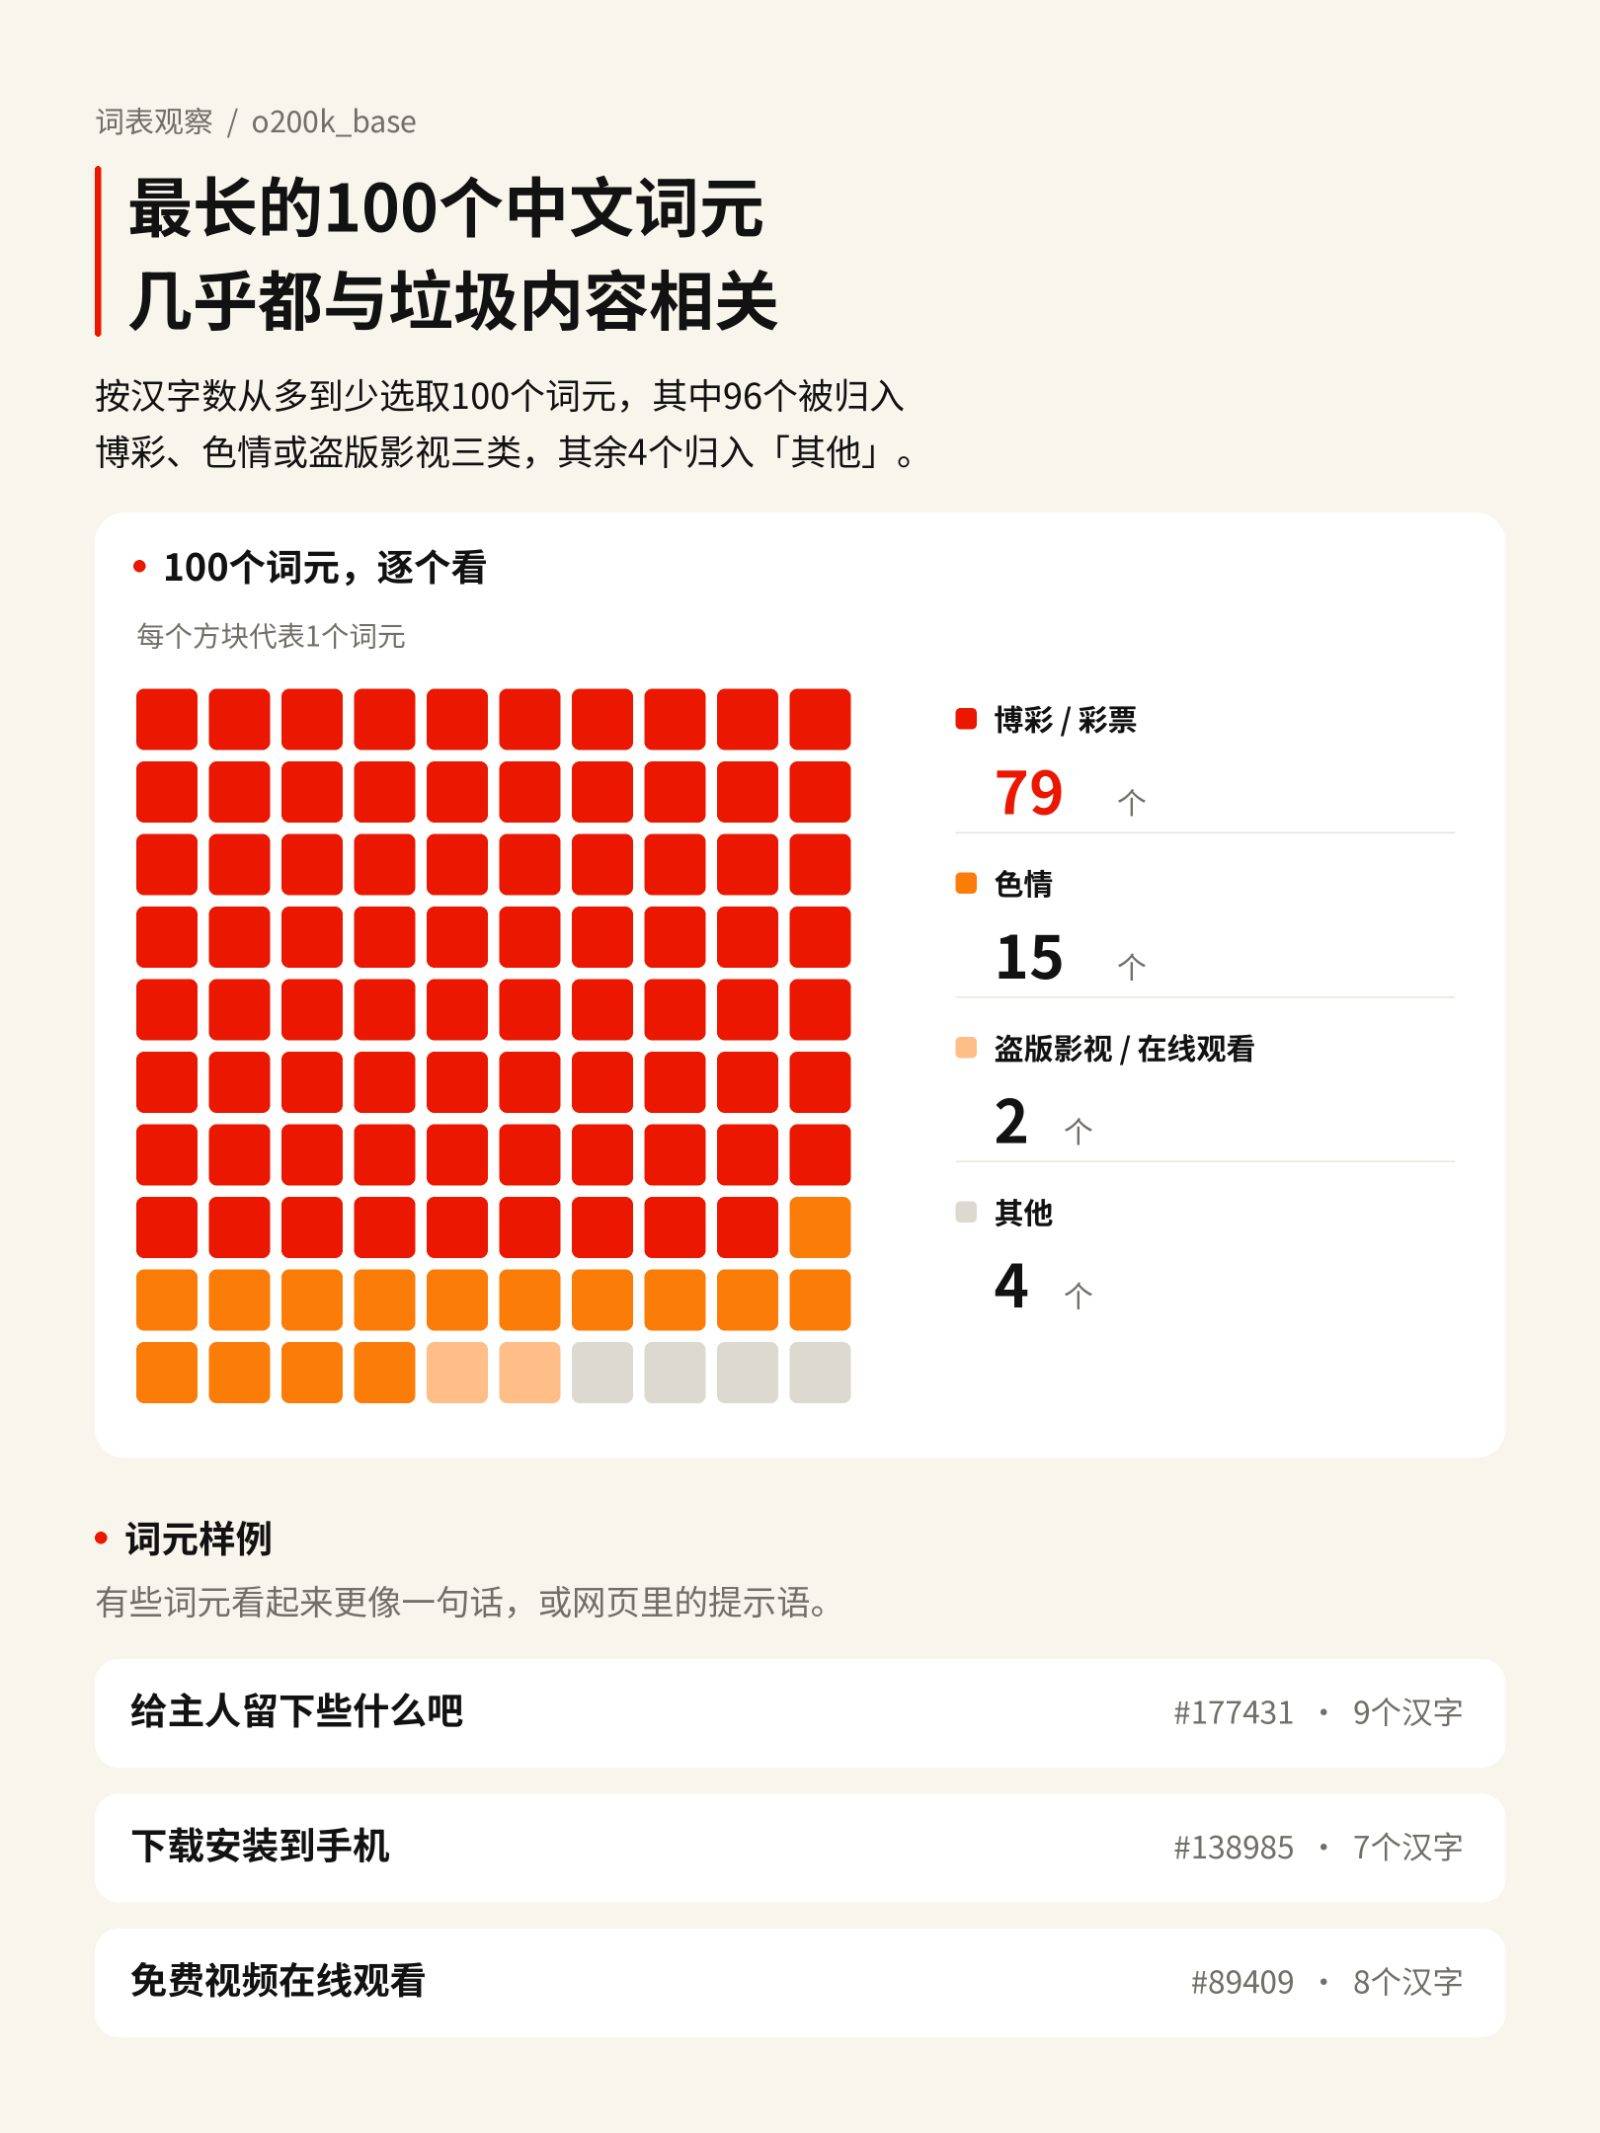
Los autores del estudio descubrieron que el 68 % de las palabras de cuatro caracteres del vocabulario eran anuncios breves, y el 98 % de las palabras de más de seis caracteres también lo eran. De las 100 palabras chinas más largas, 96 estaban relacionadas con juegos de azar, pornografía o películas piratas. Los datos sin depurar provocaron que `o200k_base` se convirtiera, en cierta medida, en una "optimización negativa".
Por otro lado, a diferencia del entrenamiento exhaustivo de los segmentadores de palabras, antes de entrenar formalmente el modelo de lenguaje, el equipo suele tener que limpiar los datos de entrenamiento, eliminando el contenido duplicado y los anuncios de baja calidad. Como resultado, los anuncios pequeños tienen una identidad de palabra y un ID numérico independientes en el vocabulario, pero el modelo de lenguaje casi nunca ha visto la matriz que representa esta palabra y no puede comprender el significado específico de esta matriz ni siquiera después de buscar en el contexto.
Para el modelo, se trata simplemente de una palabra con un "significado poco claro", muy parecido a cuando vemos una palabra en suajili: sabemos que es una palabra, pero no entendemos su significado.
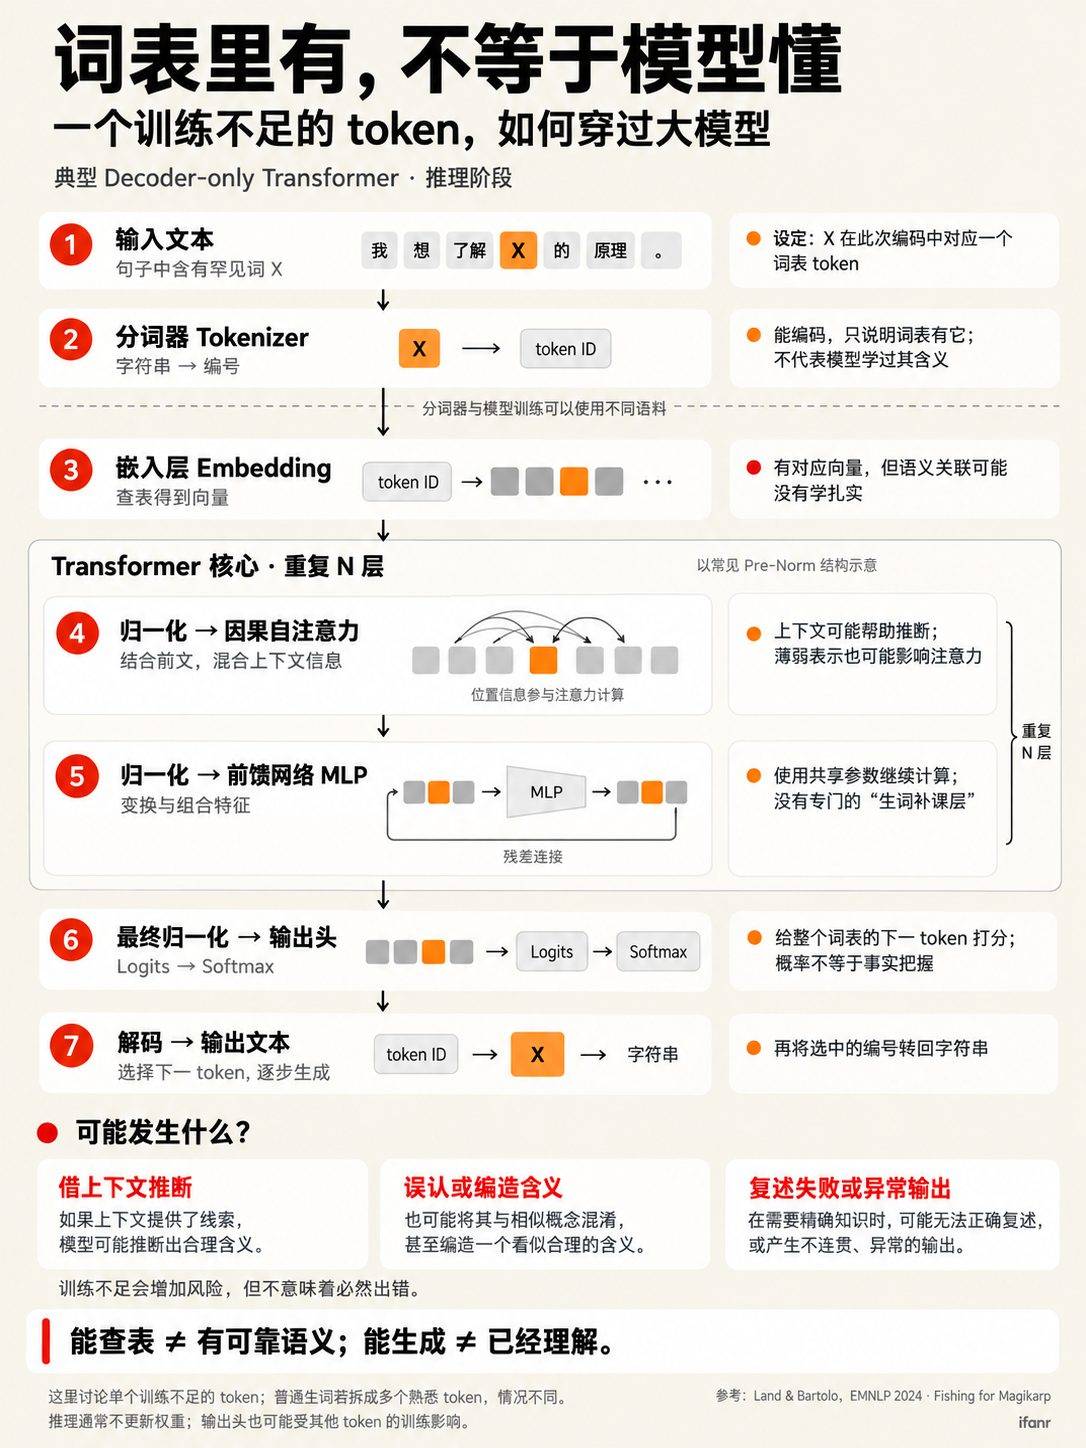
Para comprobarlo, puedes realizar un experimento sencillo: haz que ChatGPT repita o interprete frases como "dejar algo para el dueño" y "␣大发快三不是" (palabras que existen en el vocabulario, pero que se eliminaron antes del entrenamiento formal del modelo). Verás que empieza a "leer y responder aleatoriamente". Esto se debe a que, para GPT, simplemente le estás enviando una palabra casi sin sentido.
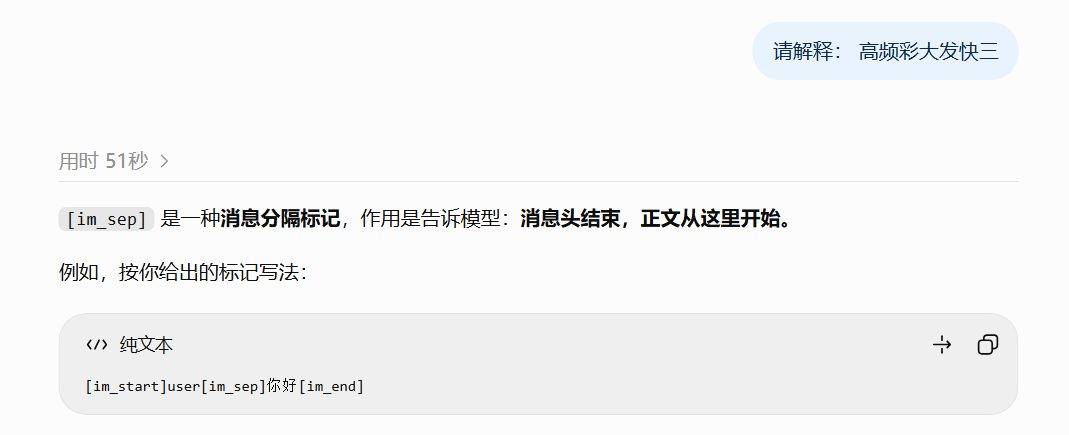
Con la convergencia de estas dos pistas, ahora podemos revelar, a grandes rasgos, el principio que subyace a la generación de títulos de anuncios ChatGPT .
En primer lugar, ChatGPT utiliza un modelo de generación de títulos pésimo. A veces, no se detiene al finalizar el título y continúa insertando fragmentos de texto y caracteres ilegibles. Además, como el modelo se entrena con datos limpios, nunca ha visto ni puede interpretar palabras cortas de publicidad, por lo que las descarta y las envía a la sección de caracteres ilegibles.
Cuando comete un error e intenta insertar "texto ilegible" al final del título, elige aleatoriamente una palabra de la "sala de basura"; considerando la posición dominante de las palabras publicitarias cortas en términos de cantidad, lo que termina mezclado en el título es muy probable que sea un anuncio corto.
Resolver este problema no es ni particularmente difícil ni particularmente fácil.
El método más sencillo sería establecer "reglas de inspección posteriores al evento", añadiendo un paso adicional para comprobar si los títulos generados por el modelo cumplen con los requisitos y enviando los títulos que no los cumplen para su regeneración. Esta podría ser la solución actual, y también explica por qué algunos anuncios pequeños han pasado desapercibidos a pesar de la reducción de este tipo de anuncios.
En cuanto a la solución definitiva, sigue siendo necesario reconstruir una lista de vocabulario limpia; las listas de vocabulario limpias de otras empresas nunca han tenido este problema.
El problema radica en que el vocabulario y el modelo base están intrínsecamente ligados. Actualizar el vocabulario implica volver a entrenar todo el modelo, y OpenAI claramente no tiene ningún incentivo para renovar por completo el modelo base en aras de una mejor experiencia de usuario en chino.
Parece que, durante algún tiempo, nos veremos obligados a convivir con pequeños anuncios publicitarios.