Apostando por la memoria nativa, MemT 1.0 rompe con los esquemas establecidos en la segunda mitad de la era de la IA aplicada al aprendizaje
Uno de los momentos más frustrantes con la IA es cuando pasas medio día corrigiéndola para que realice la tarea correctamente, solo para que vuelva a caer en el mismo error en una nueva sesión. El modelo ha cumplido su función, pero no se ha convertido en una experiencia de aprendizaje. Más allá de lograr que una sola tarea funcione, lo que realmente le falta es la capacidad de transformar la retroalimentación en experiencia y aplicarla de forma proactiva en el futuro.
Esta desconexión resulta especialmente evidente en la moda de los asistentes personales impulsada por Meta Muse, OpenAI Dots y xAI Grok Bot: las búsquedas en complementos convencionales se reducen, en el mejor de los casos, a consultar notas estáticas, incapaces de consolidar el proceso de entrenamiento en una comprensión tácita, que es precisamente el umbral fundamental para los asistentes a largo plazo.
Hoy se ha lanzado oficialmente MemT 1.0, un modelo de memoria nativo a gran escala, y se ha liberado su código fuente.
La principal diferencia con las soluciones externas mediante complementos no reside solo en que separa la memoria de los módulos externos y la integra en la arquitectura subyacente, sino también en que el modelo aprende a leer, escribir, actualizar y acceder a la memoria mediante el entrenamiento, lo que convierte la acumulación de experiencia en parte de las capacidades del modelo.
Incorpore los recuerdos en la esencia misma del modelo.
La mayoría de las soluciones del mercado prefieren almacenar los registros de chat como una forma de memoria, pero almacenar solo un registro de los eventos diarios no puede gestionar las interacciones dinámicas del mundo real y aún está lejos de ser un verdadero asistente.
El informe técnico de MemT 1.0 menciona una prueba exhaustiva: el usuario primero indicó la fecha original de la exposición, luego la reprogramó para el domingo y mencionó casualmente una fecha alternativa para el lunes que no fue aceptada. Posteriormente, ambas partes conversaron durante más de 500 rondas, acumulando aproximadamente 66 000 tokens en los registros de chat, sin volver a mencionar la exposición.
Si se recurre a las herramientas de búsqueda externas tradicionales, es fácil confundir una conversación informal con conclusiones definitivas cuando se enfrenta a una gama tan amplia de múltiples versiones de información; sin embargo, MemT 1.0, en un estado de "libro cerrado" completamente desvinculado del texto original, aún informaba con precisión las horas originales y reprogramadas, indicando claramente que el lugar, el precio de la entrada y la persona de contacto permanecían sin cambios, y distinguiendo claramente entre la conclusión del domingo y la alternativa del lunes.
La razón por la que esto es posible es que MemT 1.0 sigue un enfoque técnico "nativo de la memoria".
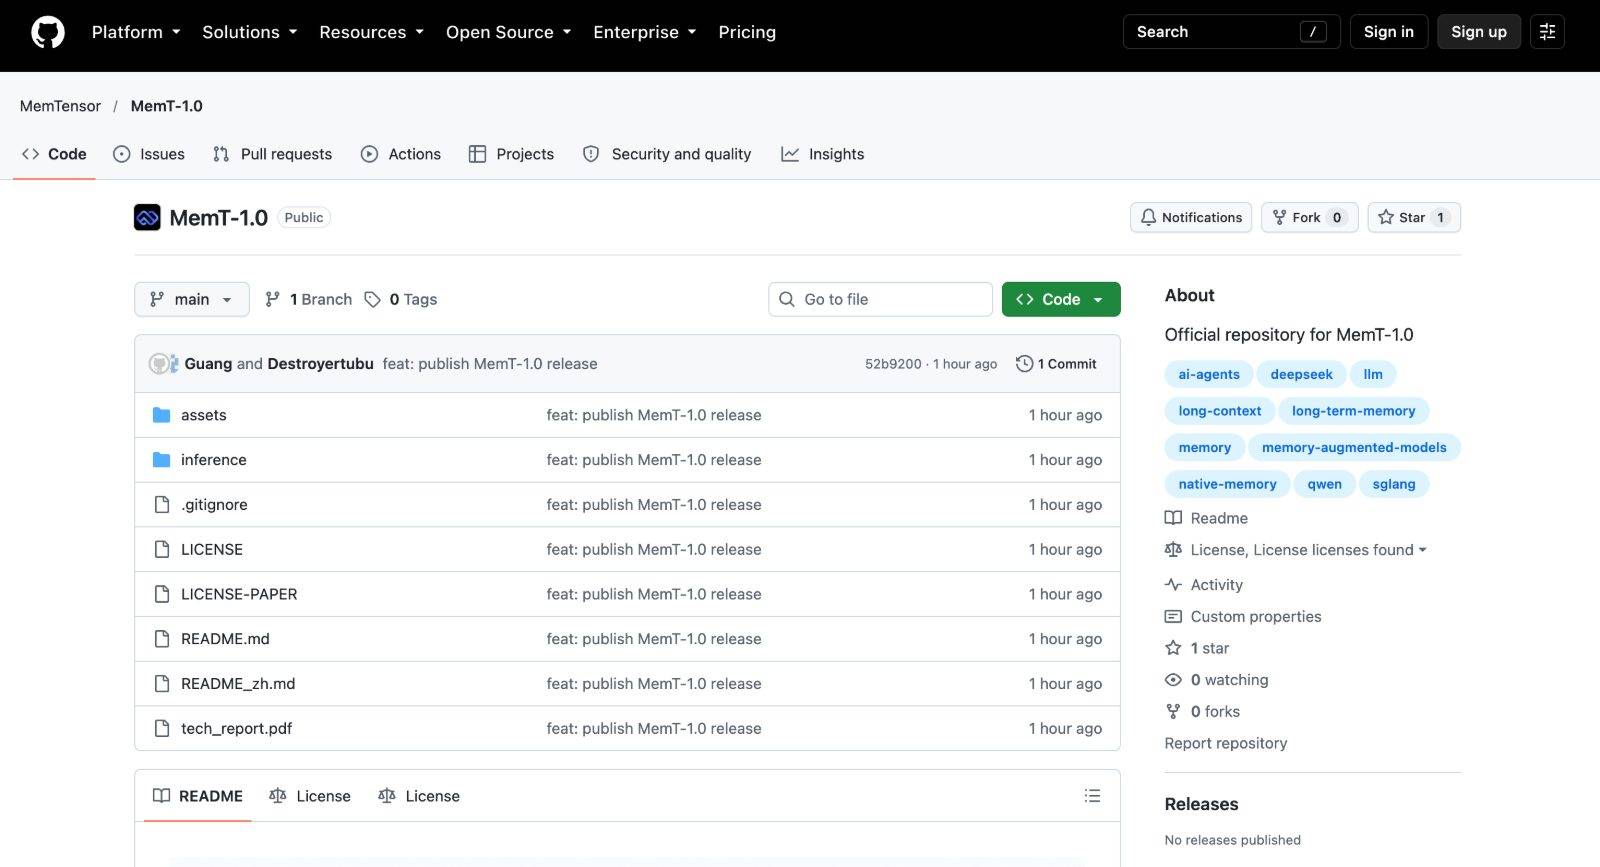
 Código: https://github.com/MemTensor/MemT-1.0
Modelo: https://huggingface.co/collections/MemTensor/memt-1
En términos de diseño arquitectónico, MemT 1.0 divide la "capacidad intelectual" del modelo en dos partes:
- Red troncal (capacidades generales): Al igual que la configuración de fábrica de la IA, está equipada con su comprensión general del mundo.
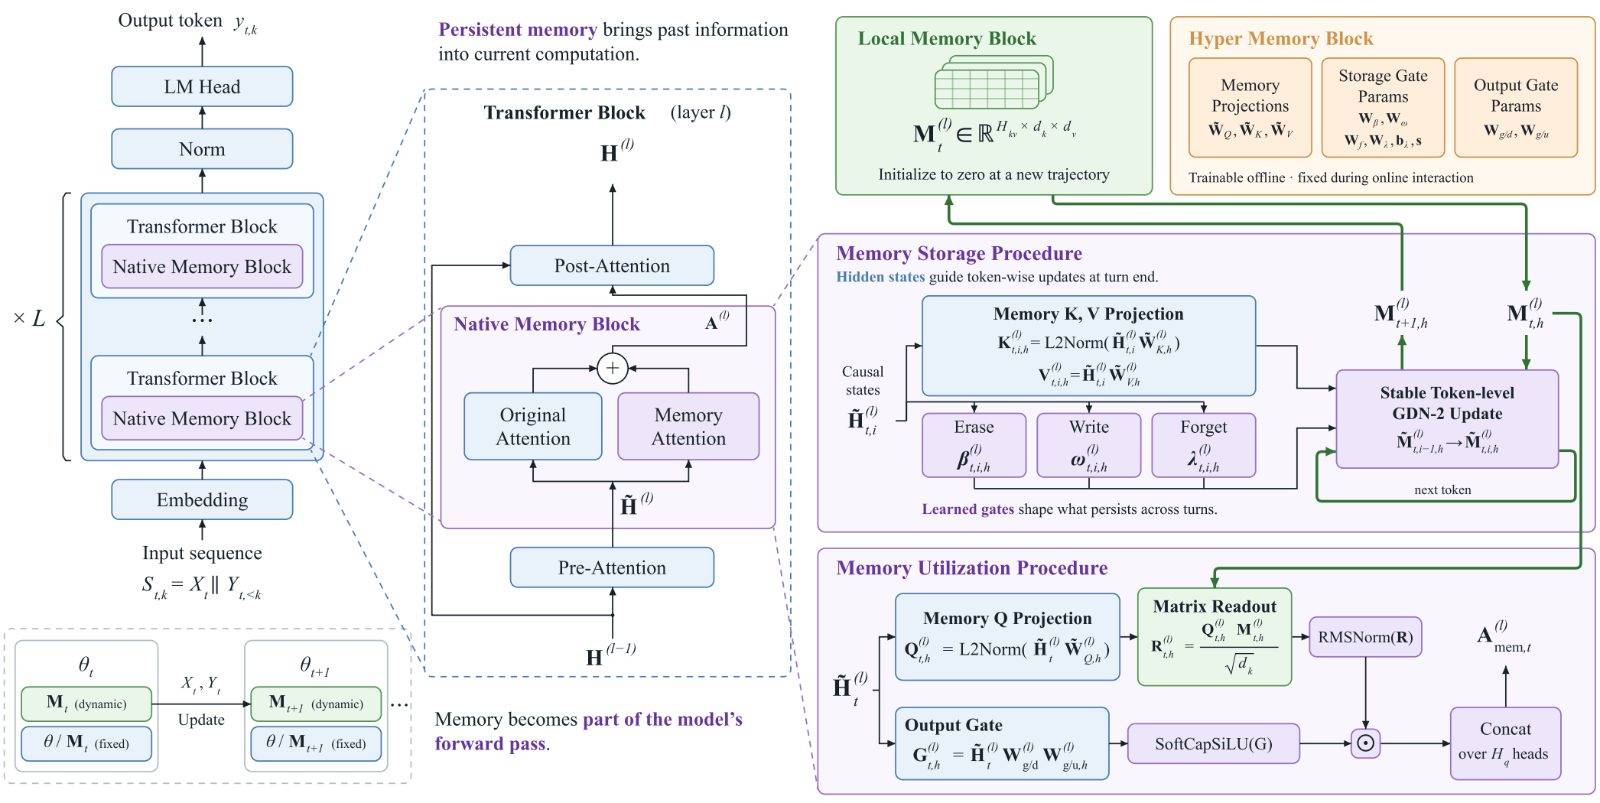
- Estado de memoria dinámica (memoria independiente): Esto equivale al "estado de trabajo dedicado" del modelo, que evoluciona en tiempo real dentro de una trayectoria de interacción específica. Los diferentes usuarios o tareas son independientes entre sí, absorben dinámicamente nueva información y experiencia en una interacción continua, y participan directamente en cada ronda posterior de cálculo de generación.
Ante un flujo constante de información interactiva, MemT-1.0 no necesita reentrenar todo el modelo. Al final de cada ronda de diálogo, actualiza directamente el estado de la memoria mediante un mecanismo de actualización a nivel de token. En cuanto a qué información conservar y cuál modificar, el modelo decide de forma autónoma basándose en un mecanismo de filtrado aprendido durante el entrenamiento.
Esto explica por qué, en la prueba mencionada, que incluyó más de 500 rondas, el modelo pudo filtrar automáticamente las conversaciones irrelevantes y sobrescribir los estados obsoletos cuando cambió el horario, fijando así la conclusión del domingo. En las conversaciones y la ejecución de tareas posteriores, el mecanismo de atención de memoria paralela recupera continuamente estos estados acumulados, participando directamente en el cálculo actual y guiando la siguiente decisión del modelo.
Por supuesto, esta capacidad precisa para tomar decisiones no puede ser innata; debe desarrollarse mediante el trabajo duro.
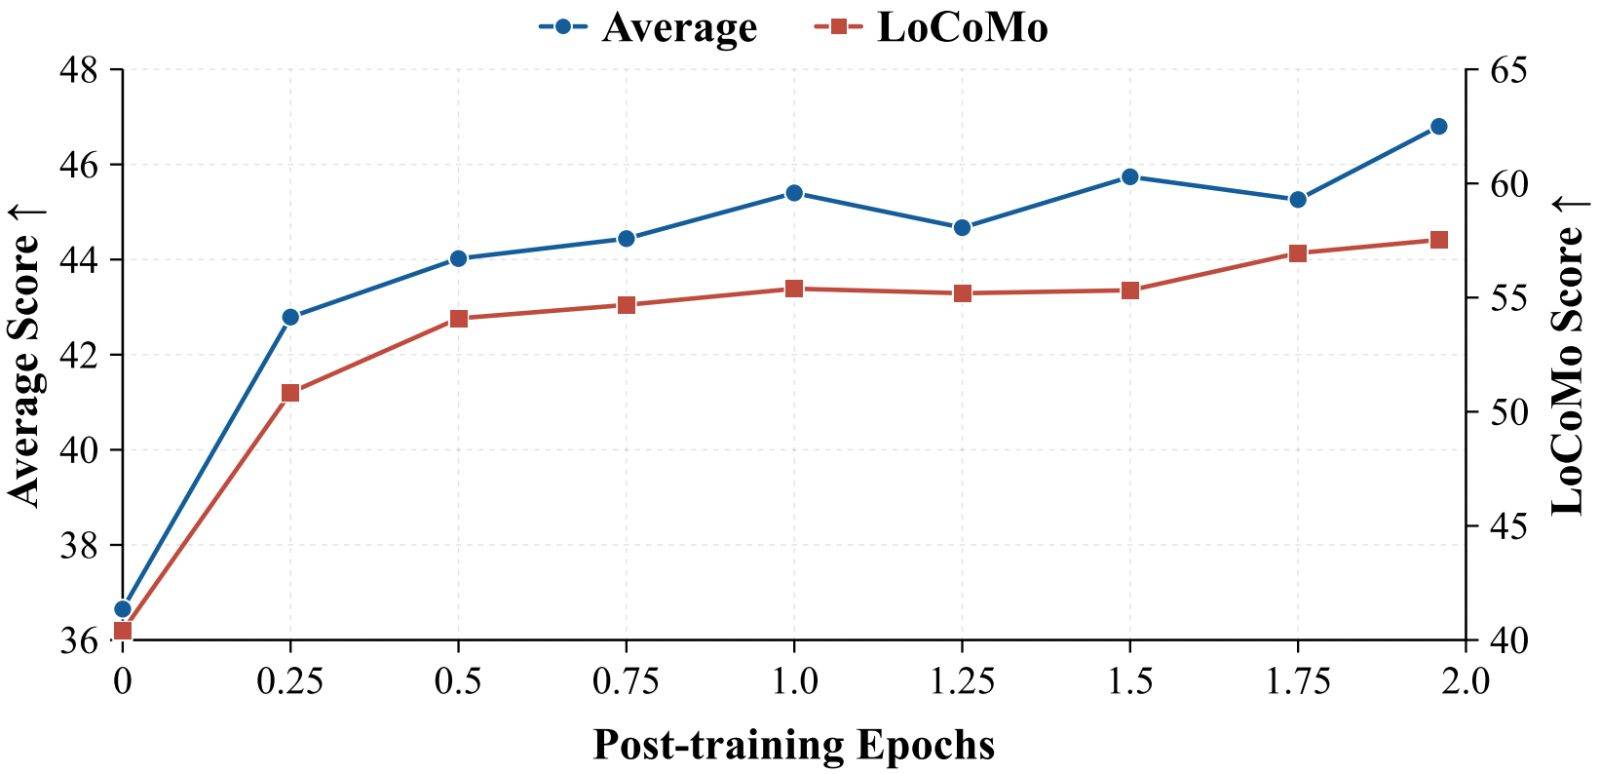
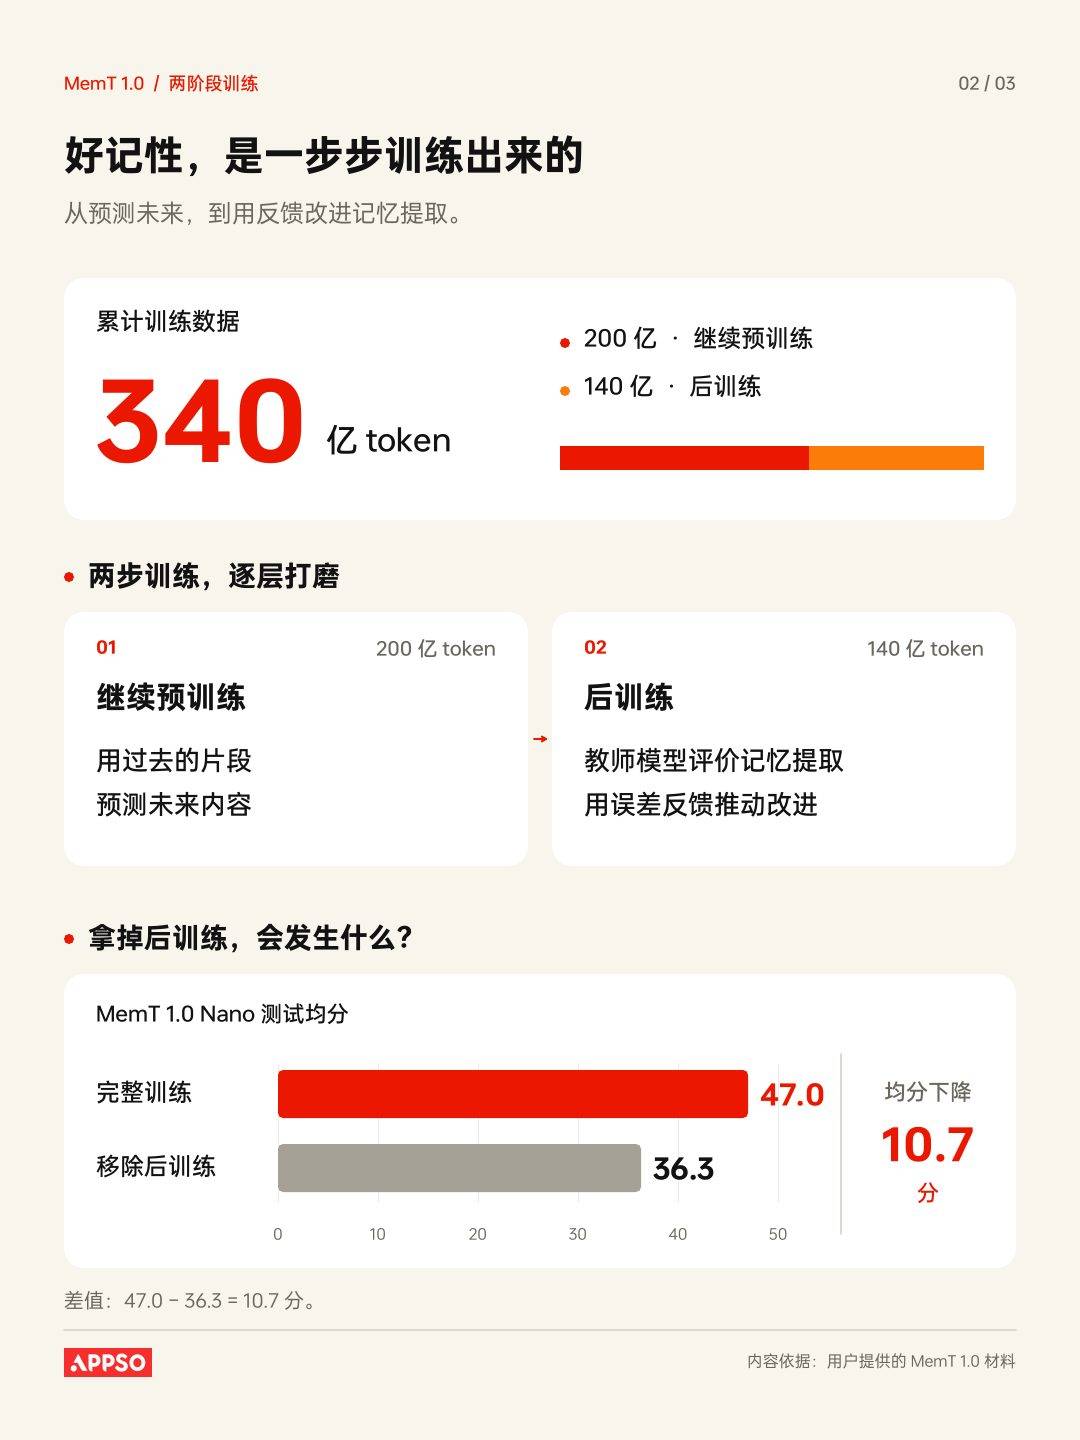
El equipo alimentó el modelo con 34 mil millones de tokens de datos y perfeccionó el mecanismo en dos pasos: primero, utilizaron 20 mil millones de tokens para el preentrenamiento, lo que permitió al modelo intentar predecir el futuro utilizando fragmentos del pasado; luego, utilizaron 14 mil millones de tokens para el postentrenamiento, invitando a un modelo de profesor "alumno destacado" a evaluar la recuperación de la memoria, utilizando el error para forzarlo a mejorar.
Más allá de la toma de decisiones, también existe la capacidad de almacenarlas. El estado de memoria de MemT utiliza un volumen fijo, y la interacción continua solo actualiza la matriz existente. Para almacenar más detalles dentro de este volumen fijo, el equipo introdujo la arquitectura Mixture-of-Storage (MoS): el MoE base gestiona el cálculo, mientras que MoS permite que múltiples "expertos en memoria" gestionen por separado la asignación de espacio de almacenamiento para lectura y escritura.
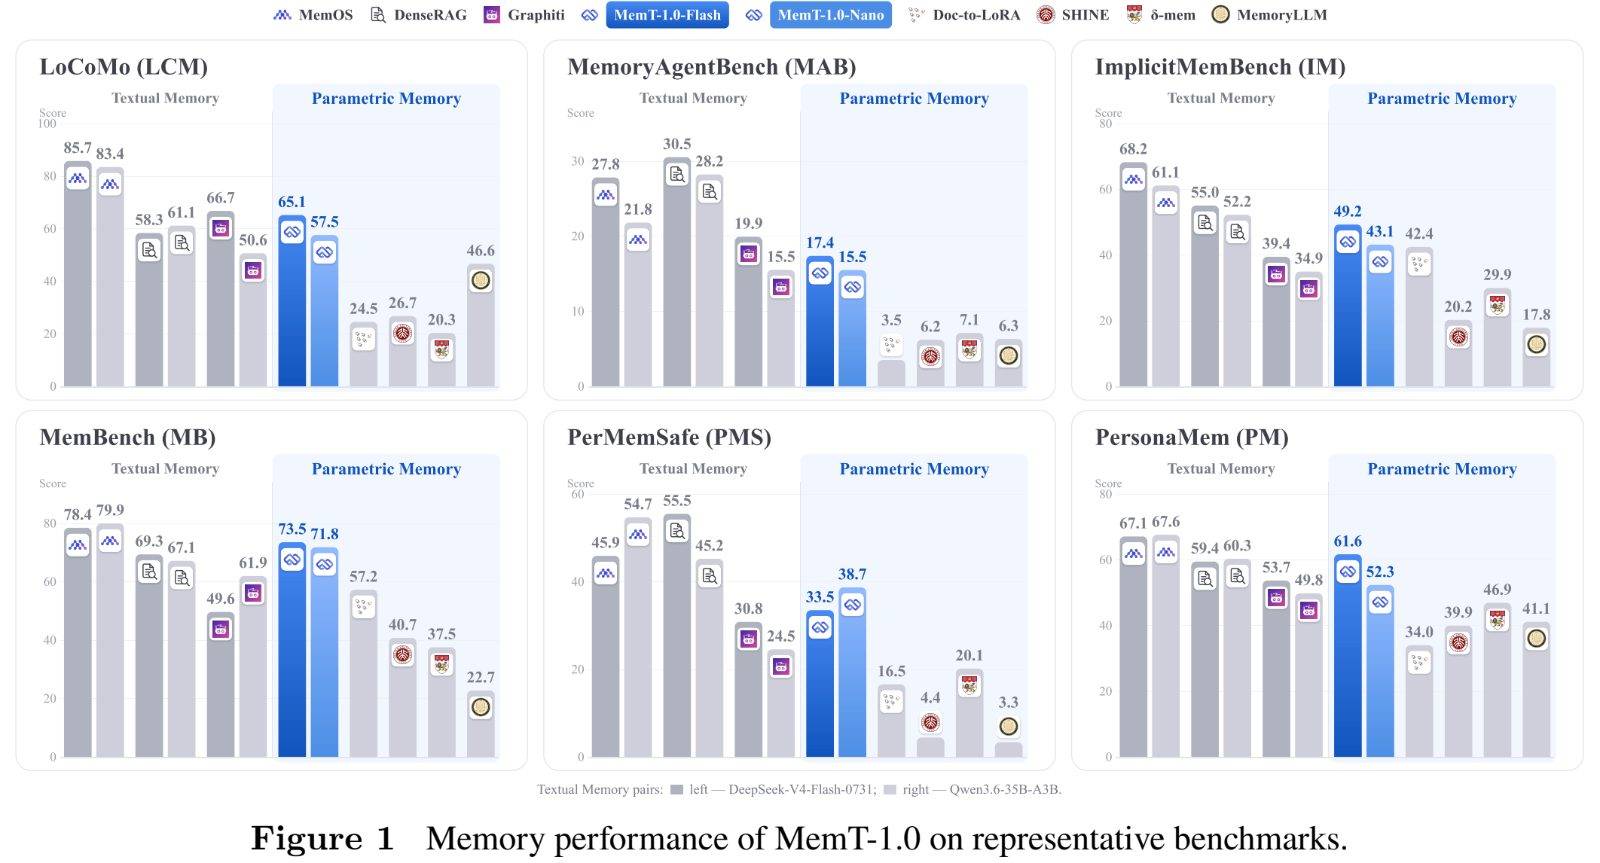
Esta combinación de arquitectura y entrenamiento ha dado resultados impresionantes en 11 pruebas de rendimiento de la memoria del sistema (que abarcan dimensiones como la retención a largo plazo, las actualizaciones dinámicas y la comprensión personalizada, con un período histórico que va desde 16.000 hasta millones de tokens):
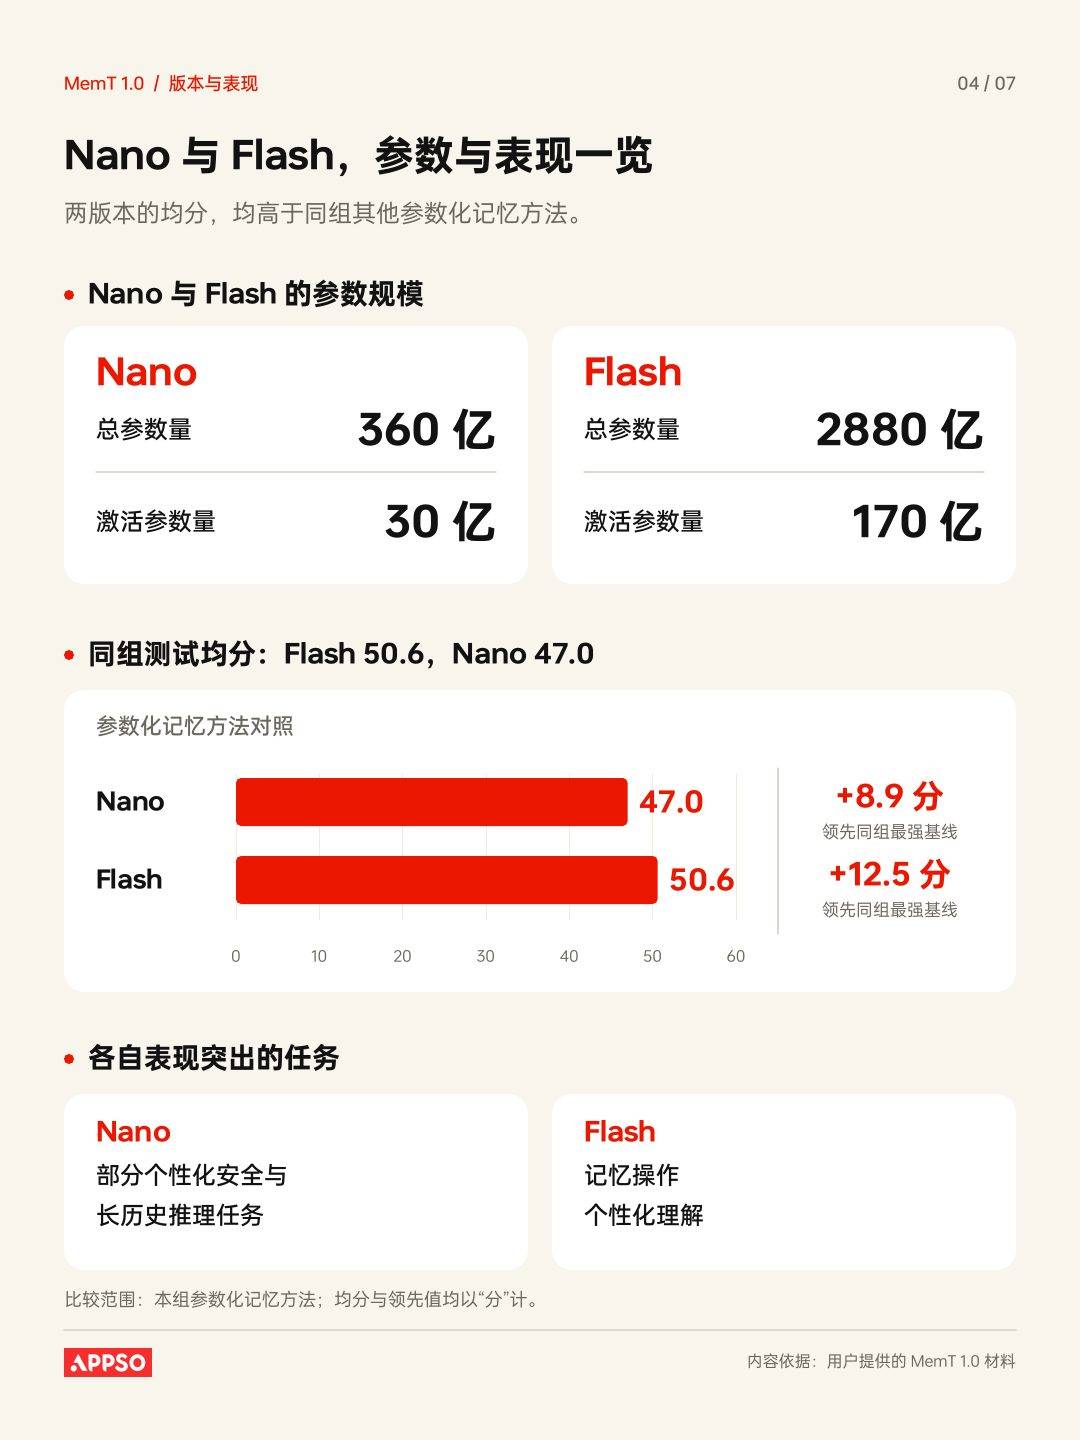
Las pruebas MemT-1.0-Flash y MemT-1.0-Nano, que se realizaron íntegramente a libro cerrado, obtuvieron puntuaciones medias de 50,6 y 47,0 respectivamente, superando a la línea base de memoria paramétrica más sólida de su grupo por 12,5 y 8,9 puntos respectivamente.
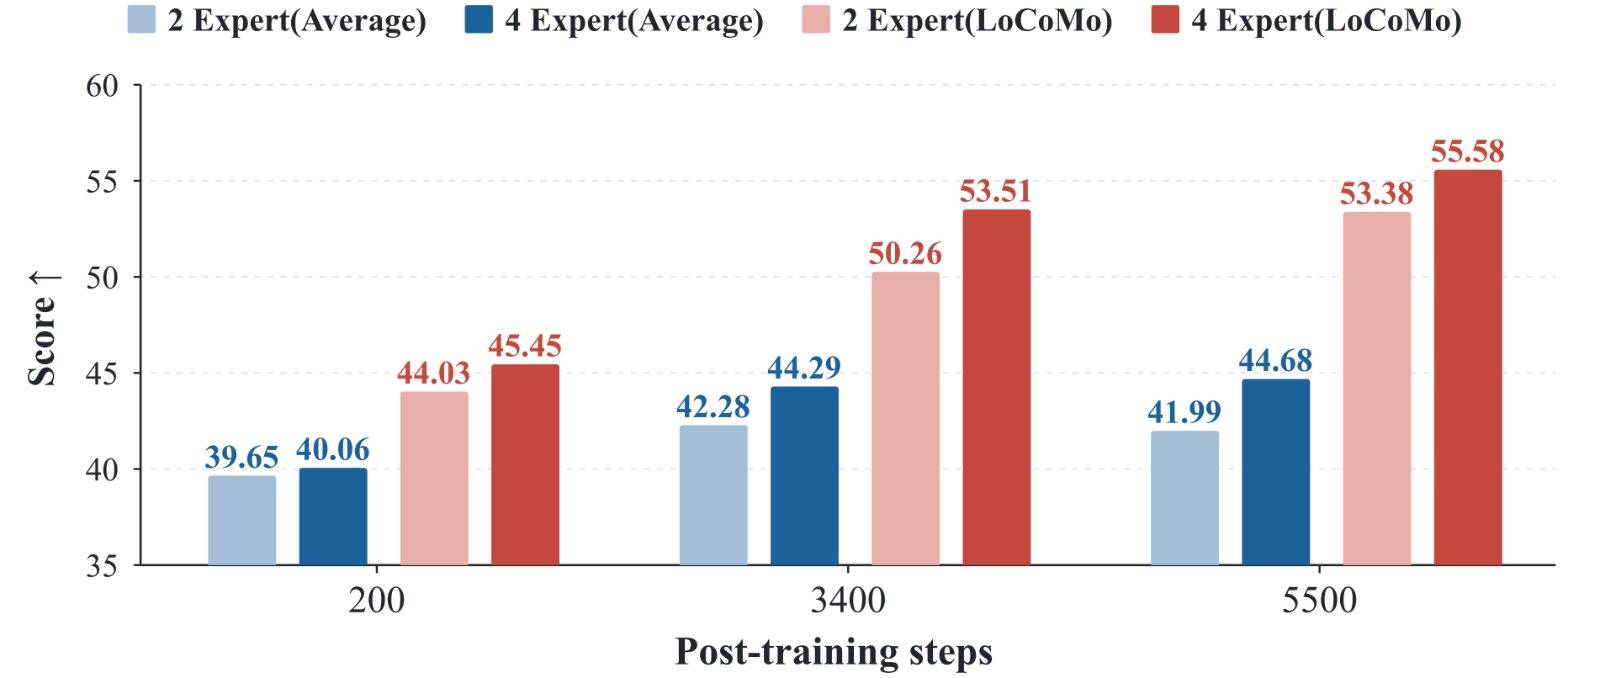
El experimento de ablación también confirmó directamente el valor del entrenamiento y la arquitectura. Si se elimina el paso posterior al entrenamiento, la puntuación promedio del Nano cae directamente de 47,0 a 36,3; al ampliar los expertos en memoria MoS de 2 a 4, la puntuación promedio de la prueba aumenta hasta en 2,7 puntos.
Más allá de las puntuaciones de referencia, dos pequeños detalles de la prueba pueden ilustrar de forma más intuitiva qué constituye una memoria de alta calidad.
En el historial de aproximadamente 16 000 tokens, cuando los usuarios preguntaban por sus cumpleaños, el modelo respondía honestamente "No lo sé", ya que nunca había proporcionado uno, sin inventárselo. En una conversación que involucraba 33 000 tokens, el modelo debía determinar, basándose en reglas establecidas desde hace mucho tiempo, cuál de dos personas era elegible para recibir el kit de herramientas. Verificó con precisión la insignia y el estado de registro, determinando que una persona cumplía con los requisitos y la otra no estaba registrada.
Comprender algo de verdad, recordar las reglas sin pasar por alto los detalles: este es el requisito mínimo para utilizar un asistente de IA.
La autoevolución comienza con un ciclo cerrado de experiencias.
Si elevamos un poco el listón: ¿pueden los errores y las lecciones del pasado realmente cambiar el comportamiento del modelo en nuevas tareas posteriores?
Con el fin de establecer un ciclo continuo de automejora en el que "las tareas generen retroalimentación, perfeccionen y acumulen experiencia, y luego mejoren las tareas subsiguientes", el equipo técnico construyó una cadena completa de capacitación y ejecución en escenarios de programación reales.
El primer paso consiste en enseñarle al modelo a "escuchar" las experiencias de otras personas.
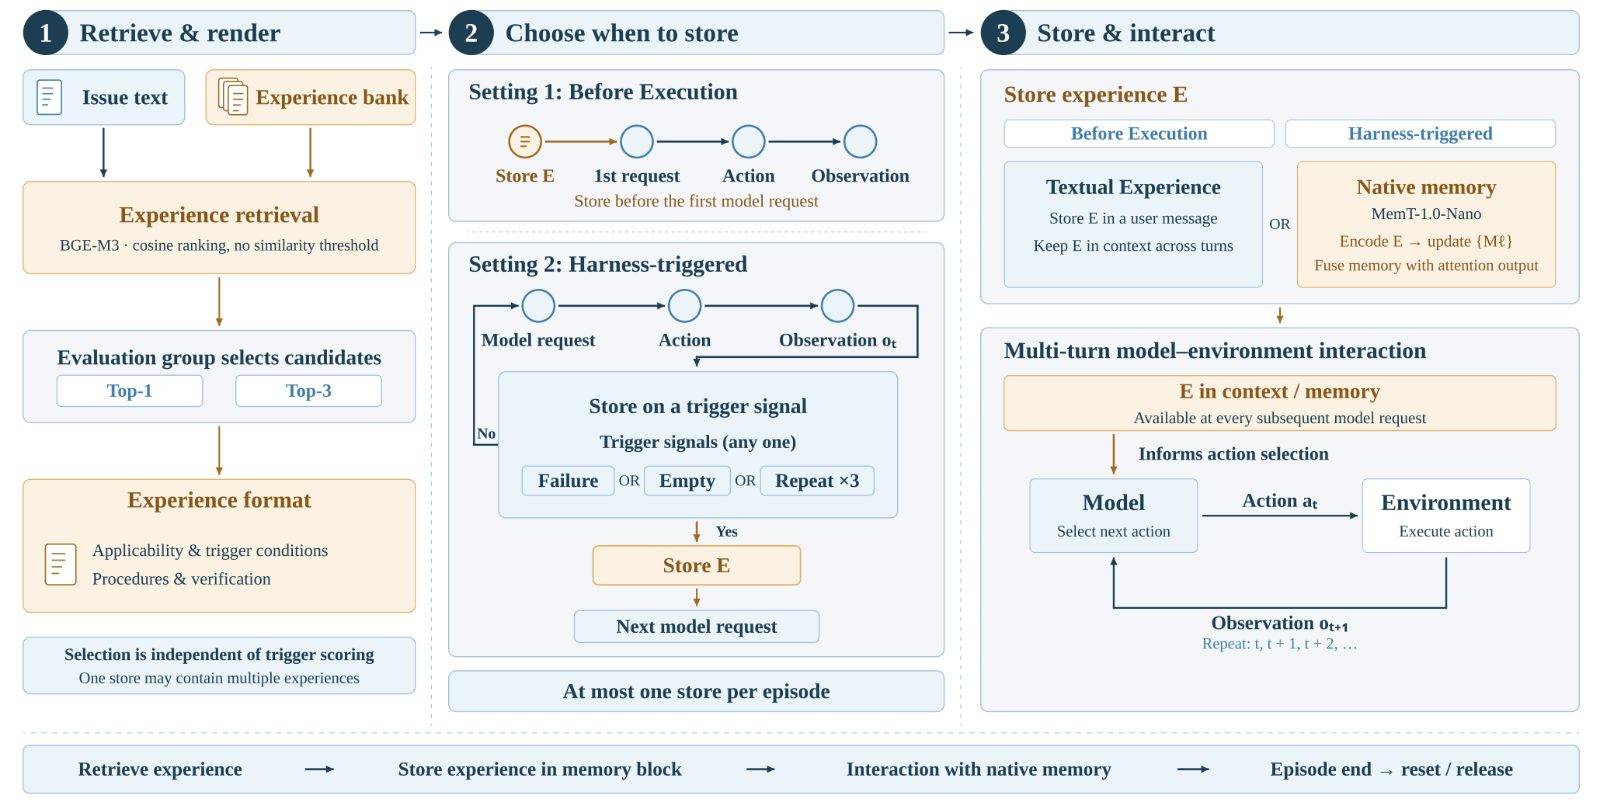
El equipo técnico extrajo primero miles de experiencias reutilizables de decenas de miles de trayectorias exitosas; luego, dejaron que el modelo base ejecutara la tarea. Cuando encontraba un "punto de bloqueo", como un error de comando, un valor de retorno vacío o una operación inválida repetida, inyectaban la experiencia correspondiente en ese punto y volvían a ejecutar el proceso.
El equipo examinó rigurosamente más de 42.000 muestras que "cometían errores cuando no tenían experiencia, pero tenían éxito después de adquirirla" y las utilizó para entrenar el módulo de memoria nativa de MemT-1.0 Nano: primero, la experiencia se escribía en el estado de la memoria interna y, después de superar el cuello de botella, se habilitaba la lectura, de modo que el modelo pudiera aprender a llamar a la experiencia en memoria para corregir acciones posteriores.
En la prueba SWE-bench Verified de 500 tareas, la tasa de éxito promedio de MemT-1.0 Nano con experiencia preescrita aumentó del 66,07 % para aquellos sin experiencia al 69,33 %, y el porcentaje de aquellos que completaron con éxito el mismo problema tres veces de forma independiente aumentó del 54,00 % al 61,60 %, lo que es comparable al grupo de control que insertó directamente la "experiencia textual" en el contexto (tasa de éxito del 68,87 %, tasa de éxito tres veces del 61,60 %).
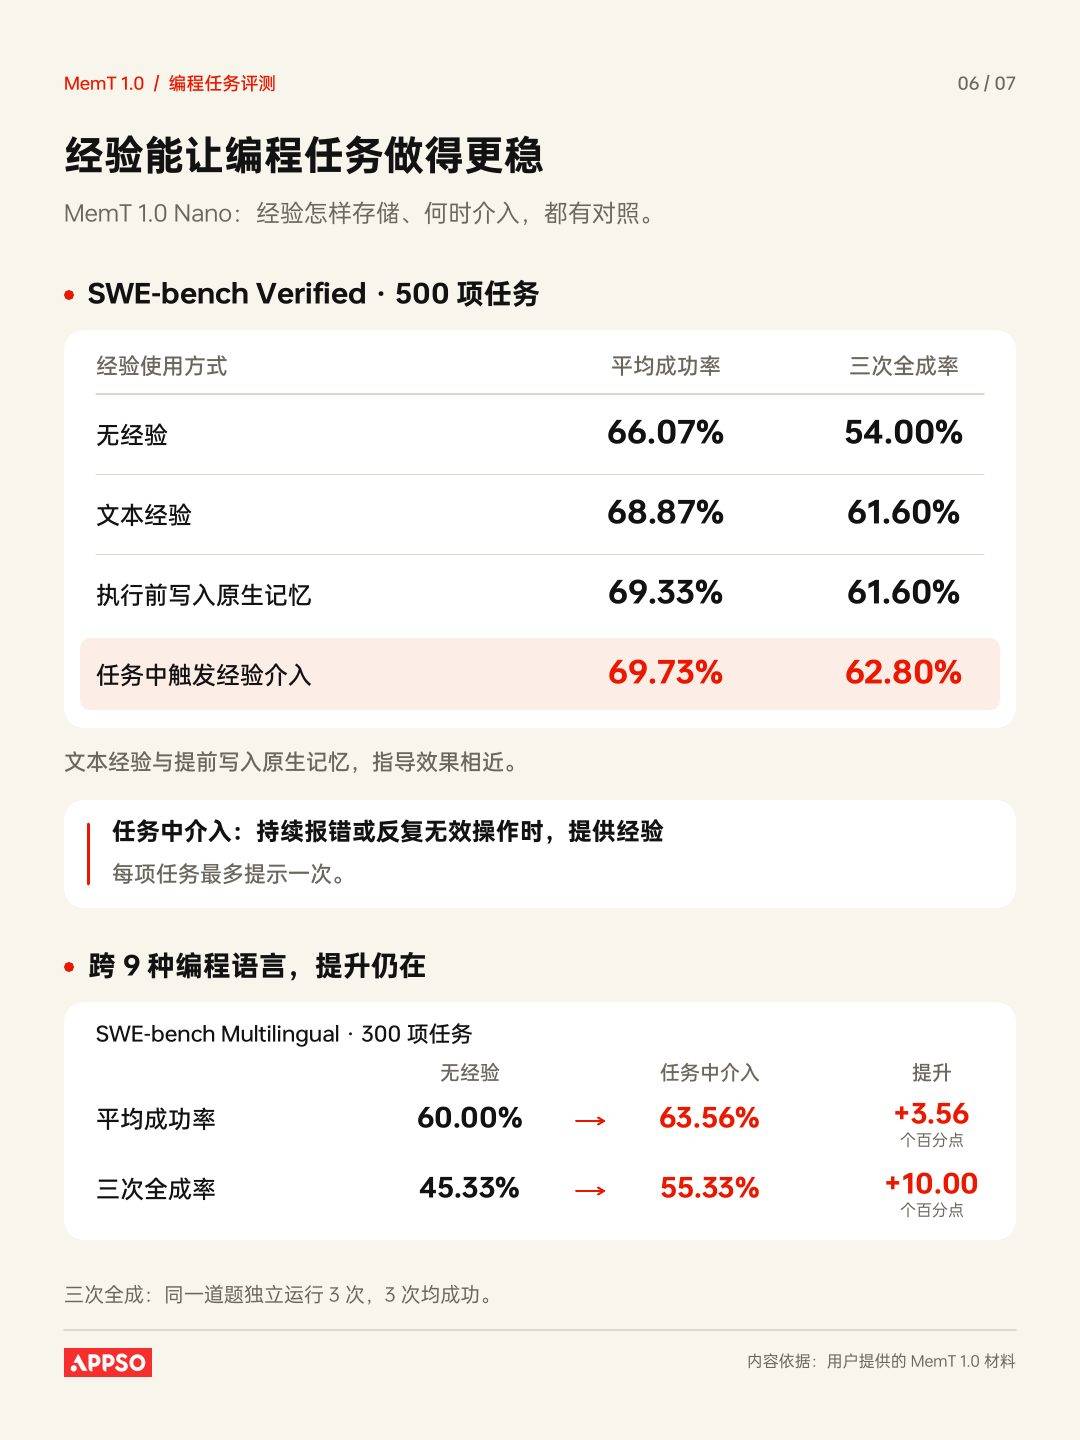
Esto demuestra que, incluso si el cuadro de diálogo está completamente limpio, el modelo puede procesar por completo instrucciones de depuración complejas simplemente basándose en el estado de memoria de su sistema.
El segundo paso consiste en aprender haciendo, en situaciones del mundo real, ampliando así realmente la brecha entre los alumnos.
La experiencia previa a la programación es, en última instancia, estática; ¿cómo predecir el futuro al realizar el trabajo? Por lo tanto, en el modo práctico, el modelo primero resuelve problemas de forma independiente, sin experiencia previa. Solo cuando el sistema detecta un error, no devuelve ningún resultado o se bloquea tres veces seguidas, se almacena en su memoria interna la experiencia de resolución de problemas correspondiente.
Es como si un programador escribiera código y se encontrara con un obstáculo. De repente, recuerda las lecciones aprendidas de errores anteriores y reescribe el código para corregir el error al instante. Una vez finalizado el trabajo, el proceso de cometer errores y corregirlos se habrá perfeccionado, convirtiéndose en una nueva experiencia que podrá utilizarse en el futuro.
Los resultados demostraron que este método de actualización del estado de la memoria basado en retroalimentación en tiempo real aumentó la tasa de éxito promedio al 69,73 % y la tasa de éxito de tres intentos al 62,80 %, superando en ambos casos al grupo de experiencia con texto (69,13 % y 61,80 %).
Al cambiar a SWE-bench Multilingual, que abarca nueve lenguajes de programación e incluye 300 tareas, Nano también activa dinámicamente el mecanismo de memoria nativa en función de la retroalimentación de errores durante la ejecución. La tasa de éxito promedio de Nano aumentó del 60,00 % para usuarios sin experiencia al 63,56 %, y la tasa de éxito en tres intentos pasó del 45,33 % al 55,33 % (también mejor que el 63,00 % y el 53,67 % del grupo experimentado basado en texto).
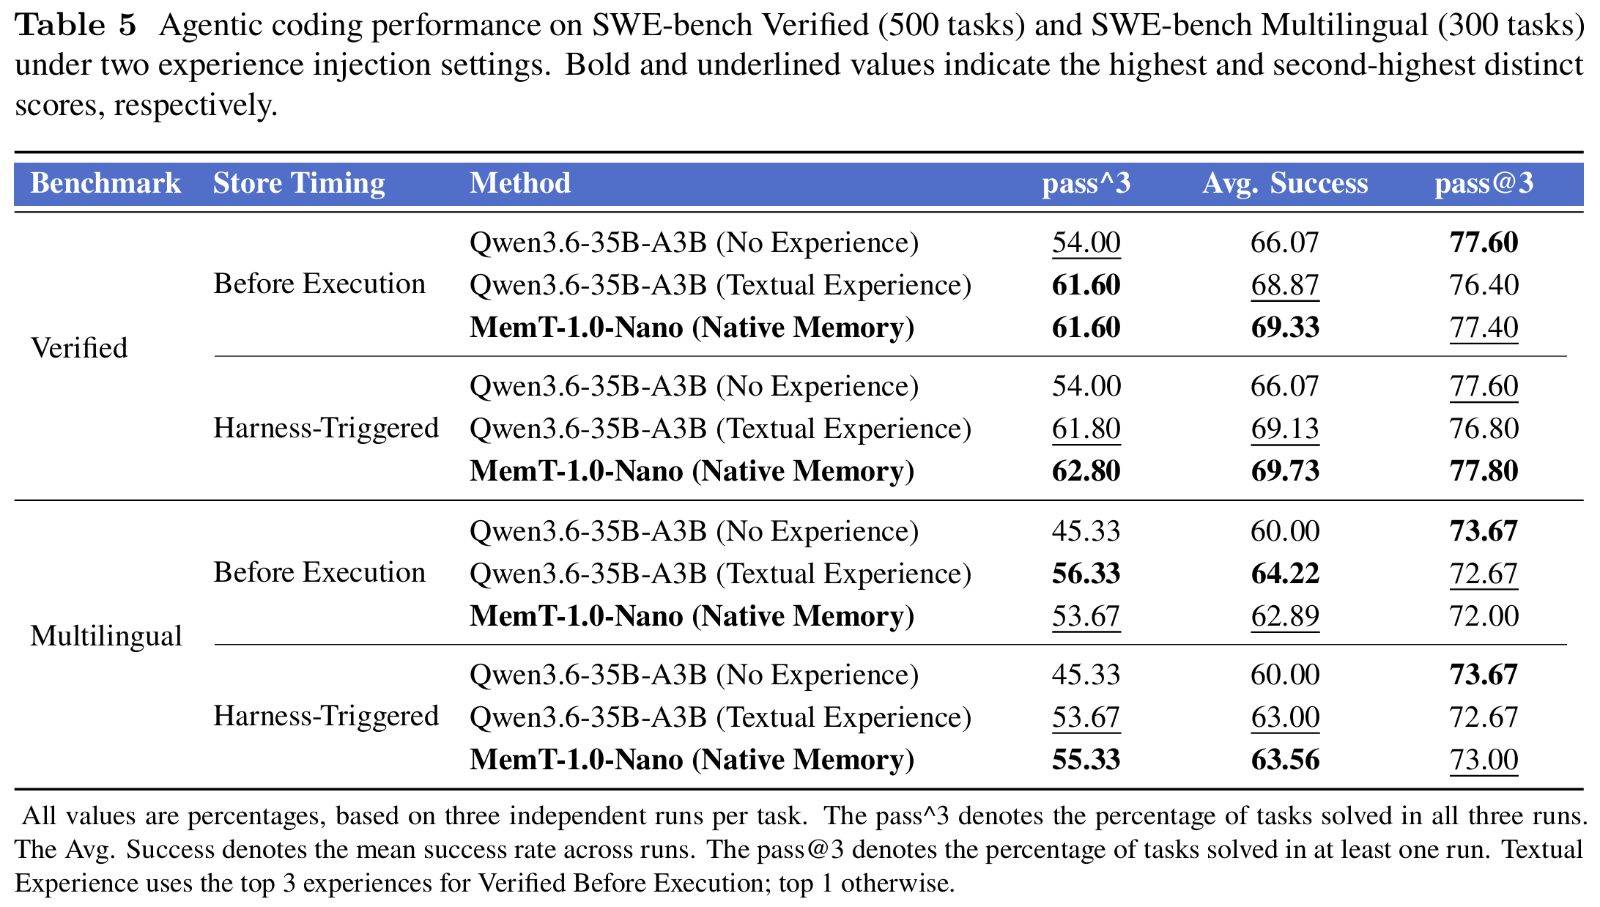
Como se puede observar, el sistema externo se encarga de extraer la experiencia a partir de la retroalimentación del mundo real y de detectar las señales de bloqueo, mientras que el modelo se basa en su memoria entrenada y sus capacidades nativas de lectura/escritura para internalizar la experiencia y corregir sus siguientes acciones. Este mecanismo colaborativo también proporciona al modelo subyacente el soporte necesario para que el agente avance hacia una evolución autónoma y continua.
Desde parches externos hasta memoria nativa, MemT 1.0 ha dominado el arte de fomentar la IA.
Para que este ciclo de aprendizaje práctico siga funcionando en el ámbito empresarial real durante los próximos años, es evidente que el tema de los costes de ingeniería es inevitable.
Para diálogos breves de pocas rondas o menos, ampliar el contexto o usar una base de datos vectorial es suficiente; sin embargo, una vez que comienzan las interacciones prolongadas, las soluciones tradicionales se vuelven cada vez más engorrosas, con una latencia de inferencia y un consumo de memoria de GPU que aumentan continuamente. En contraste, MemT 1.0 tiene un volumen de estado de memoria dinámica fijo, y las interacciones continuas solo actualizan las matrices existentes, lo que prácticamente nivela el costo marginal.
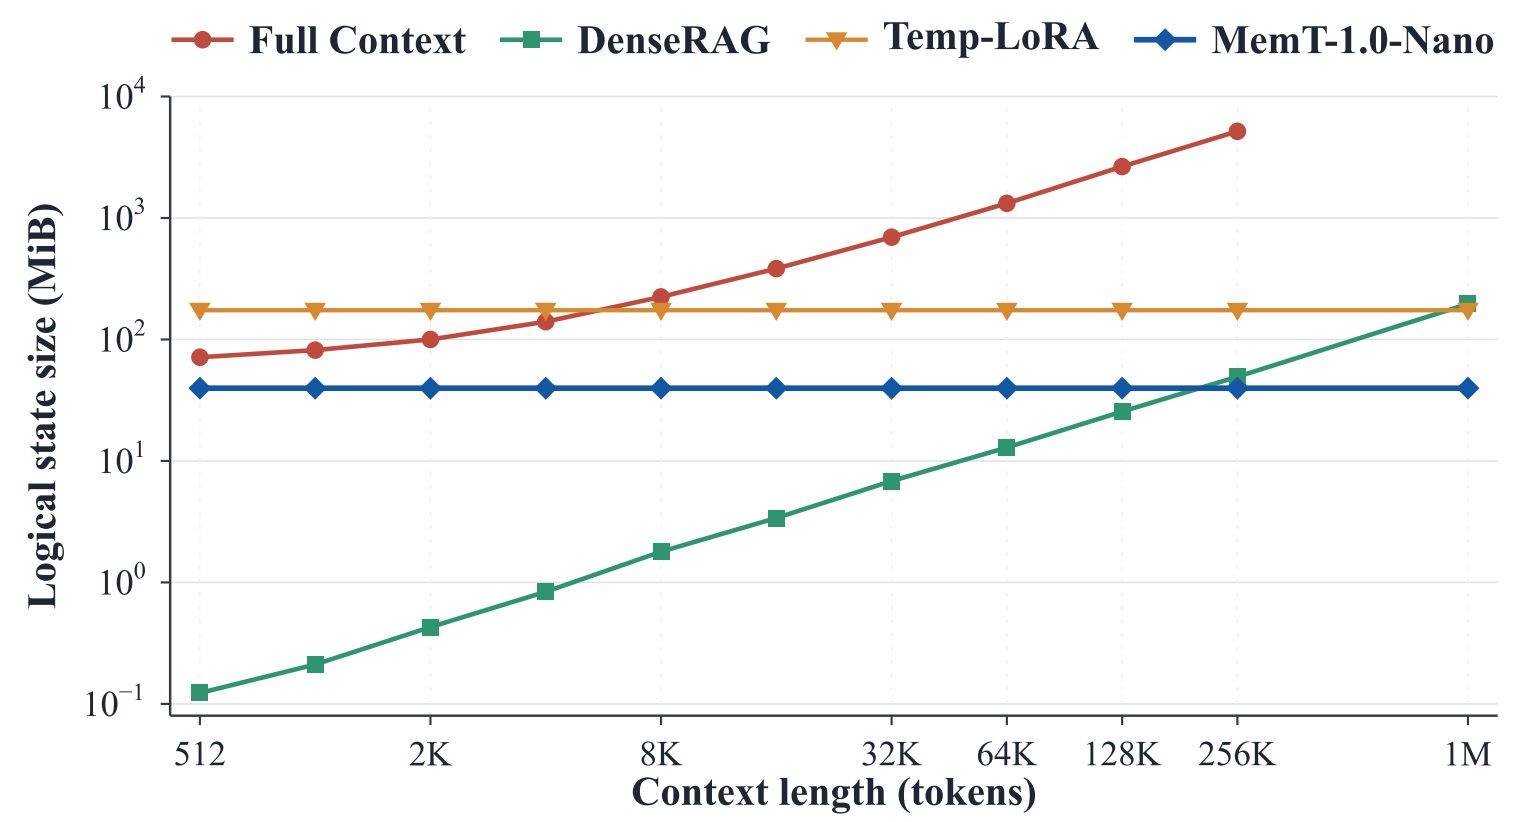
El informe técnico muestra que, en condiciones de prueba con dos GPU, una sola concurrencia y un tamaño de lote de 1, Nano tiene una velocidad de inferencia de extremo a extremo aproximadamente 1,20 veces mayor que la solución de contexto completo al procesar un historial de 64 000 tokens; cuando el historial se incrementa a 128 000 y 256 000 tokens, alcanza aproximadamente 1,86 y 3,99 veces, respectivamente.
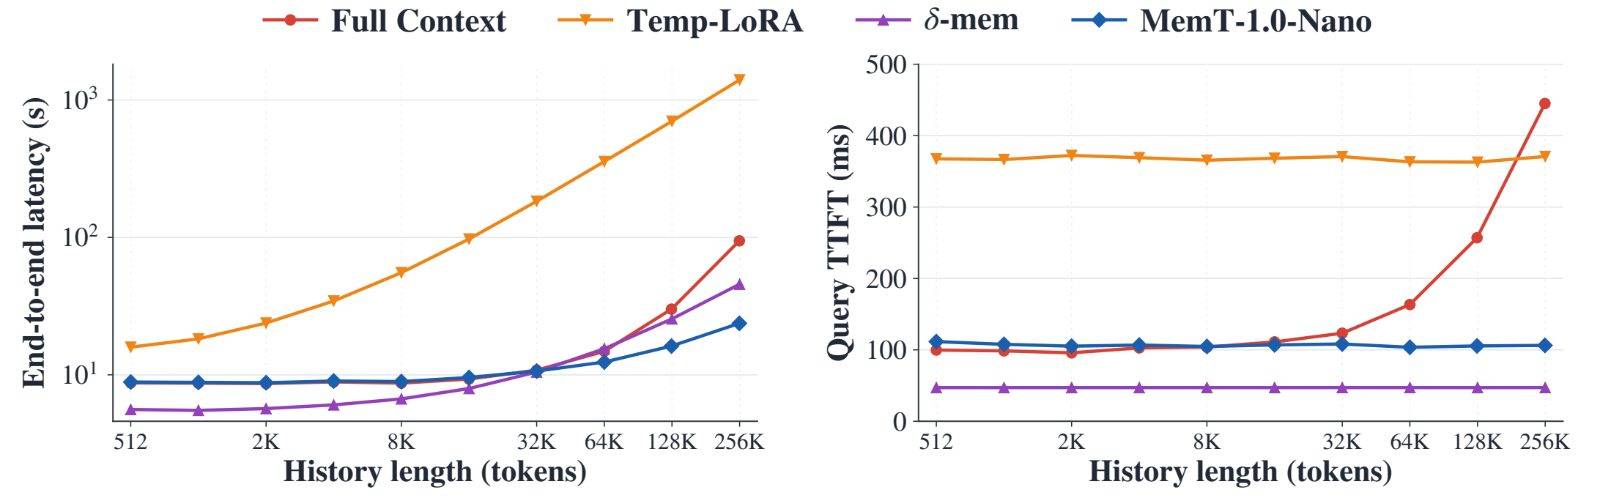
Con una longitud de historial de tokens de 128 KB, el almacenamiento de estado persistente necesario para recuperar un único historial de interacción es aproximadamente una sexagésima sexta parte de la caché KV de contexto completo, sin contar los pesos del modelo compartido.
Al reducir la carga computacional y de almacenamiento de una sola llamada, las operaciones de lectura y escritura de memoria de alta frecuencia y entre ciclos pueden cumplir realmente las condiciones para la implementación de ingeniería a gran escala.
Tomando como ejemplo el escenario interno de I+D de una empresa, en primer lugar resuelve el problema de la reutilización de la experiencia del equipo.
Actualmente, la mayoría de los equipos utilizan IA para escribir código, y el mayor problema es la formación diaria de los nuevos empleados: las especificaciones del proyecto y las rutinas de depuración deben enseñarse de nuevo a los ingenieros cada vez que empiezan una nueva sesión, lo que significa que las empresas pagan continuamente por gastos repetitivos.
Dentro del sistema MemT 1.0, la retroalimentación empresarial del mundo real actualiza continuamente la base de experiencia externa, mientras que el modelo internaliza gradualmente estas normas del equipo hasta convertirlas en intuición. Los miembros experimentados del equipo se preocupan menos, la IA evita los errores comunes y la inversión tecnológica se transforma en activos del equipo con interés compuesto.
Si consideramos aplicaciones a largo plazo, ya sea un avatar digital personal en línea las 24 horas del día, los 7 días de la semana, un consultor médico que realiza un seguimiento mensual del manejo de enfermedades crónicas o un tutor privado personalizado que acompaña el crecimiento de un niño durante varios años, estas aplicaciones futuras que dependen en gran medida de la profundidad del tiempo deben construirse sobre la base de la memoria.
Durante los últimos tres años, la comunidad de modelado a gran escala se ha visto inmersa en diversas métricas horizontales, compitiendo por quién tiene el mayor número de parámetros, las puntuaciones más altas y el mayor dominio en la clasificación. Mantener una posición de liderazgo requiere actualizaciones continuas y el desarrollo de nuevos modelos. Desde la investigación por capas de Memory³ hasta la exploración del sistema de MemOS, y ahora hasta la reestructuración de la arquitectura subyacente de MemT 1.0, los tensores de memoria han entrado en el eje vertical del tiempo:
¿Cómo podemos lograr que el modelo sea más inteligente a medida que los usuarios lo utilicen más?
Lo que resulta aún más sorprendente es que se trata de una IA que fomenta el aprendizaje: cada error que corrijas y cada comentario que le des se actualizará e incorporará a sus capacidades a través de la memoria, lo que la hará siempre más eficiente y comprensiva contigo la próxima vez.
A medida que los modelos acumulan experiencia con el tiempo, la relación entre humanos e IA también cambia. Una plataforma de propósito general con parámetros de fábrica robustos puede ser reemplazada por un modelo más potente en cualquier momento; pero un modelo nativo que ha superado los obstáculos junto con usted y ha comprendido todos sus hábitos de trabajo y reglas de negocio desarrollará sus propias barreras únicas mediante el perfeccionamiento diario.
Este es el futuro por el que realmente estamos dispuestos a pagar en 2026.